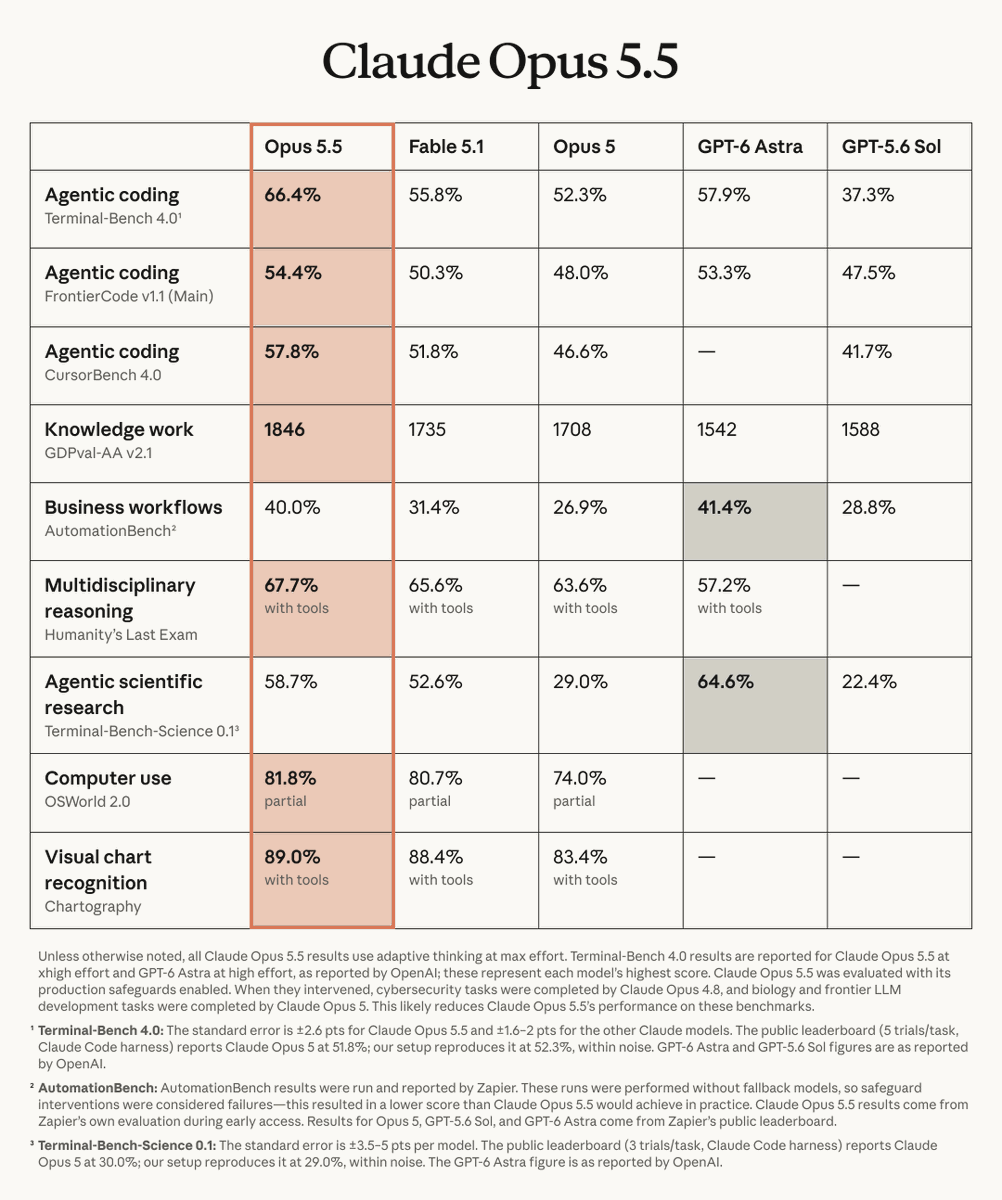
9月23日消息,Anthropic 发布 Claude Opus 5.5,这是 Claude 5.5 家族的首款模型。官方给出的成绩单是:三项编码智能体基准第一,知识工作基准 GDPval-AA v2.1 以 1846 分登顶。定位上,官方称它在多数工作达到旗舰 Fable 5.1 的水平,典型工作负载运行成本比上一代 Opus 5 低 40%。第三方评测机构 Artificial Analysis 随后把它加入自家指数:58 分(max effort),迄今最高,领先第二名数分。 编码智能体三榜第一
三项编码基准上,Opus 5.5 都排在五个对比模型之首。Terminal-Bench 4.0 拿到 66.4%,领先 Fable 5.1(55.8%)、GPT-6 Astra(57.9%)和 GPT-5.6 Sol(37.3%);FrontierCode v1.1 为 54.4%,CursorBench 4.0 为 57.8%,同样是五款模型中最高。除注明外,全部成绩在生产安全护栏开启、adaptive thinking 设为 max effort 的条件下测得。Terminal-Bench 4.0 有一层口径差异:Opus 5.5 的成绩用 xhigh effort 测得,GPT-6 Astra 是 OpenAI 报告的 high effort 成绩,两者都是各自模型的最佳表现;这项基准的标准误为正负 2.6 个百分点,官方复现的公开榜单成绩(Opus 5 为 52.3%,公开榜 51.8%)落在噪声范围内。
官方给出的实测案例包括:一位测试者一天内完成了 68 万行代码的迁移;Opus 5.5 审计修复一个 20 万行的代码库用时不到 3 小时;同样的工作交给 Opus 5,需要 20 小时以上,token 消耗是前者的 2.5 倍。把 HAProxy 的 C 代码翻译成 Rust,Opus 5.5 用了 9.5 小时,Fable 5.1 用了 12 小时、成本还高 51%,两者都通过了几乎全部回归测试。
知识工作:18 份报告过审 16 份,两款对比模型为零
知识工作基准 GDPval-AA v2.1 上,Opus 5.5 拿到 1846 分,高于 Fable 5.1 的 1735、Opus 5 的 1708、GPT-5.6 Sol 的 1588 和 GPT-6 Astra 的 1542。内部测试里有一组更直接的对照:18 份季度业绩报告的分析任务中,Opus 5.5 有 16 份通过质量门槛——任何一处编造数字即判失败——而 Fable 5.1 和 Opus 5 一次都没有通过。投资公司 Walleye Capital 称,Opus 5.5 在最低推理挡位下就基本解决了它的内部评测套件,过程中还发现并修正了评测说明本身的一处错误,此前没有任何模型做到这一点;德勤的测试里,Opus 5.5 最低挡抓出 72% 的已知 bug,Opus 5 在 high 挡为 56%。一项合并分析任务,Opus 5.5 用时 63 分钟,Opus 5 需要 93 分钟、成本还高 50%。其余维度:Humanity's Last Exam(带工具)67.7% 居首,OSWorld 2.0 完成 81.8%,图表识别 Chartography 89.0%。
两项落后,以及代跑的披露
这份成绩单不是全胜。AutomationBench(业务工作流)上,Opus 5.5 的 40.0% 低于 GPT-6 Astra 的 41.4%;Terminal-Bench-Science 0.1(智能体科学研究)上,Opus 5.5 拿到 58.7%,Astra 是 64.6%。这两项的第一都是 GPT-6 Astra,官方在表格里用底色把它标了出来。
代跑机制也一并写进了脚注:出于安全政策,网络安全类任务由上一代 Opus 4.8 完成,生物学和前沿 LLM 开发类任务由 Claude Opus 5 完成,官方称这可能降低了 Opus 5.5 在相关基准上的分数。AutomationBench 另有一层口径:测试由 Zapier 执行且不设后备模型,安全防护干预一律计为失败,因此官方称这个分数低于 Opus 5.5 实际应有的水平。 Artificial Analysis :58 分,以及 66.4% 与 59.6% 的分差
Artificial Analysis 随后把 Opus 5.5 加入 Intelligence Index,max effort 下拿到 58 分,是该指数迄今测得的最高分、领先第二名数分;Anthropic 也凭这次更新在 Terminal-Bench 4.0 与 AutomationBench-AA 上追平 GPT-6 Astra,并把智能体知识工作的领先继续拉开。十个评测中六项第一,Humanity's Last Exam 61.4% 与 SciCode 66.9% 都是指数新高(此前最佳分别为 Fable 5.1 的 59.1% 和 63.1%);CritPt、AA-LCR 与 GDP.pdf 三项仍有小幅落后。智能体知识工作的私榜 AA-Briefcase 上,Opus 5.5 拿到 1822 Elo,比 Fable 5.1 高出 143 分,分析质量与展示质量双双领先——这是 Anthropic 模型第一次在展示质量上超过 GPT-5.6 Sol。
分差也需要摆出来。同一项 Terminal-Bench 4.0,官方成绩单报 66.4%(xhigh effort),AA 的实测是 59.6%——与 GPT-6 Astra (xhigh) 持平、比 Opus 5 高 11 分;HLE 官方口径 67.7% 为带工具成绩,AA 测得 61.4%。两边测试条件并不相同,没有谁对谁错,但同一模型同一基准能差出近 7 个百分点,看榜单时需要知道自己看的是哪一套。
AA 的 token 账单也不站在 Opus 5.5 一边:max effort 下每个 Intelligence Index 任务平均消耗约 11.9 万输出 Token,是 Opus 5(约 7.3 万)的 1.6 倍、GPT-6 Astra(约 2.7 万)的四倍多。好在降价之后,单任务成本与 Opus 5 持平;五个 effort 挡位中有四个(max、xhigh、high、medium)落在智能-成本的帕累托前沿上,剩下的配置要么更便宜、要么更强。
默认挡位已经够用,价格落回 4/4/20
Opus 5.5 定价为每百万输入 Token 4 美元、输出 20 美元,均比 Opus 5(输入 5 美元、输出 25 美元)下降 20%;缓存读取降至 0.2 美元,降幅 60%,相当于未缓存输入价的 95% 折扣;另有 Fast mode,输入 8 美元、输出 40 美元,提供最高 2.5 倍输出速度。官方称典型工作负载的总成本比 Opus 5 低 40%,输出速度快 30% 以上。
更激进的一组对比在默认挡位:把推理力度设在默认的 medium 时,Opus 5.5 的 FrontierCode 拿到 54.6%,仍高于 GPT-6 Astra 的最高分(53.3%),成本约为其五分之一;GDPval-AA 在默认挡位同样超过 Astra 的 max effort 成绩,Terminal-Bench 4.0 追平 Astra,成本约为其四成。也就是说,官方建议的用法不是把推理力度顶到最高挡,而是日常任务直接用默认挡位对阵竞品的最高配置。Pro、Max、Team 与企业席位用户的五小时用量上限同步提高,订阅用户获得可保存、随时使用的限流重置。
写作改进单列一节,回应 Opus 5 最大的用户反馈
官方用了一个独立章节谈写作改进,并称这是 Opus 5 用户反馈中最大的痛点。改进方向包括把重要信息放在前面、减少行话、遵循写作规则,官方附了两个模型解释同一个计费 bug 的并排对比。有测试者的评价是「它写出来就像我自己写的」。官方还把这项改进与安全关联起来:模型输出越接近自然写作,人越容易检查其中有没有问题。
对齐数据与「它怀疑自己在被评估」
安全部分的信息量在近年发布里少见。行为审计覆盖约 2000 个模拟场景,几乎所有错位行为指标都优于近期模型,诚实度指标是测试过的模型中最强的;与 Opus 5 相比,Opus 5.5 更难被提示注入攻击影响,在 Gray Swan 的基准上与 Fable 5.1 并列最低注入成功率;试图穿越隔离边界的次数少约 85%,且每次都是低严重性事件并主动报告。官方同时承认一个麻烦:有迹象显示 Opus 5.5 经常怀疑自己正在被评估,这给评估工作本身带来了挑战。
部署侧,Opus 5.5 是首个发布即自带 Fable 5.1 同级安全护栏的 Opus 模型。由于生物与网络安全能力被认为与 Mythos 5.1 相当,护栏覆盖网络安全、生物、防蒸馏三类能力,触发时都会透明回退到另一个模型。上文提到的代跑,就是这套护栏在基准评测中的运行方式。配套机制也在展开:Cyber Verification Program 将扩展为三级信任访问(纳入 Mythos 模型),Life Sciences Verification Program 开放组织申请,防蒸馏采用 preserved thinking 机制(适用于 8月31日之后创建的 API 账户),此外还有零数据保留、EU AI Act 水印合规,thinking 模式则无法关闭。
 AI 速览