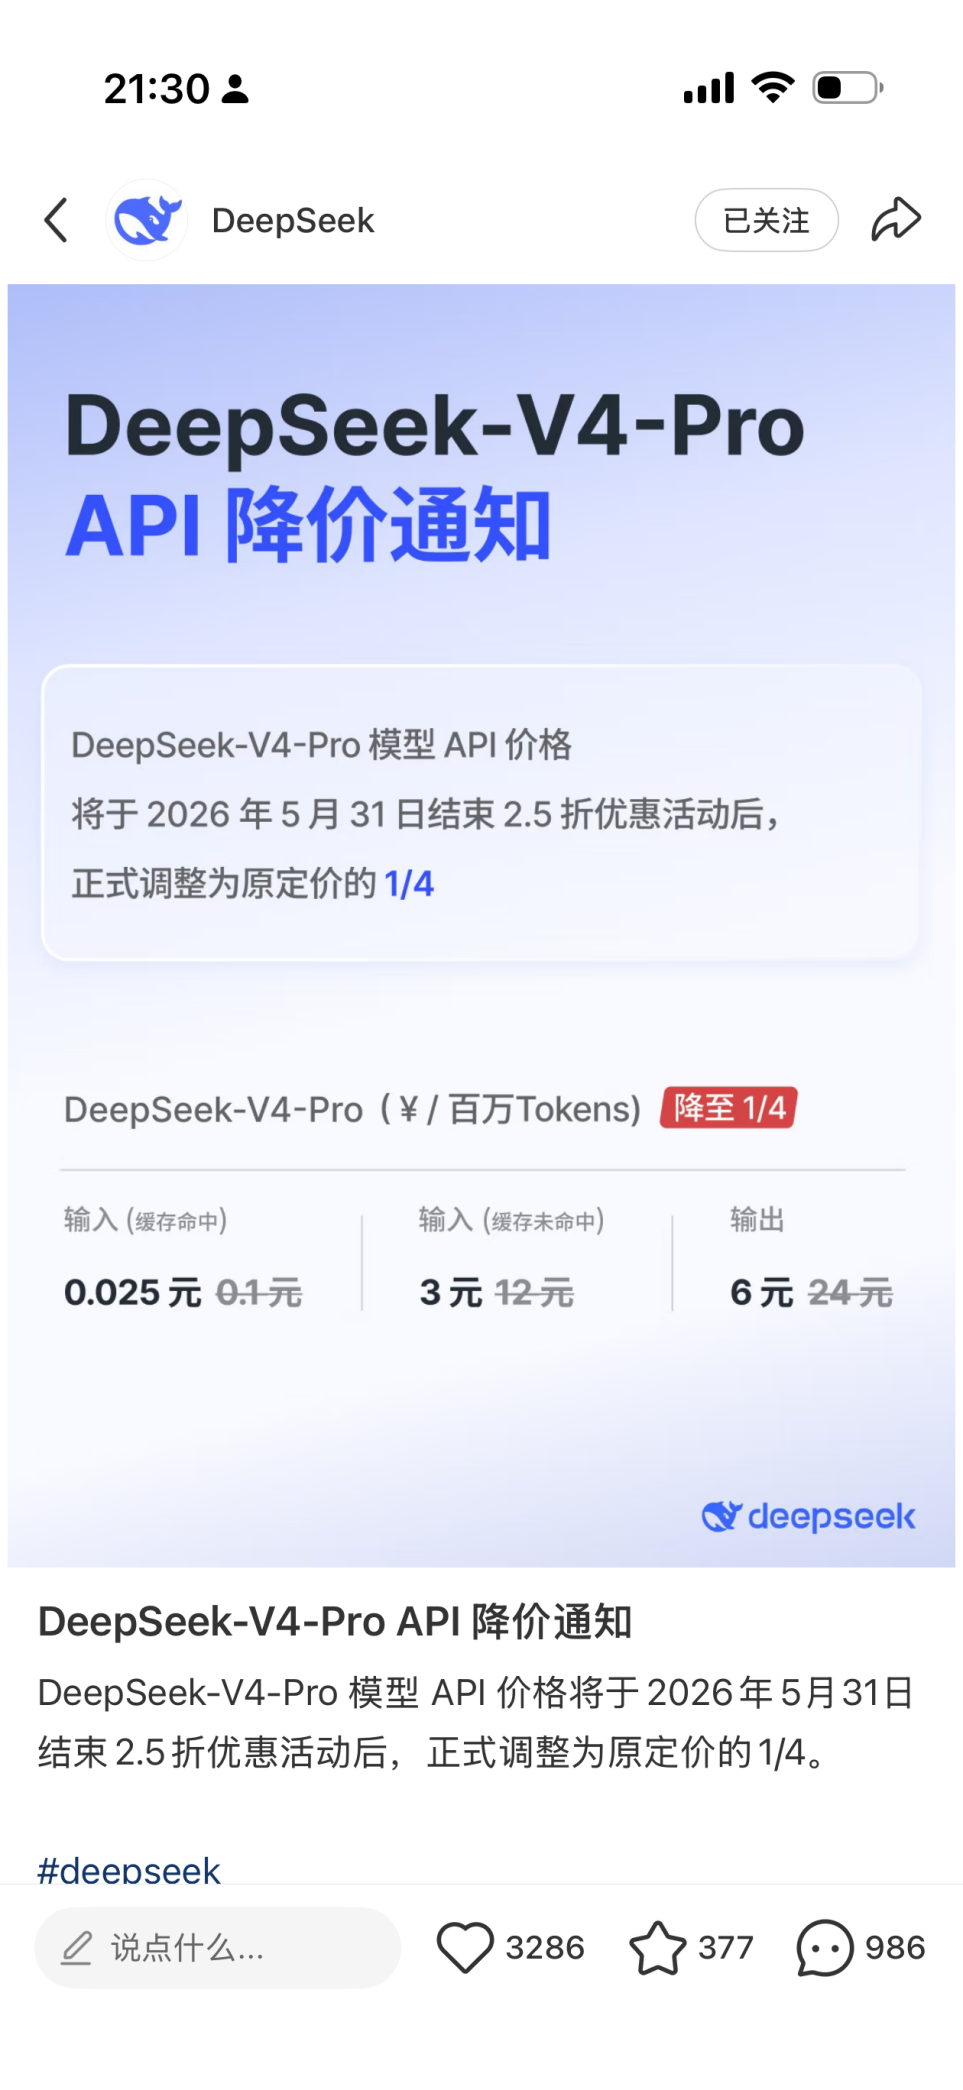
DeepSeek 在 2025 年 2 月确实下调了 API 价格,但降价只落在夜间错峰时段,标准价本身没有动。下面把降价幅度、现在的官方价格、缓存价,以及怎么用最省一笔,一次说清楚。 这次降价发生在哪一天
2025 年 2 月 26 日,DeepSeek 开放平台在官微发布「错峰优惠」通知:北京时间每天 00:30 到 08:30 划为夜间空闲时段,API 调用价格大幅下调。这不是会员折扣,而是鼓励用户在低谷期调用,帮平台平衡负载。标准时段(08:30 到次日 00:30)的价格维持原样。所以这次「降价」是限时错峰价,不等于全天普降。
把时间线拉长是这样:DeepSeek 自 2024 年就以低价出圈,V2 时代就把输入价压到行业低位;到 2025 年初,服务器频繁被挤爆,平台一边暂停充值、一边用错峰价疏导夜间闲置算力。错峰优惠长期挂在开放平台,不是一次性活动,只是只在指定窗口生效。发布当天正好赶上 DeepSeek 的开源周,平台连发多个推理优化代码库,和降价配合着降低使用门槛。错峰窗口占全天三分之一,对实时业务帮助有限,更适合批处理、定时任务。当时平台资源紧张,白天高峰排队严重,夜间算力反而空着,错峰价本质是把闲置算力低价卖掉,对平台和开发者双赢。
从定价史看,DeepSeek 在 2024 年就把早期模型的输入价压到每百万 tokens 1 元、同年 8 月又砍到 0.1 元,低价一直是它的招牌,这次错峰只是把低价延伸到夜间闲置时段。
夜间错峰到底降了多少
降幅按模型区分。deepseek-chat(对应 V3)在错峰时段降到标准价的 5 折,deepseek-reasoner(对应 R1)降到标准价的 2.5 折,也就是比原价便宜 75%。推理模型 R1 在夜间的价格,几乎是全天的低点。很多人看到「降价 75%」的标题就以为全天都便宜了,但只有那 8 小时窗口。
以缓存命中口径计:V3 输入从每百万 tokens 0.5 元降到 0.25 元,输出从 8 元降到 4 元;R1 输入从 1 元降到 0.5 元,输出从 16 元降到 8 元。这个幅度也是 2025 年国内大模型集体降价潮的触发点之一,字节、阿里、腾讯随后都跟进了各自的降价。R1 便宜 75% 是因为它原本输出价高(16 元),降幅绝对值比 V3 更大,重推理任务受益最明显。对用量大的开发者,夜间跑批处理的成本直接砍掉一大截。R1 在夜间打到 2.5 折后,重推理批处理的价格优势最突出,适合代码审查、长文总结这类能吃算力的活。
现在的官方API价格是多少
下面这张表把标准价和错峰价放一起看,单位是人民币每百万 tokens,来自 DeepSeek 开放平台价格页。表里的输入价都是「缓存命中」价,也就是你发了重复前缀时的便宜价;缓存未命中的输入要比表上贵约 4 倍,后一节会展开。表里只列了主力两款,开放平台还有更轻量的小模型,价格更低但能力弱一档,按场景挑。计费单位是 token,中文里一个字大约对应一到两个 token,所以「每百万 tokens」看着吓人,实际日常调用的单次费用很低。比如一次几百字的中文问答,往往只消耗几千 token,按当前价算不到一分钱。
美元接口(国际版)折算后大致是 V3 输入 0.27 美元、输出 1.10 美元每百万 tokens,和国际站点报价一致。横向看,V3 的输出价只有同档闭源大模型(例如 GPT-4o 约 10 美元每百万 tokens 输出)的不到九分之一,这也是 DeepSeek 价格能打的原因。需要提醒的是,这张表是撰写时的快照,实际以开放平台实时页面为准。如果主要调 V3 做常规生成,标准价已经够低,错峰更多是锦上添花;重推理的 R1 用户,错峰才是大头节省。
缓存命中还能再省一笔
DeepSeek 按「缓存命中」和「缓存未命中」两套价计费。缓存命中指你发的前缀和之前请求重复,平台不用重算,于是便宜很多。V3 标准时段缓存未命中输入约 2 元每百万 tokens,缓存命中只有 0.5 元;R1 缓存未命中约 4 元,缓存命中 1 元。输出价不分缓存,始终按上表计。
举一个例子算笔账:假设每轮请求 2000 tokens 输入、500 tokens 输出,一个月跑 1000 轮。走缓存命中,输入按 0.5 元计,1000 轮共约 1 元输入费;若每次前缀都变、全按未命中 2 元计,输入费涨到约 4 元,差出 4 倍。想吃缓存价,核心是让可复用的前缀(系统提示、长文档)保持稳定,别每轮都改。缓存有最短命中时间窗,间隔太久的前缀平台可能清掉,超长任务分段时也要注意。缓存命中的隐藏好处是相同前缀回答更稳定,适合把固定规则、人设写进系统提示的高频场景。反过来,如果每轮都换用户问题但系统提示不变,系统提示那段始终命中,省下的就是大头。平台的用量面板会显示命中比例,命中率低就回头检查前缀是不是每轮都变了。
怎么调用才最省钱
省钱不是靠某一个技巧,而是把几件事叠起来。下面这张表列出五个可操作的动作,按能省多少排了个序,越靠前越该先试。
这几条叠加起来,同样的工作量成本可以压到标准价的几分之一。夜间时段加缓存命中是两个主开关;按活选型是不花冤枉钱的基础,R1 比 V3 贵一倍输出价,能 V3 解决的就别上 R1。小团队先把前两条跑通,账单就能明显下来。如果你跑的是实时对话,非要白天用,那错峰帮不上,只能靠缓存和选型压价。实操里最容易忽略的是第二条,很多团队每轮都拼新上下文,缓存价始终吃不到,等于白白多付几倍输入费。合并请求也别硬凑,只把真正同批次、可共享前缀的内容合在一起,否则反而打乱缓存。夜间调度可以用系统的定时任务或云函数,把非紧急活固定丢到 00:30 之后跑。
为什么它的价格压得这么低
DeepSeek 走开源路线,V3 和 R1 的权重公开、可以自托管,不靠模型授权收费,而是靠 API 规模化摊薄算力。混合专家(MoE)架构让每次推理只激活一部分参数,单 token 成本天然低于稠密大模型。平台还主动补贴 API,价格长期处在行业低位。
下面这张表把 DeepSeek 和同档闭源模型放在输出价上比一比,单位都是美元每百万 tokens,方便看差距。
对比闭源大模型,同质量下 DeepSeek 的 API 单价低出一个数量级。以 V3 输出价为例,每百万 tokens 约 1.10 美元,而 GPT-4o 约 10 美元,差出接近九倍,基准分数却接近。对开发者来说,同样的预算能跑更多 token;对企业来说,把一部分非敏感工作迁过来,账单降幅一目了然。这也是它能掀起降价潮的底气。开源权重能自托管,适合数据不能出内网的团队,但运维和显卡是另一笔账。价格低不等于处处好用:高峰期偶有波动,关键业务加一层重试和备用模型更稳。MoE 架构虽然省算力,但小参数激活也意味着极端任务上不如全参数稠密模型稳,选型时按任务难度分档最划算。开源权重还允许在自己数据上微调,能力不够时自己加训,比反复调用贵模型更省。
免费版和API降价是两回事
很多人把两件事混在一起:DeepSeek 网页版和 App 的基础对话长期免费,那和 API 错峰降价不是一回事。免费对话是给普通用户用的,API 是按量计费给开发者和企业用的。错峰降价只影响 API 账单,不会让免费聊天变得更便宜或更贵。
所以如果你只是自己聊着用,降价和你没关系;如果你是调接口跑业务,降价的实惠要排到夜间、走缓存才能拿到。先分清自己属于哪一边,再看下面的风险提示,避免冲着「降价」去注册却发现白天根本没便宜。理清边界后,普通用户继续免费聊,开发者按需排夜间,两边各取所需,别被「降价」标题带偏节奏。开发者一侧,把错峰和缓存写进调用脚本,比手动盯着时间更省心。错峰和缓存写进脚本后,日常基本不用再管价格。
降价省钱的风险提示
- 错峰降价只在 00:30 到 08:30 生效,白天仍是标准价。
- 标准价本身没降,别把「错峰优惠」理解成「永久全降」。
- 缓存命中价要复用前缀,频繁改写提示会退回未命中高价。
- 正规入口只有开放平台和官方 API,认准这两处,别点第三方链接。
- 代充、拼车账号可能凭证泄露,订阅说没就没,还违反使用条款。
- 价格以开放平台实时页面为准,本文报价是撰写时快照。
 AI 速览