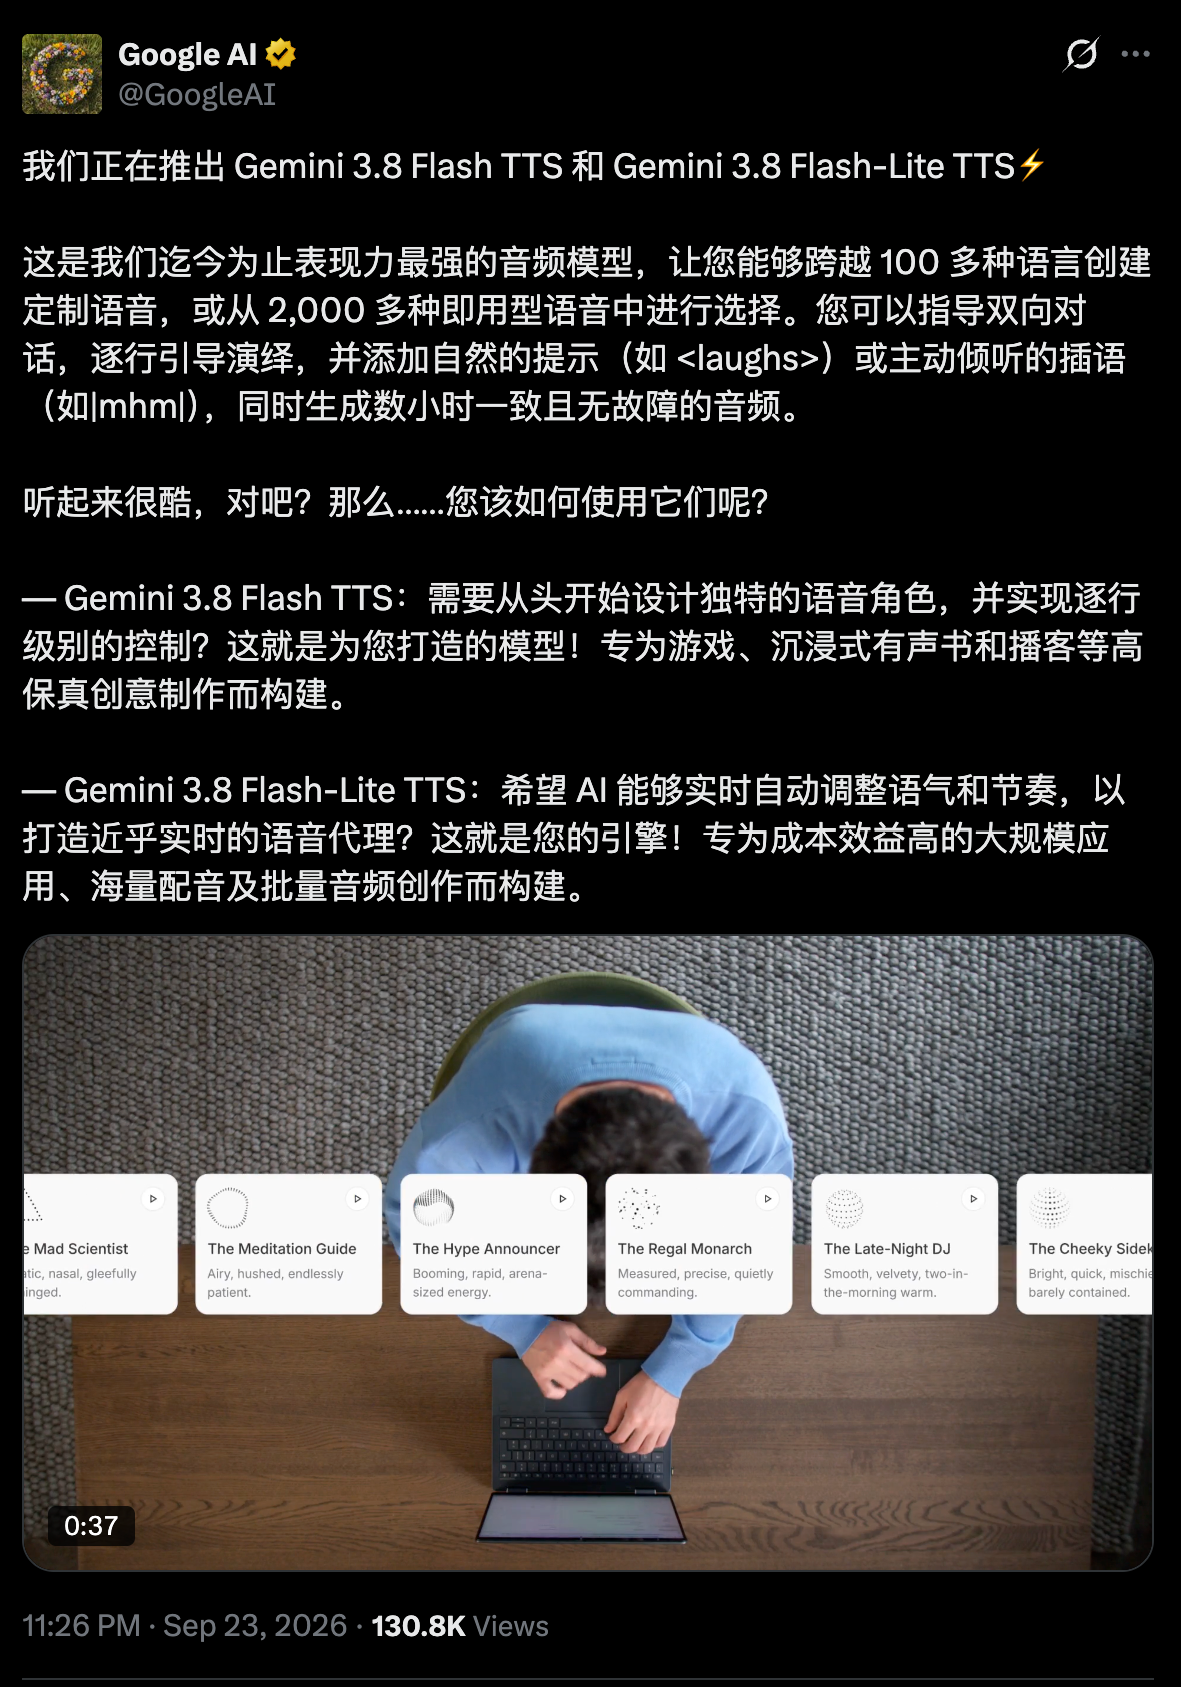
9月24日消息,Google 发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS 两款文本转语音模型。官方称这是迄今表现力最强的音频生成模型,即日上线 Gemini API 和 Google AI Studio。 Flash 管创作,Flash-Lite 管量产
据官方博客介绍,Flash TTS 面向深度创作,用户可以用自然语言从零设计新声音,覆盖 100 多种语言和方言。表演可以逐行执导,语气、节奏和方言切换都能写进脚本。它还支持从单一剧本编排双说话人对话,两个声音清晰分离,话轮自然交替。数小时的连续音频中,音色基本保持稳定。
Flash-Lite TTS 面向大批量场景,定位大规模配音和实时语音代理,主打成本效率。官方博客称,这次发布要"把语音生成从静态预设变成动态的创作工作室"。
笑声和附和也能写进剧本
两款模型都支持把非语言声音写进文本,比如笑声、叹气、倒吸气的标记,以及 mhm、yeah 这类倾听附和语,用来控制接话和反应节奏。在这两款模型里,配音的第一步从在声音库里挑选接近的音色,变成直接用文字描述想要的声音和表演。
官方称,声音库提供 2000 多个可直接使用的语音,一段 30 秒的声音样本即可复刻音色,前提是使用者拥有该声音的使用权利。复刻前,声音所有者要录制同意声明并通过验证,生成内容带 SynthID 水印和 C2PA 凭证。AI Studio 的声音复刻功能在伊利诺伊州、得克萨斯州、欧洲经济区、英国、瑞士和印度不可用。官方文档显示,Flash TTS 支持 130 种语言,Flash-Lite TTS 支持 101 种。
Hume 基准给了前两名
Google 在官方博客中援引第三方机构 Hume AI 的基准称,Flash TTS 在语音设计基准上排名第一,得分 71.4。口音建模也以 60.8 分领先,两款模型在综合质量指数上分列前两名。在 Voice Arena 的盲听偏好测试中,两款模型在日语、印地语等多种语言中排名靠前。
企业版稍后开放,定价已经公布
普通用户侧,Flash TTS 即日进入 Gemini Notebook,Flash-Lite TTS 进入 Google Vids。企业版 Gemini Enterprise 的 API 接入尚未开放,官方标注为即将推出。Agora、LiveKit、Pipecat 和 Vercel 等开发者平台已可接入,Figma、HeyGen 等公司正在集成。 Gemini API 定价页显示,Flash TTS 音频输出每百万 token 9 美元,Flash-Lite TTS 为 6 美元。两档价格都将从明年 1 月 1 日起翻倍。
 AI 速览