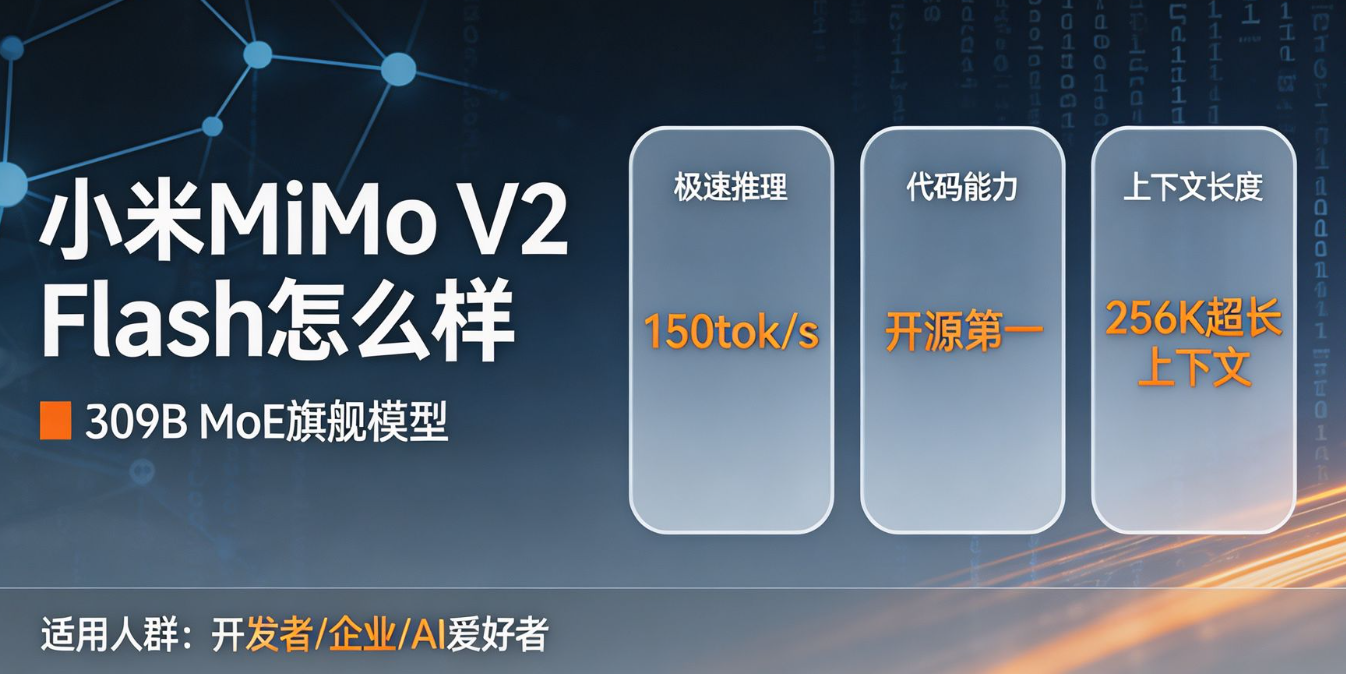
小米mimo v2 flash怎么样?小米 2025 年底开源的 MoE 模型,总参 309B、激活 15B,主打高推理效率与代码能力,MIT 协议可自托管。下面从参数到部署讲清。
小米mimo v2 flash是什么
小米mimo v2 flash 是小米 MiMo 系列里的一代旗舰开源模型,2025 年 12 月 16 日正式发布。它不是一个聊天机器人,而是一套“推理优先”的基础模型,专门冲着复杂推理、写代码、长文本理解和工具调用这几个硬活去的,目标是从“回答问题”走向“完成任务”。
整条 MiMo 系列都走 MIT 开源路线,权重和推理代码全开放,鼓励开发者拿去做端侧部署,往人车家生态里塞。mimo v2 flash 是其中的 MoE 版本,用稀疏激活把推理成本和速度压到很低,所以常被拿来和同级别的闭源模型比性价比。
核心参数与架构一览
把关键指标摊开看,mimo v2 flash 的体量在开源圈属于第一梯队,但靠架构把实际推理开销压了下来。下面这张表列出官方技术文档披露的核心规格。
| | |
|---|
| | |
| | |
| | |
| | 多 token 预测,实测 2.5 到 3.7 倍加速 |
| | |
| | |
| | |
这套架构里最值钱的是两件事:一是混合注意力把 KV 缓存压到接近六分之一,长文本推理不再被显存卡死;二是 MTP 在解码阶段并行验证多个 token,打破了大批量下的显存带宽瓶颈,实测能跑出 2.5 到 3.7 倍的真实加速。
实测性能表现如何
光看参数不够,得看跑分。小米官方披露,mimo v2 flash 在 SWE-Bench 上拿到 73.4%,代码能力超过当时所有开源模型,可以比肩标杆闭源模型 Claude 4.5 Sonnet,而推理成本只有对方的 2.5%,生成速度还快一倍。 在公开基准测试里,它的数学与代码表现尤其亮眼:AIME 2025 数学题约 92.9%,MMLU-Pro 知识题约 83.1%,GPQA-Diamond 博士级科学题约 82.1%,LiveCodeBench 代码约 71.8%。综合智能指数在开源模型里排进前列,属于“花小钱办大事”的那一档。
需要注意,首发时的 API 定价是输入每百万 token 0.1 美元、输出 0.3 美元,后来官方又多次下调价格。再加上它能自托管、免 token 计费,对成本敏感又想用强模型的团队很友好。
它的3大优势有哪些
综合看,它的长处集中在三点。
第一是推理效率高,MTP 加混合注意力把速度和显存占用同时压下来,同样硬件能跑出更高吞吐。第二是代码和智能体能力强,SWE-Bench 73.4% 加上大量 Agent 评测进开源前二,做自动化编程、工具调用类应用很合适。
第三是完全开源、MIT 协议,可以免费自托管、做 INT4 量化往端侧搬,不受云服务绑定。
| | |
|---|
| MTP 2.5 到 3.7 倍加速,KV 缓存降至约六分之一 | |
| | |
| | |
使用前的3个注意点
优点之外,有几件事下手前要先认清。一是模型体量大,全精度权重接近 310B,即便 INT4 量化也需要可观显存,个人消费级显卡难以原生跑满,更多走云端或量化后部署。二是版本迭代快,原版 mimo v2 flash 的 API 已于 2026 年 6 月 30 日停止服务,小米把生产流量迁到了 V2.5、V2.6 等新系列,调用前务必确认当前可用版本,别照着旧文档直连。三是网上资料中英文混杂、版本号多(V2、V2.5、V2.6),下载权重时认准官方仓库,避免下错或碰到仿冒源。
怎么部署和调用
想用上它,有两条路。自托管的话,去小米官方公布的 HuggingFace 与魔搭社区仓库拉权重,用 transformers、vLLM、llama.cpp 或 SGLang 起服务,官方提供 OpenAI 兼容端点,改个 base url 和模型名就能接入现有代码。显存吃紧就做 INT4 或 FP8 量化,能在更小集群上跑起来。 走云端 API 的话,通过小米 MiMo 开放平台拿 key 调用,注意原版 V2 已停服,应在平台选当前在售的 V2.5 或 V2.6 系列;也可以借助支持该模型的本地工具(如 Ollama)直接加载权重做本地推理。具体入口和价格以小米 MiMo 官方页面当前显示为准。
小米mimo v2 flash常见问题
问:小米mimo v2 flash 和 V2.5、V2.6 有什么区别?
答:三者同属 MiMo 家族,V2 是原版(309B 总参、15B 激活、256K 上下文),V2.5 与 V2.6 是后续升级,上下文扩到约 1.1M、参规模更大、价格更低,原版 API 已停服,新项目建议直接用新系列。
问:它免费吗?
答:权重 MIT 开源,自托管本身不收 token 费;官方 API 原版曾限时免费,后续转为按量计费并多次降价,具体以官方页面为准。
问:本地电脑能跑吗?
答:全精度需要大显存,个人显卡难原生跑满;做 INT4 量化后可在较小设备上部署,但体验和速度要看硬件。
问:支持多长的上下文?
答:技术文档标注原生 32K、外推至 256K,后续系列进一步扩到百万级。
问:怎么调用它的 API?
答:开放平台提供 OpenAI 兼容端点,换 base url 和模型名即可,和主流 SDK 写法一致。
问:和 DeepSeek、Kimi 比怎么样?
答:同属开源大模型第一梯队,mimo v2 flash 强在代码与智能体、推理性价比;选哪个看你的任务类型和部署偏好。 问:中文支持好不好?
答:作为国产模型,中英文都做了训练,日常中文问答与代码注释表现稳定。
问:现在还能用原版 V2 的 API 吗?
答:不能,原版 API 已于 2026 年 6 月 30 日停服,需转向 V2.5、V2.6 或自托管权重。
问:适合什么场景?
答:自动化编程、工具调用型智能体、成本敏感的高并发推理,以及需要离线或隐私自托管的业务。
注意事项
1. 调用前先确认版本,原版 V2 的 API 已停服,新项目直接用 V2.5 或 V2.6 系列。
2. 自托管注意显存规划,全精度权重体量大,量化后仍需合理资源。
3. 量化有取舍,INT4 省显存但可能轻微掉点,关键任务先小范围验证。
4. API 价格会调整,下单前以小米 MiMo 官方页面当前显示为准。
5. 权重只从官方公布的 HuggingFace、魔搭社区仓库获取,认准 XiaomiMiMo 组织。
6. 不要从非官方或疑似仿冒域名下载权重,避免安全风险。
7. 模型知识截止日期官方未公开,时效性强的信息需自行核实。
8. 多模态不是 V2-Flash 的强项,需要图文音视频统一处理可看同系的 Omni 版本。
9. 不同系列的上下文、价格、端点不通用,迁移时逐项目核对配置。
综合来看,小米mimo v2 flash怎么样?它是一代高性价比的开源 MoE 旗舰,代码与智能体能力强、可自托管、价格低,缺点是大体量部署门槛和原版 API 已停服;新项目直接用 V2.5、V2.6 系列或自托管权重,仍能拿到它的核心能力。
 AI 速览