AI 速览
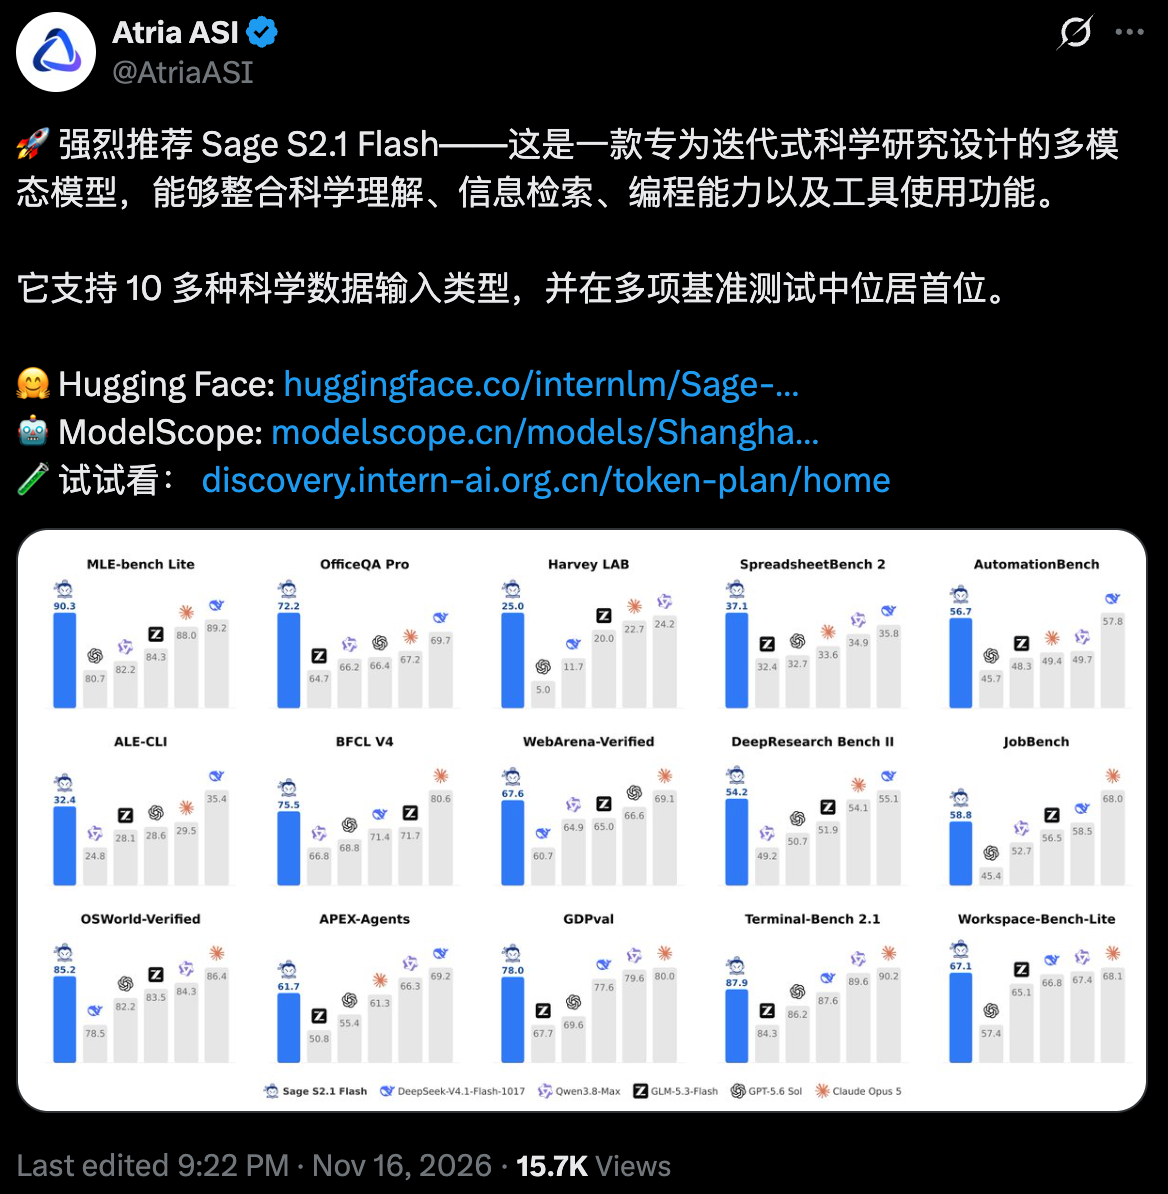
上海人工智能实验室开源科学多模态模型 Sage S2.1 Flash,面向多轮科研分析,适合关注科研AI模型的开发者和研究者。 核心事实 - 开源动态:11月17日公开代码和模型权重,主模型采用MIT许可 - 模型规格:320B-A18B MoE架构,支持分子图、晶体结构、蛋白质序列与3D结构等十余种科学输入 - 能力定位:结合科学数据理解、检索、编程与工具调用,支持多轮分析、验证与调整 - 部署要求:参考部署使用8块H200,需启用远程代码信任选项和官方vLLM补丁 - 评测成绩:官方模型卡称MLE-bench Lite得分90.3,六模型对比第一,暂无独立复跑 - 下载渠道:已在Hugging Face和ModelScope提供下载 避坑提示 - 许可范围:主模型MIT许可不代表全部配套组件适用同一许可 - 部署成本:需额外配置科学编码器、任务readout和预处理依赖,权重下载只是第一步 - 非流式限制:思考结束或工具调用标记可能提前终止推理或隐藏工具调用 - 评测可信度:90.3分由官方报告,评测设置未完整披露 - 继任关系:无技术报告,不能推断其为Intern-S1直接继任者 时间线 - 11月15日:主模型Hugging Face仓库创建 - 11月16日:GitHub仓库创建 - 11月17日:公开代码和模型权重的消息发布 价值点 对科研AI开发团队来说,这是一份了解开源科学模型能力边界与真实部署成本的一手参考。
# 报错信息分析与调试指南 ## 任务说明 请分析用户提供的报错信息,推测可能的错误原因,并提供系统性的调试步骤。 ## 分析要求 1. **错误类型识别** - 确定是语法错误、运行时错误、逻辑错误还是环境配置错误 - 识别具体的错误类别(如空指针、数组越界、类型不匹配等) 2. **原因推测** - 基于错误信息中的关键线索进行合理推断 - 考虑常见的导致此类错误的编程场景 - 分析可能的代码问题或环境问题 3. **调试步骤** - 提供从简单到复杂的逐步调试方法 - 包括代码检查、日志添加、环境验证等具体操作 - 给出预防类似错误的最佳实践建议 ## 输出格式 - **错误类型**:[具体的错误分类] - **可能原因**: 1. [原因1] 2. [原因2] 3. [原因3] - **调试步骤**: 1. [步骤1] 2. [步骤2] 3. [步骤3] 4. [步骤4] - **解决方案**:[具体的修复建议] ## 示例 **输入**:【报错信息】 ``` TypeError: Cannot read property 'length' of undefined at processData (app.js:25:18) at main (app.js:10:5) ``` **输出**: - **错误类型**:运行时错误 - TypeError - **可能原因**: 1. 变量未正确初始化就被访问其 length 属性 2. 函数参数传递了 undefined 值 3. 异步操作中数据还未加载完成就尝试访问 - **调试步骤**: 1. 检查 app.js 第25行附近的变量声明和赋值 2. 在访问 length 属性前添加类型检查:`if (variable && variable.length)` 3. 使用 console.log() 输出相关变量的值确认其状态 4. 检查函数调用时传入的参数是否正确 - **解决方案**:在访问对象属性前先验证对象是否存在,或确保变量在使用前已被正确初始化。