Gemini 4 Neon 的标准价是每百万 Token 输入 3 美元、缓存输入 0.15 美元、输出 15 美元(含思考)。它现在比 Gemini 4 Carbon 贵一半,但 12 月 1 日 Carbon 和 Argon 双双翻倍到 4 美元和 20 美元,Neon 不动,性价比排名会原地反转。 Gemini 4 Neon 是什么型号
Google 在 2026 年 11 月 18 日(美国时间)正式开放 Gemini 4 Neon,模型 ID 为 gemini-4-neon,在家族里排在 Hydrogen 和 Carbon 之间。官方给它的定位是“把前沿能力下放到更快、更便宜的档位”,Gemini App 的模型选择器里对应的说明就四个字:深度分析。
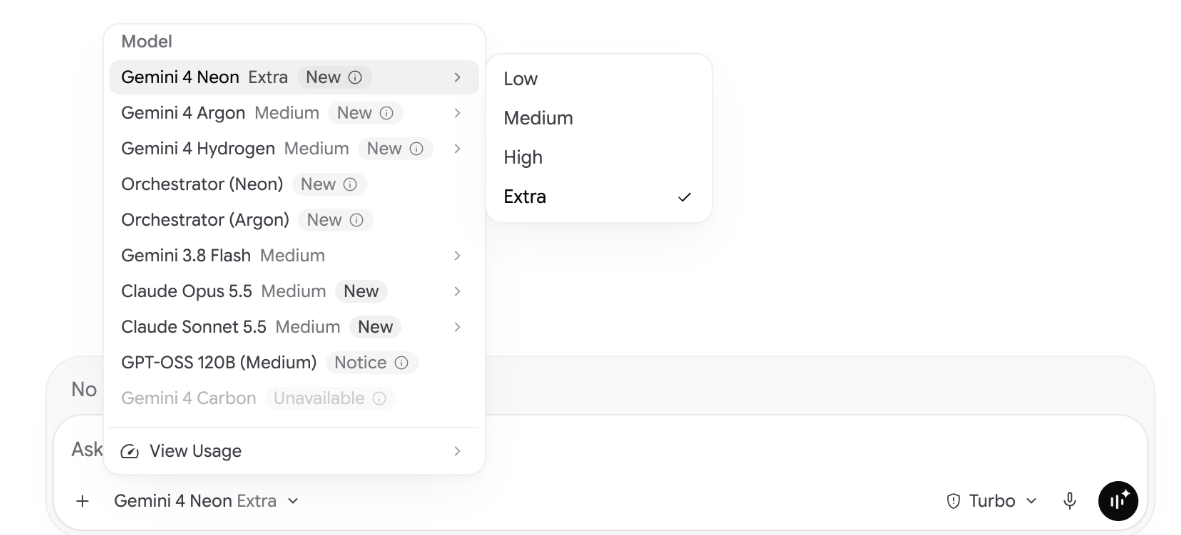
三条规格决定了它怎么花钱:上下文 1,048,576 Token,输入、思考和输出共用这一个窗口;单次前台请求的输出上限 65,536 Token;知识截止 2026 年 3 月。思考档位四档,low、medium、high、xhigh,默认落在 high。
入口有五处:AI Studio 里的 Gemini API、Gemini 企业版的 API 与模型下拉菜单、Google AI Pro 与 Ultra 订阅用户在 Google Antigravity 里调用、Pro 与 Ultra 在 Gemini App 里直接选,以及 Google Cloud 的 Vertex 侧。订阅能用和 API 能调是两件事,两边的额度不互通。
四档费率:从标准到优先级的价差
Batch 和 Flex 同价,区别在用法:Batch 要任务能打包成异步文件,Flex 是能容忍排队和重试的实时请求。Priority 贵 80%,买的不是更聪明,是高峰期不被挤下去。
Neon 全系保持 1:5 的输入输出比和 95% 的缓存折扣,这一点和 Gemini 4 其他型号一致。含义挺实际:同样的 Token 数,Neon 永远是 Hydrogen 的 2 倍,11 月底之前是 Carbon 的 1.5 倍,12 月 1 日之后变成 Carbon 的 0.75 倍。真正决定账单的是每个任务烧掉多少 Token,不是每百万 Token 挂多少钱。
缓存、思考 Token 与搜索接地费
缓存这块 Gemini 走的是另一条路:只做隐式缓存,你不能自己建缓存对象,命中条件是重复的提示词前缀足够长,官方门槛是 4,096 Token。命中后按 0.15 美元计,是标准输入价的 5%。前缀每轮都变,这个折扣就拿不到。
对比一下 Anthropic 那边要单独收缓存写入费,Gemini 4 目前不收,所以拿两家的单价直接横向比,会低估或高估实际成本。
思考 Token 按输出价计费,也就是 15 美元/百万,表格里输出那一列写的就是“含思考”。思考档位不改变单价,改变的是模型在回答前消耗多少 Token:默认的 high 已经能满足多数任务,xhigh 留给最难的工程、分析和科研场景,代价是输出量成倍上涨。
还有一笔常被漏算的费用:搜索接地。Google 搜索接地每月含 5,000 次免费请求,由 Gemini 3 及更新模型共享,超出后按每 1,000 次 14 美元计费;Google Maps 接地是同样的规则。Batch 和 Flex 档目前没列接地价。做联网调研类智能体时,这笔钱经常比 Token 费还显眼。
一个任务实际花多少钱
单价只是原料。下面五个算例都按标准档、不含税计算,费用四舍五入到小数点后两位:
第一行和第二行之间的差,就是隐式缓存的价值:同样的客服机器人,前缀没命中是 0.035 美元一次,命中后 0.012 美元,掉了将近三分之二。按月跑 10,000 次算,一个是 350 美元,一个是 120 美元。
第四行说明 Batch 的用途。同一个代码审查任务,打包成异步批次跑只要 0.29 美元,几乎砍半,代价是拿不到即时回复。夜间跑全库审查、批量回填文档,这类任务没有非实时不可的理由。
最后一行最值得注意。Agent 的 Token 费只有 0.63 美元,20 次搜索接地却要 0.28 美元,占了三分之一。做联网调研类应用,接地费的量级和 Token 费是同一档次,预算里不能只算 Token。
还有一个天花板要知道:1,048,576 Token 的窗口是输入、思考、输出共用的。塞进 80 万 Token 的文档,留给回答的空间只剩不到 25 万,而且单次前台输出的硬上限是 65,536。长文档任务真正限制你的往往不是钱,是窗口怎么切。
12 月 1 日调价后的横向对比
这是选型时最容易算错的一段。Gemini 4 的定价表里,Argon 和 Carbon 现在挂的是首发价,有明确截止日期:
11 月底之前,Neon 是三个高端型号里最贵的那个,比 Carbon 高 50%。12 月 1 日之后,Carbon 和 Argon 一起走到 4 美元和 20 美元,Neon 原地不动,反而成了三者中单价最低的。也就是说,现在觉得 Neon“偏贵”的判断,跨过这个日期会自动失效。
单价之外还有单任务成本。Google 公布的数字是:默认 high 档下,Neon 的每个任务成本比 Carbon 低 32%,而早期评估里它的任务质量持平甚至超过 Carbon,速度约为 3 倍。这批数字属于厂商自评,第三方复现未必一致;Artificial Analysis 在 xhigh 档给出的口径是每个测试任务约 6.44 美元。
按截止时间来选档位比按价格选更实际。有人盯着屏幕等结果,用标准档;夜里跑的代码审查和回填,换 Batch 省一半;线上智能体有可用性承诺,Priority 多付 80% 换容量;介于两者之间、能接受重试的,用 Flex。
开通前要留意的七个细节
- 没有免费的 API 额度:Neon 不在免费层,Gemini 4 家族里目前只有 Hydrogen 提供免费调用。
- 缓存只能隐式命中:不能自己建缓存对象,前缀要稳定且不少于 4,096 Token,否则 0.15 美元的折扣吃不到。
- 输出那一列含思考:15 美元/百万 Token 覆盖了回答和思考两部分,档位开高,账单跟着厚。
- 12 月 1 日是分水岭:Carbon 和 Argon 翻倍,Neon 不变。签年度用量承诺时,把这个日期前后的价差算进去。
- 搜索接地单独计费:每月 5,000 次免费后按 14 美元/千次收,联网类智能体的这笔钱常常超过 Token 费。
- 单次输出 65,536 封顶:要更长输出得走续写接口,不是改个参数就行,长报告类任务要提前设计分段。
- 区域端点加价 10%:Google Cloud 上非全球端点比全球端点贵一成,数据驻留要求会直接反映到单价里。
Gemini 4 Neon 价格常见问题
Q:Gemini 4 Neon 多少钱? A:标准档每百万 Token 输入 3 美元、缓存输入 0.15 美元、输出 15 美元(含思考),Batch 和 Flex 五折,Priority 是标准的 1.8 倍。
Q:有免费额度吗? A:没有。Gemini 4 家族里目前只有 Hydrogen 在免费层,Neon 必须走付费 API 或订阅。
Q:批量处理能省多少? A:Batch 和 Flex 都是标准价的五折,输入 1.50 美元、输出 7.50 美元,代价是不能即时返回。
Q:缓存怎么用才省钱? A:保持提示词前缀稳定且不少于 4,096 Token,命中后按 0.15 美元计,是输入价的 5%。Gemini 只做隐式缓存,不需要也不能手动建缓存对象。
Q:思考档位会影响价格吗? A:单价不变,变的是消耗量。思考 Token 按输出价 15 美元计费,默认 high 已够多数任务,xhigh 留给最难的场景。
Q:12 月 1 日 Neon 会涨价吗? A:Google 的定价表上没有给 Neon 标注截止日期,涨价只挂在 Carbon 和 Argon 上。但这条属于会变的信息,签约当天再看一眼定价页比较稳。
Q:和 Gemini 4 Carbon 比,哪个更划算? A:11 月底之前 Neon 单价高 50%,但官方称 high 档下单任务成本低 32%;12 月 1 日之后 Carbon 翻倍,Neon 单价直接低 25%。
Q:搜索接地怎么收钱? A:每月 5,000 次免费请求由 Gemini 3 及更新模型共享,超出后每 1,000 次 14 美元,Maps 接地同一套规则。
Q:为什么账单里输出比输入贵那么多? A:Neon 的输入输出比固定 1:5,输出 15 美元对输入 3 美元,而且思考 Token 也算在输出里。
12 月 1 日之前,Gemini 4 Neon 价格比 Carbon 贵一半;过了这天,它反而成了三个高端型号里最便宜的。所以真正要算的不是单价,是这份 Gemini 4 Neon 价格对照表在你的合同周期里会变成什么样。
 AI 速览