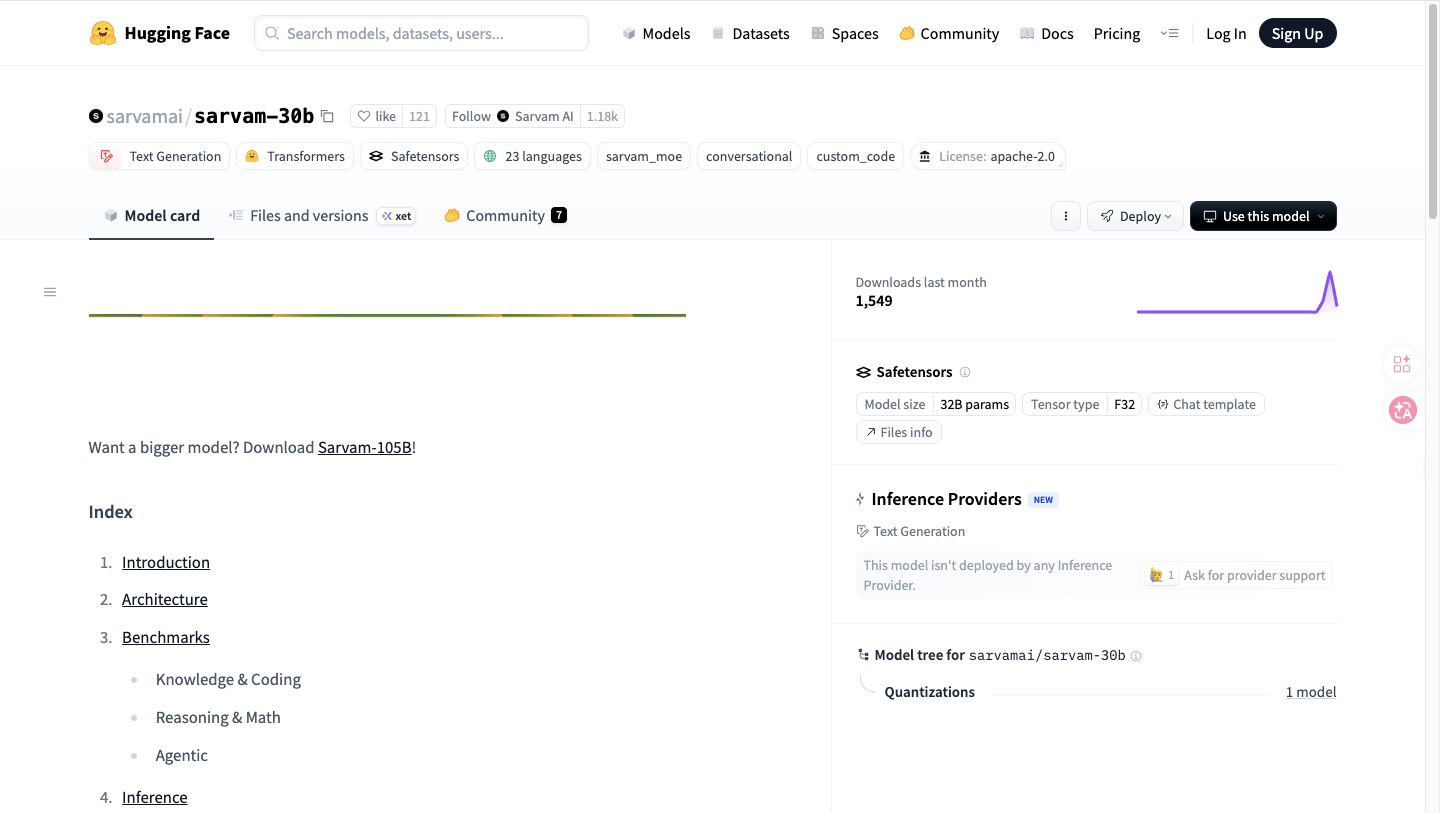
3月9日消息,印度班加罗尔AI初创公司Sarvam AI于2月18日在印度人工智能影响峰会上正式发布并开源两款大语言模型:Sarvam 30B和Sarvam 105B。这是印度首个完全在本土训练、面向全球开发者开源的大型语言模型系列,标志着印度在主权AI领域迈出关键一步。
双模型策略:轻量实时对话 vs 企业级复杂推理
两款模型均采用MoE(专家混合)架构,在推理时仅激活部分参数,显著降低计算成本。Sarvam 30B专为对话式AI和本地部署优化,支持印地英语等混合语言;105B版本则瞄准代理任务和工具调用场景。
训练数据与本土特色
Sarvam AI强调,两款模型完全在印度本土训练,依托印度人工智能使命计划(IndiaAI Mission)提供的算力资源。训练数据特别注重印度语言覆盖,支持全部22种印度官方语言,包含大量代码混合文本(如印地英语混用)。
这一"本土训练+本土语言"策略,使Sarvam模型在处理印度本土语境时具备天然优势,与主要面向英语优化的国际模型形成差异化竞争。
性能表现:自测成绩亮眼,但独立验证待观察
根据Sarvam AI公布的自测数据,105B模型在多项基准上表现突出:
公司声称在代理任务和工具调用等场景中,105B的表现优于DeepSeek R1和Gemini Flash。不过,这些成绩尚未经过第三方独立验证,其实际竞争力仍需开源社区进一步测试确认。 开源策略:"权重开源"引发讨论
Sarvam AI已在Hugging Face上以Apache 2.0许可证发布模型权重,允许开发者自由下载、微调和商用。但公司并未公开完整训练代码和数据集,这种"权重开源"模式在Hacker News等社区引发讨论——部分开发者认为这限制了模型的可审计性和完全复现能力。
值得注意的是,Sarvam AI已被选中参与构建一个1200亿参数的主权LLM生态系统,显示出印度政府对AI自主性的战略重视。
市场定位:高效小模型的差异化路线
与OpenAI、谷歌等巨头追求"越大越好"的路线不同,Sarvam AI押注高效、小参数开源模型。通过MoE架构,105B模型在推理时仅激活约103亿参数,在保持性能的同时大幅降低部署成本。这一策略与当前开源社区对"小模型+高效率"的偏好相契合。
不过,Sarvam AI面临的市场竞争不容小觑。DeepSeek、Qwen、Llama等开源模型已建立成熟的生态和社区,Sarvam能否凭借印度语言特色打开差异化市场,将是其后续发展的关键看点。
 AI 速览