如果你最近在关注智谱AI的动态,应该看到他们推出了一款叫GLM-5-Turbo的新模型。说实话,这个模型有点特别——它不是那种想在通用榜单上刷高分的大路货,而是专门为OpenClaw龙虾场景打磨的"专科选手"。
这次评测的基本数据
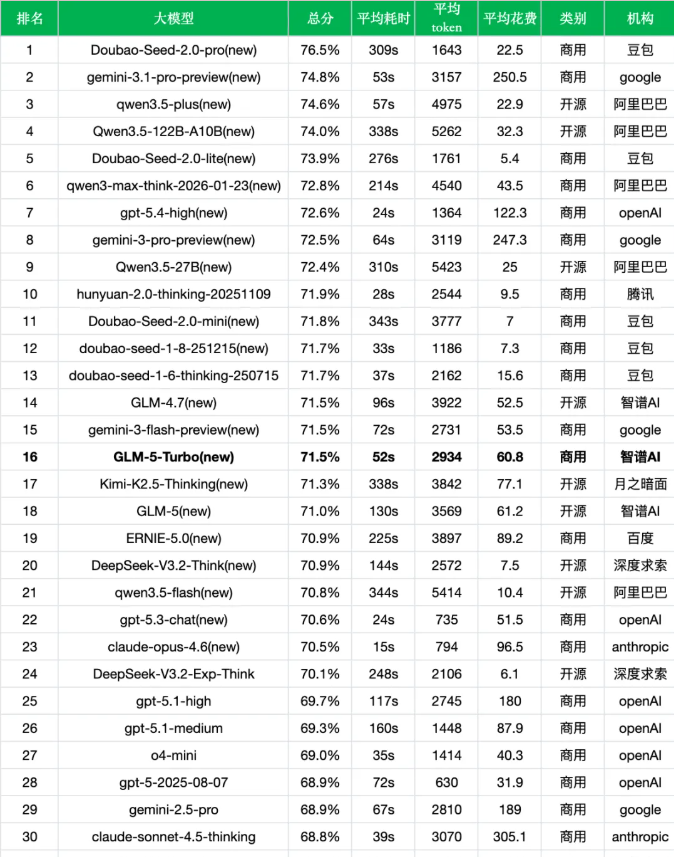
先把关键数字摆出来:约1.5万道测试题,综合准确率71.5%,平均响应时间52秒,每次调用平均消耗2934个token,每千次调用花费约60.8元人民币。这几个数字单看没什么感觉,但跟上一代GLM-5对比,差距就出来了。
老版本对比:速度是最大惊喜
GLM-5-Turbo相比GLM-5,准确率从71.0%微升到71.5%,提了0.5个百分点,排名从第18位升到第16位。这点提升说实话不算显眼。但响应速度从130秒缩短到52秒,提速将近60%,这个变化才是真正值得关注的地方。
具体到各细分维度,语言与指令遵从从67.6%升至69.3%,这跟GLM-5-Turbo主打"复杂指令拆解"的定位挺搭。推理与数学从73.6%升至74.8%,法律行政从79.3%升至80.3%,都是稳步向好。但教育类别从59.0%跌到55.9%,下降了3.1个百分点,医疗健康也从85.7%微降至84.4%,这应该是训练资源更多向Agent方向倾斜导致的。Agent与工具调用维度只从64.2%微升到64.5%,几乎没动,不过官方ZClawBench测的是真实龙虾工作流下的工具链调用,跟这次的评测框架侧重点不一样,所以也说明不了什么。
Token消耗从3569降到2934,减少了将近18%。输出单价从18元/百万token上调到22元/百万token,涨了约22%,但因为输出变精炼了,实际每千次调用费用从61.2元微降到60.8元,基本没变。"更少token+更高单价=总成本不变"这个组合,倒是挺有意思的一种产品策略。
横向对比:跑分不是它的主场
把GLM-5-Turbo放到当前竞争格局里看,60.8元/千次的花费处于中高成本区间。同档位里,GLM-4.7用52.5元实现了同样的71.5%准确率,成本略低。往上看,claude-opus-4.6花费约96.5元但准确率70.5%,反而不及GLM-5-Turbo。往下看,Doubao-Seed-2.0-pro以22.5元拿到76.5%的准确率,性价比相当强悍,但这些模型并没有专门针对Agent场景优化,直接拿准确率比较意义其实有限。 速度方面,52秒的平均耗时在同价位里确实有优势,明显快于GLM-4.7的96秒和GLM-5的130秒,对于需要多轮工具调用和长链路执行的龙虾场景,这个速度差的实际价值比0.5个百分点的准确率差异更有用。
当前榜单头部由Doubao-Seed-2.0-pro(76.5%)、gemini-3.1-pro-preview(74.8%)和qwen3.5-plus(74.6%)占据,GLM-5-Turbo的第16名在通用中文能力上与头部有差距,但这几款头部模型都是通用旗舰或深度推理定位,不在同一个赛道。
另外值得一提的是,GLM-5-Turbo是智谱近期少见的闭源模型,智谱一向以开源GLM系列著称。官方说相关研究成果会整合进下一个开源版本。开源阵营里,同为智谱出品的GLM-4.7准确率相同但成本更低;更广泛的选手如qwen3.5-plus和Qwen3.5-122B-A10B在准确率和成本上都有优势;DeepSeek-V3.2-Think甚至以7.5元/千次的极低成本拿到接近的表现。 官方评测说明了什么
随着OpenClaw龙虾使用越来越普遍,智谱发布了专门针对龙虾场景的端到端Agent评测基准ZClawBench。当前OpenClaw任务覆盖安装配置、代码开发、信息搜集、数据分析、内容创作等多种类型,用户群也从最早的开发者扩展到了效率办公、金融、运维、内容创作等人群。一个值得注意的数字是,Skills使用比例在短时间内从26%跳升到45%,说明Agent能力正在向模块化、技能化方向演进。ZClawBench的评测结果显示,GLM-5-Turbo在OpenClaw场景下的表现相比GLM-5有显著提升,在多项关键任务上整体领先多家主流模型。
GLM-5-Turbo的200K上下文窗口、128K最大输出、原生思考模式、MCP支持,这些能力在OpenClaw工作流里能发挥的价值,是通用跑分替代不了的。对你来说,如果业务场景恰好涉及复杂工具链调用和长链路执行,GLM-5-Turbo值得认真考量;如果只是日常通用任务,这个价位其实有不少性价比更高的选择。
 AI 速览