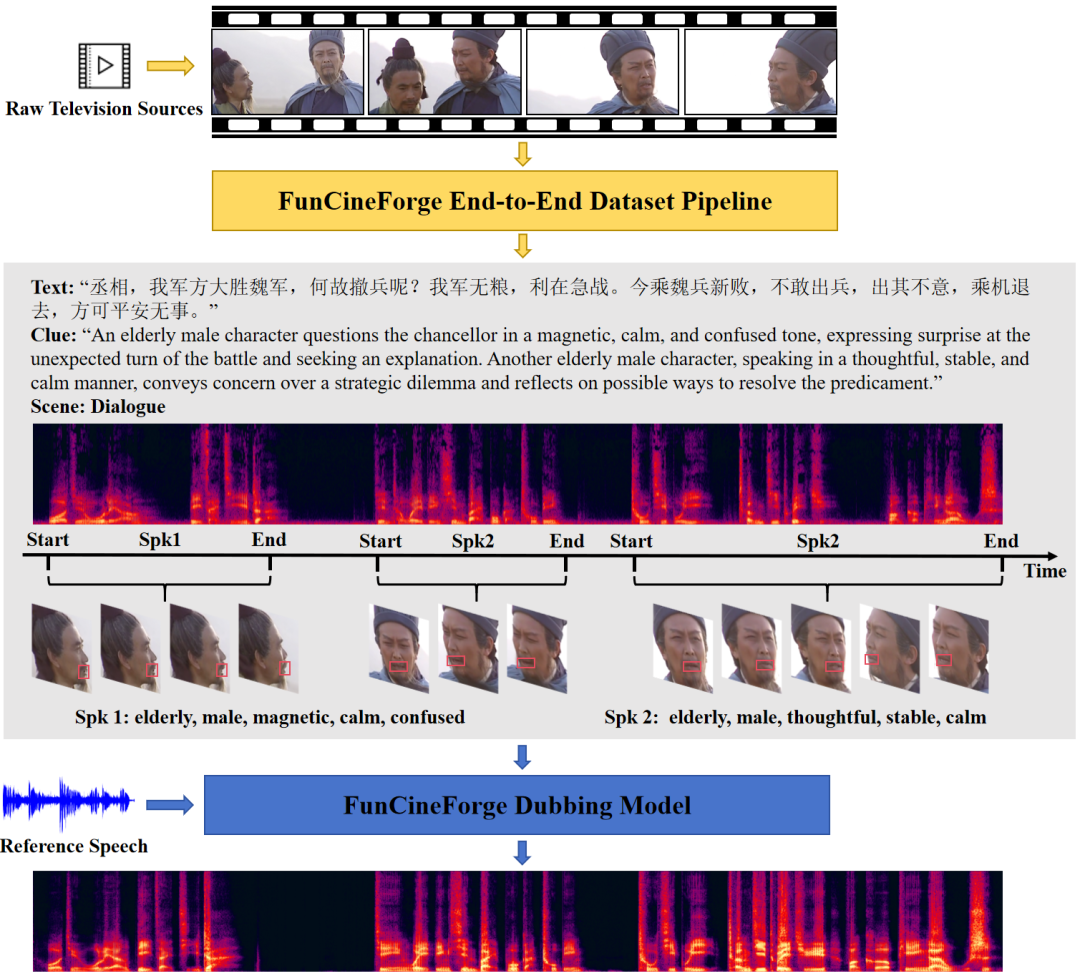
3月16日消息,通义实验室今日发布并开源了 Fun-CineForge,这是业界首个支持影视级多场景配音的多模态大模型,同时开放了配套的高质量数据集构建方法 CineDub。
在影视、动画和游戏制作中,AI 配音长期面临四大核心挑战:口型同步、情绪表达、音色一致和时间对齐。尤其在多人对话、频繁镜头切换、人脸遮挡等复杂场景下,传统方法仅依赖唇部区域学习音画同步,难以有效应对。
Fun-CineForge 的关键技术突破在于首次将"时间模态"引入配音模型。模型同时融合视觉、文本、音频和时间四类信息,使其即使在"看不到"说话人的画面中,也能让语音准确出现在对应时间区间内。模型基于 CosyVoice3 语音合成能力构建,输入无声视频、配音文本、角色属性及参考语音,即可合成与画面高度对齐的语音。
数据侧,团队构建了一套自动化数据生产流程,从350多部中英文影视剧中提取结构化多模态数据。通过基于大模型思维链的双向矫正机制,中文字错率从 4.53% 降至 0.94%,英文词错率从 9.35% 降至 2.12%,说话人分离错误率从 8.38% 降至 1.20%。
实验评估显示,Fun-CineForge 在语音自然度、字错率、情感表达、音色相似度、唇形同步和时间对齐等多项指标上均优于 DeepDubber-V1 和 InstructDubber 等现有开源模型。其中独白和旁白场景效果最优,中文字错率分别仅为 1.49% 和 1.90%,并首次支持双人及多人对话配音。
目前 Fun-CineForge 已在 GitHub、HuggingFace 和 ModelScope 三个平台同步开源,支持 30 秒以内视频片段的中英文配音推理。团队表示,随着多模态大模型能力持续提升,未来 AI 有望在影视、动画、游戏等内容生产领域发挥更大作用。
 AI 速览