5.18亿参数,0.63秒生成9秒音频,ICLR 2026收录,已开源。PrismAudio是首个将强化学习与思维链结合的视频生成环境音框架,让AI学会像音效师一样"看画面、想声音、配音效"。
一、AI视频配音到底难在哪?
用AI给视频生成音频,听起来很简单——一匹马在草原上跑,配上马蹄声不就行了?
但真正做过视频后期的人都知道,一段合格的环境音需要同时过四道关卡:
语义要对:画面里是马在跑,音效必须是马蹄声,不能出现鸟叫或风声。时序要准:马蹄落地的那一帧,声音必须同步响起,差100毫秒观众就能感觉到不对劲。音质要好:声音需要有层次感和空间感,不能像合成器直出的电子音那样单薄。空间要对:马从左跑到右,声音也应该从左声道过渡到右声道。
现有的V2A(Video-to-Audio)模型,包括MMAudio、ThinkSound等,在面对这四个维度时往往"顾此失彼"。为了让语义更准确,时序可能就跑偏了;为了提升音质,空间感又丢了。根本原因在于:这些模型把四个目标塞进同一个损失函数里训练,目标之间互相"打架",谁也兼顾不好。
二、PrismAudio是什么?
PrismAudio是阿里巴巴通义实验室(FunAudioLLM团队)推出的视频生成环境音框架。需要明确的是,PrismAudio专注于环境音和音效合成——马蹄声、风雨声、金属碰撞声等与画面同步的背景声音,而不是给人物配语音对白。
PrismAudio的核心创新点可以用一句话概括:首个将分解式思维链(Decomposed Chain-of-Thought)与多维度强化学习(Multi-dimensional RL)紧密结合的V2A框架。
这项研究已被顶级AI会议ICLR 2026收录,模型权重和代码均已开源。
三、PrismAudio怎么做到的?三步走策略
第一步:分解式思维链——先写笔记,再发声
传统的V2A模型是"端到端"工作:输入一段视频,直接输出一段音频。整个过程是黑盒,模型内部的决策逻辑不可见、不可控。
PrismAudio则要求模型在生成音频之前,先"写笔记"。具体来说,模型会分四个维度进行推理:
- 语义笔记:视频里出现了什么物体和场景?应该产生什么声音?
- 时序笔记:每个声音在哪一帧开始、哪一帧结束?多个声音的先后顺序如何?
- 美学笔记:声音应该是什么质感?清脆还是低沉?远处还是近处?
- 空间笔记:声源在画面的哪个位置?是静止的还是移动的?
四份笔记拼接成一份"行动指南",再交给音频扩散模型去执行。这种方式让每一步生成决策都有据可依,而不是让模型"一拍脑袋"出声音。
在技术实现上,PrismAudio使用Gemini 2.5 Pro生成思维链训练数据,然后微调VideoLLaMA2来承担实际推理任务。 第二步:四维度奖励函数——四位老师各打各的分
生成音频后,如何评判质量?PrismAudio为四个维度各配备了一个独立的"评委":
四个分数独立计算后汇总为综合评分。模型在训练过程中要同时提升四个维度的表现,任何一个维度掉队都会拉低总分。这解决了传统方法中"单一损失函数导致目标冲突"的核心痛点。
第三步:Fast-GRPO——高效训练算法
强化学习训练扩散模型有一个现实瓶颈:太慢了。传统的GRPO方法每一步都要做随机采样,计算开销巨大,训练一轮可能要好几周。
PrismAudio提出的Fast-GRPO算法采用混合ODE-SDE采样策略,只在生成过程的关键时间段做随机探索,其余时间走确定性快速通道。实测结果表明:Fast-GRPO只需200步就能达到传统方法600步的性能水平,训练效率大幅提升。
四、效果如何?数据说话
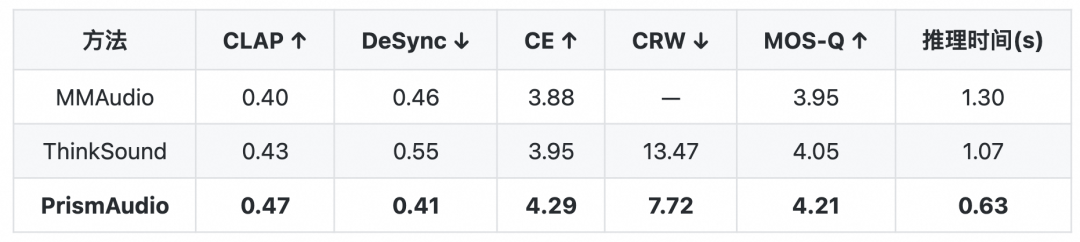
PrismAudio在两个测试集上全面超越现有最优方法。
VGGSound测试集(主流V2A基准):PrismAudio在语义、时序、美学、空间四个维度均取得最佳成绩,超越了MMAudio(CVPR 2025)和ThinkSound(NeurIPS 2025)等强力竞品。
AudioCanvas测试集(PrismAudio团队自建的复杂场景基准):包含300个单事件类别和501个多事件样本,覆盖更复杂、更多样的真实场景。在这个更具挑战性的测试集上,PrismAudio的优势更加明显。
在主观评测(MOS评分)中,PrismAudio的音质评分为4.21(满分5分),视频匹配度评分为4.22,均领先最近的竞争对手ThinkSound。
更关键的效率指标:PrismAudio仅有5.18亿参数,生成9秒音频只需0.63秒,比那些动辄几十亿参数的大模型更轻量、更实用。
五、PrismAudio vs 其他V2A模型
当前V2A领域的主要玩家对比:
| | | |
|---|
| | | |
| | | PrismAudio的前身,NeurIPS 2025 |
| | | |
| | | |
| | | |
PrismAudio相比前身ThinkSound的核心改进在于:将ThinkSound的单一整体CoT拆解为四个独立CoT模块,并为每个模块配备专门的奖励信号,从而解决了"目标纠缠"问题。
六、实际应用场景
PrismAudio的技术路线对以下场景价值明显:
短视频/短剧制作:AI生成视频后自动配上环境音,省去手动找音效素材和对齐时间轴的工作。比如用可灵、即梦生成一段风景视频,PrismAudio可以自动匹配风声、水声等环境音。 游戏和VR音效:根据画面内容实时生成匹配的环境音效,减少音效师的手工工作量。
影视后期:为无声素材自动生成环境音底,作为音效师的起点方案,提升后期效率。
无障碍内容:为无声视频自动添加音频描述层,提升内容可访问性。
需要注意的是,PrismAudio目前聚焦环境音和音效,不支持人声对白生成。如果你需要AI配音(人声旁白),可以使用CosyVoice、剪映AI配音、冬瓜配音等TTS工具。两者组合使用,可以构建更完整的AI视频音频流水线。
七、如何体验PrismAudio?
PrismAudio已全面开放,提供多种体验方式:
在线Demo(即开即用):
- HuggingFace Spaces:https://huggingface.co/spaces/FunAudioLLM/PrismAudio
- 魔搭创空间:https://www.modelscope.cn/studios/iic/PrismAudio
开源模型权重(本地部署):
- HuggingFace:https://huggingface.co/FunAudioLLM/PrismAudio
- 魔搭社区:https://www.modelscope.cn/models/iic/PrismAudio
代码仓库:
- GitHub(ThinkSound的prismaudio分支):https://github.com/liuhuadai/ThinkSound
本地部署需要Python 3.10环境,具体安装步骤见GitHub仓库说明。模型权重采用MIT许可证发布,但当前仅限研究和教育用途,商用需获得作者授权。
论文地址:https://arxiv.org/abs/2511.18833
八、总结
PrismAudio的核心贡献不在于堆参数或堆数据,而在于方法论创新:把复杂的多目标生成问题拆解为可独立优化的子模块,让模型"先想清楚再动手",并用独立的评价体系确保每个维度都不掉队。
"拆解任务、多维反馈、高效优化"这套思路,不仅解决了V2A领域的目标冲突问题,也为其他需要平衡多个相互竞争目标的AI生成任务(如视频生成、3D生成等)提供了可借鉴的范式。
对于AI视频创作者来说,PrismAudio代表的方向很明确:未来的AI视频工具链将逐步实现"画面+声音"的一体化生成,视频后期中最繁琐的音效对齐工作将被大幅简化。建议关注这一技术路线的后续发展,尤其是商用化落地进展。
 AI 速览