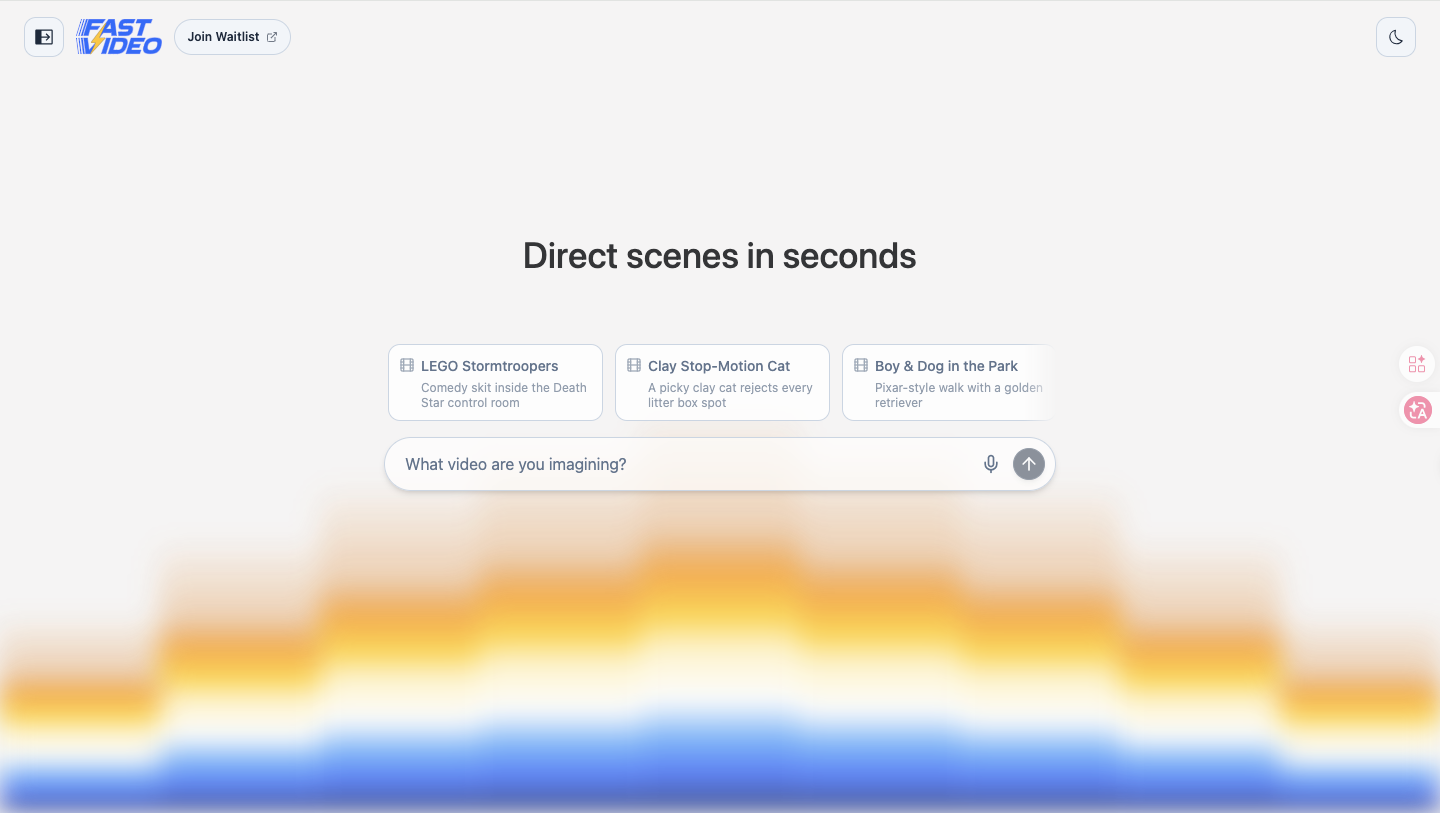
3月17日消息,加州大学圣地亚哥分校(UCSD)Hao AI Lab正式发布Dreamverse原型界面及配套演示,这是一个基于其开源FastVideo推理栈构建的交互式AI视频创作系统。其核心突破在于:在单块NVIDIA B200 GPU上,以约4.55秒的端到端延迟生成一段5秒的1080p含音频视频,生成速度首次快于视频播放时间,从根本上改变了创作者与AI视频生成工具的交互方式。
核心问题:被打断的创作循环
如果你从事媒体创作,你一定熟悉这种挫败感:脑中冒出一个想法,输入提示词,或许附上一张参考图,然后希望立刻看到结果——趁灵感还在的时候。但现有的视频生成API打断了这个循环。你要等上几分钟才能看到片段,而每次生成的成本都让人心疼。
这不仅仅是"慢"的问题,而是创作模式本身被迫变成了线性的、离散的:写一个高度工程化的提示词,提交,等待数分钟,查看结果,不满意则重写,再等待。当每次尝试都耗时数分钟并消耗预算时,创作循环就崩塌了——一个工具如果比你的想象力还慢,就不是有效的工具。以Google Veo-3 Fast为例,生成一段8秒视频约需55秒。 从"提示词工程"到"氛围直控"
Dreamverse提出了一种截然不同的交互范式——"Vibe Directing"(氛围直控)。
与传统工具要求用户预先构思完整、精确的提示词不同,Dreamverse允许创作者在视频实时生成并展开的过程中,通过聊天界面持续发出自然语言调整指令:改变摄像机角度、放慢动作、延续场景、切换风格。创作者真正想要的不仅仅是一个生成结果,而是探索多种可能的能力——尝试不同想法、改变构图、调整运动、添加参考图、重新运行,直到满意为止。这才是真实创作的工作方式。
这种交互之所以成为可能,完全依赖于生成速度对"实时"门槛的跨越。当5秒视频的生成只需4.55秒,创作者无需在"提交"与"等待"之间反复切换,而是进入一个连续、流动的创作状态。
全栈优化:如何把1080p生成压到5秒以内
实现1080p生成的亚5秒端到端延迟,要求对技术栈的每一层进行优化:模型实现、内核、低精度计算、编译、调度,甚至帧处理和音频处理的基础设施。
FastVideo的技术积累横跨过去一年多的系列研究。2025年2月发布的滑动瓦片注意力(Sliding Tile Attention, STA)将HunyuanVideo的生成时间从H100上的16分钟压缩至5分钟,注意力计算较FlashAttention-2加速2.8-17倍,较FlashAttention-3加速1.6-10倍,且无质量损失。此后团队又推出了视频稀疏注意力(Video Sparse Attention)、稀疏蒸馏(Sparse Distillation)等技术,FastWan2.1-1.3B模型在单块H200上5秒生成5秒480P视频(去噪时间仅1秒),在单块RTX 4090上21秒完成。
此次1080p实时管线基于开源模型LTX-2.3构建,将其打造为单GPU上的交互式媒体生成速度引擎,相对于此前次快方案实现了3.9倍的延迟降低。
开源、免费、本地可运行
与Sora、Veo等封闭API服务不同,FastVideo是完全开源的框架,代码托管于GitHub(hao-ai-lab/FastVideo),创作者无需为每次生成支付API费用,不受云端排队限制。Dreamverse演示可通过 dreamverse.fastvideo.org 直接体验。 团队表示,NVIDIA的Dynamo近期也已添加了对FastVideo作为后端的支持,双方合作仍在持续推进中。
团队背景
Hao AI Lab由UCSD助理教授Hao Zhang领导,实验室近期获得了NVIDIA DGX B200系统的支持。该实验室在LLM推理领域有深厚积累,其DistServe等研究概念已被NVIDIA Dynamo等生产级推理平台所采用。实验室获得HDSI、NVIDIA、Google、Snowflake、AMD等机构的赞助支持。
核心贡献者包括Matthew Noto、Yechen Xu、Junda Su、Will Lin(共同牵头),技术负责人为Will Lin、Peiyuan Zhang和Hao Zhang。
为什么这很重要
团队认为,视频生成领域最大的瓶颈已经不再仅仅是模型质量,而是创意迭代过程中被打断的反馈循环。当生成速度跨越实时门槛,AI视频工具从"下单等出片"的模式,转变为"边看边调"的实时创作——更快的反馈、更低的成本、更无缝的创作体验。这可能是AI视频从技术演示走向真正创作工具的关键转折点。
Dreamverse 演示站点: dreamverse.fastvideo.org
FastVideo 项目: github.com/hao-ai-lab/FastVideo
 AI 速览