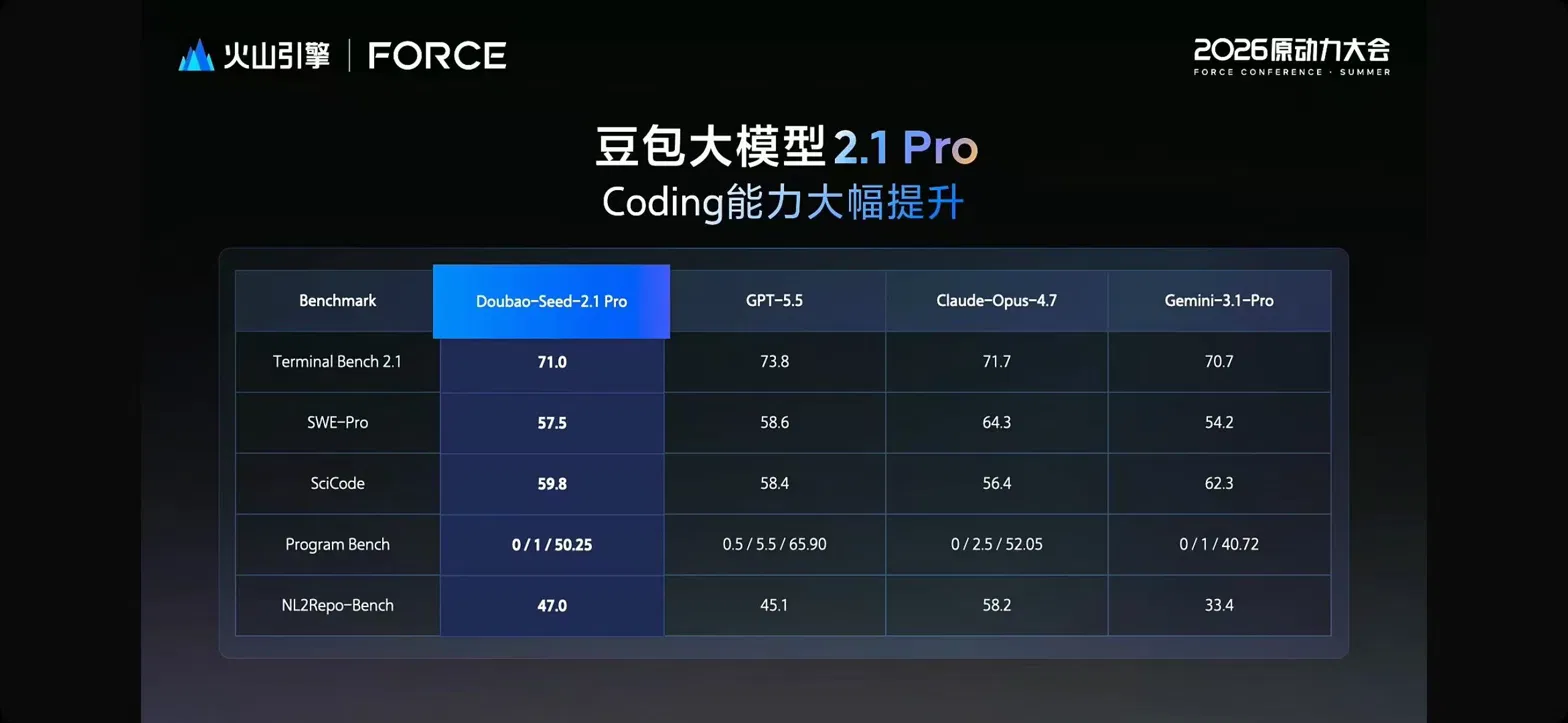
6月23日消息,字节跳动在火山引擎 FORCE 原动力大会·夏上发布豆包大模型2.1 Pro(Doubao-Seed-2.1 Pro)。距2月的2.0发布仅四个月,这次迭代将对标阵营从 GPT-5.2 / Gemini 3 Pro 升级到 GPT-5.5 / Claude-Opus-4.7 / Gemini-3.1-Pro,同时首次展示端到端视频剪辑 Agent——支持2小时以上长视频的剧情理解与一键成片。发布时间恰好卡在豆包App付费上线的窗口期,模型升级与商业化变现同步推进。 Coding:5项测评0个第一,官方用"比肩"而非"领先"
豆包2.1 Pro 在代码方向的定位很清醒——官方措辞是"比肩全球顶尖模型",没有说"领先"。benchmark 数据支撑了这个判断。5项国际代码评测中,2.1 Pro 没有拿到任何一个第一名。
Terminal Bench 2.1 得分71.0,GPT-5.5 以73.8领先;SWE-Pro 57.5,Claude-Opus-4.7 以64.3领先6.8分,是所有测评中差距最大的一项;NL2Repo-Bench 47.0,Claude-Opus-4.7 以58.2领先超过11分;SciCode 59.8 被 Gemini-3.1-Pro 的62.3压过。Program Bench 采用三段式评分(0/1/50.25),GPT-5.5 在最高难度段以65.90甩开全场。
不过官方给出了一个值得注意的工程案例:在芯片设计 RTL 测试中,2.1 Pro 连续运行近18小时,完成6个核心模块共1303行 RTL 代码,经历9轮迭代,跑通仿真、测试、综合检查的完整工程流程。官方称此前完成该任务需要3–5个工程师做数周。这个案例的信息密度高于 benchmark 数字——它展示的不是单点得分能力,而是长链路工程交付的持续性。但单一案例不可外推,且没有竞品在相同条件下的对照数据。
Agent 与 VLM:移动端 GUI 交互领先幅度最大,桌面端仍输 Opus
Agent 方向,官方定位"国内第一,比肩国际顶尖"。演示案例中,2.1 Pro 驱动500+个 Agent 协同完成多模态3D城市构建任务,累计触发工具调用上千次,生成100+栋建筑并完成多轮自我迭代与全景成片。这验证了工具调用密度和多 Agent 协同能力,但同样缺乏标准化 benchmark 和竞品对照。
VLM 方向是数据最硬的一侧。6项评测中拿下5个第一:MobileWorld(GUI-only)73.1,比第二名 Claude-Opus-4.7 的57.1高出16个百分点,是全场领先幅度最大的一项;CharXiv-RQ 85.4(vs GPT-5.5 83.2);MMMU-Pro 81.6(vs GPT-5.5 81.2)。TOMATO 79.5 和 LVBench 78.0 两项视频理解测评中,GPT-5.5 和 Claude-Opus-4.7 未提交成绩,仅 Gemini-3.1-Pro 参与对比。
唯一失守的 OSWorld(桌面操作系统交互):Claude-Opus-4.7 以82.8领先2.1 Pro 的78.8,差距4分。Claude 在 Computer Use 类任务上的优势跨越多个版本保持稳定。
端到端长视频解说成片是 VLM + Agent 的联合展示:一次性解析2小时长视频,自动生成解说文案、精准匹配视频片段,合成配音并适配情绪 BGM,输出带字幕成片。这整合了多模态理解、长记忆、时序推理与工具调用的全链路能力,在当前竞品中没有直接可比的产品化方案。
定价与产品矩阵:Pro 输入6元,比2.0贵87%但比Opus低80%
豆包2.1 Pro 统一定价为输入6元/百万tokens、输出30元/百万tokens,缓存命中1.2元。对比2.0 Pro 的3.2元输入/16元输出(≤32k),2.1 Pro 涨价约87%。但官方对标的不是自家上一代,而是 Claude Opus 4.6–4.8——声称综合使用成本降低近80%。
产品矩阵扩展为三层:2.1 Pro 对标深度推理和长链路 Agent;2.1 Turbo 价格为 Pro 的一半,面向高频调用和规模化部署;Doubao-Seed-Evolving 是持续迭代版本,聚焦 Coding 和 Agent 场景,以每月2–4次的频率更新,开发者无需更换 API 接入节点即可获取最新模型。
Evolving 的设计思路值得展开——它本质上是把模型版本管理从"大版本发布"转向"持续交付",对标的是 OpenAI 在 GPT-4 系列上做过的静默更新模式。区别在于字节把"持续更新"显性化为产品承诺,而非暗箱操作。对依赖 API 的企业客户来说,这意味着能力增长不需要迁移成本,但也意味着模型行为可能在不通知的情况下发生变化——稳定性与迭代速度之间的取舍需要开发者自行判断。
不确定性:三个维度
Benchmark 选择性展示。 2.0发布时主打的 HLE-Text(54.2分全球最高)、IMO/ICPC 竞赛金牌等推理类测评在2.1 Pro 的 slide 中完全缺席。是进步太小不值得展示,还是有退步?无法判断。VLM 测评中 TOMATO 和 LVBench 缺少 GPT-5.5 和 Claude 的成绩,横向对比不完整。同时,Agent 方向仅有工程案例展示而没有标准化评测数据,"国内第一"的定位缺乏公开可验证的依据。
代码方向的实际差距。 SWE-Pro 的57.5 vs Claude-Opus-4.7 的64.3,6.8分差距在真实开发场景中可能意味着能否独立修复一个中等复杂度的 GitHub issue。NL2Repo-Bench 差距更大(11分)。对于通过火山方舟 Coding Plan 使用 TRAE / OpenClaw 的开发者,这个差距在日常体验中的影响取决于任务分布——但纯数据看,Claude 在真实代码修复场景上的优势仍然稳固。谭待在发布会上主动将 Claude Opus 4.6 定义为"质变点"的标杆,某种程度上也确认了字节自身对这个差距的认知。
付费化的竞争环境。 据36氪报道,豆包计划在 FORCE 大会期间正式上线付费内容(标准版68元/月至专业版500元/月)。2.1 Pro 为付费化提供了"模型值这个价"的叙事支撑。但腾讯元宝和阿里千问目前均未公布收费计划。在竞品免费、VLM 领先但代码不领先的格局下,用户是否愿意为差异化能力付费,是一个未经验证的假设。API 侧"比 Opus 低80%"的定价如果成立,对 B 端开发者的吸引力可能强于 C 端订阅。
 AI 速览