3月19日凌晨,小米扔出三款大模型:负责推理和任务编排的MiMo-V2-Pro、能看能听能行动的MiMo-V2-Omni,还有专做语音合成的MiMo-V2-TTS。官网把这三款模型称为"Agent时代的基础设施",措辞相当自信。
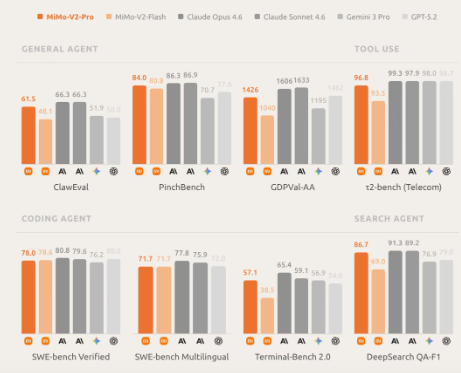
但你要是把Benchmark数据通读一遍,会发现一个有点让人困惑的地方:在通用Agent评测ClawEval上,MiMo-V2-Pro的表现跟Claude Sonnet 4.6、GPT-5.2属于同一梯队,并不是最强那个。Omni的Agent能力也一样,不拔尖。 那小米到底打的什么算盘?
感知、推理、开口
先搞清楚这三款模型各自是什么。
MiMo-V2-Pro是旗舰推理和Agent模型,负责编排任务、驱动复杂工作流。官方的原话是"designed to serve as the brain of agent systems"——是大脑,不是对话框。总参数超过1T,激活参数42B,上下文窗口支持到100万token,比前代MiMo-V2-Flash扩大了大约3倍。
MiMo-V2-Omni是多模态模型,把图像、视频、音频三路编码器塞进同一个骨干网络里。官方给的Demo之一是:输入一段行车视频,模型实时标注出每一帧的危险等级,精确到某个时间点某辆车从盲区并线、需要立即减速。
MiMo-V2-TTS负责语音合成,但不是那种平铺直叙念字的系统,而是能识别文本情绪、自动匹配语调、把叹气和停顿当成原生内容去生成的那种——ALL CAPS会自动加重读音,省略号会让语速拖慢,情绪转折发生在同一句话里也处理得很自然。
三款加在一起:感知(Omni)、推理(Pro)、表达(TTS)。
这不是三个独立产品,而是一套完整的感知-决策-交互系统。说白了,就是机器人、自动驾驶、智能设备需要的那种"脑子"。
Flash是谁的学费
要理解这次发布,得先回到三个月前。
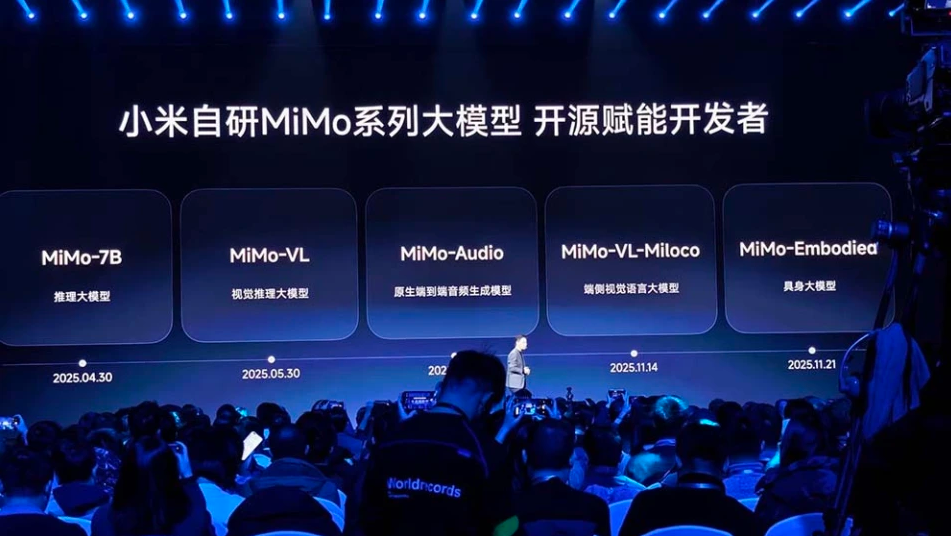
2025年12月,小米发布了MiMo-V2-Flash,完全开源,MIT协议,权重在HuggingFace上谁都能下。总参数309B,激活参数只有15B,体量很小,但SWE-Bench多语言编程评测排开源模型第一,推理速度150 tokens/s,支持256k上下文。
这些数字在开源模型里已经够说了。但Flash更重要的作用不是刷榜,是建生态——高质量的免费开源模型能让开发者进来,让各类Agent框架接入,让更多人习惯在MiMo的API上跑东西。等这批用户跑顺了,3月发的三款商业模型就有了现成的接盘基础。
这是一套经典路线,DeepSeek和Meta都走过:用开源买入场券,用闭源收割商业价值。 小米的不同在于:它的目标用户不只是开发者,还有它自己。
Benchmark里选了哪些对手
MiMo-V2-Pro和MiMo-V2-Omni的基准对比对象是:Claude Opus 4.6、Claude Sonnet 4.6、Gemini 3 Pro、GPT-5.2。 这个对手列表值得琢磨。Anthropic、Google、OpenAI,没有一家有小米规模的硬件出货量。
把自己和它们放在同一张表里,当然有营销成分。但选这些对手,也在暗示一件事:小米认为自己有资格站在那张桌子旁边。
更关键的是,如果它的模型能在推理和多模态能力上接近这几家公司,那在真正的战场上——把AI能力打进小米汽车、小米机器人、小米智能家居——它根本不需要排名第一,只要足够好用就行。
MiMo-V2-Omni的Demo里有个细节:模型能控制浏览器,从小红书浏览帖子,切换到京东比价,完成下单,整个流程端到端由模型驱动。官方在Omni的博客结尾写道:"今天它通过浏览器和终端行动,我们希望它通过双手行动——让机器人不只是理解环境,而是重塑它。"
没有藏。
不够聪明,但已经够用
说回最开始那个困惑:小米的Agent能力在通用评测上并不拔尖。
但"最聪明"从来不是做硬件公司的逻辑。
小米的全球月活跃用户已超过7亿。如果这些用户手里的手机、汽车、电视、扫地机里都跑着一套能感知、能推理、能开口的AI,哪怕每台设备每天只触发一次有效交互,那个量级是任何纯软件AI公司都模拟不出来的。
华为选择了鸿蒙和自研芯片,苹果选择了端侧模型和Apple Intelligence,小米选择的是一套覆盖感知-推理-语音全链路的基础模型矩阵,然后把它塞进每一台能联网的设备里。
对小米来说,真正可怕的未来不是GPT下一代比它聪明,而是另一家手里同样有海量活跃用户的公司,比它先把这件事做完。
目前暂时没有。
 AI 速览