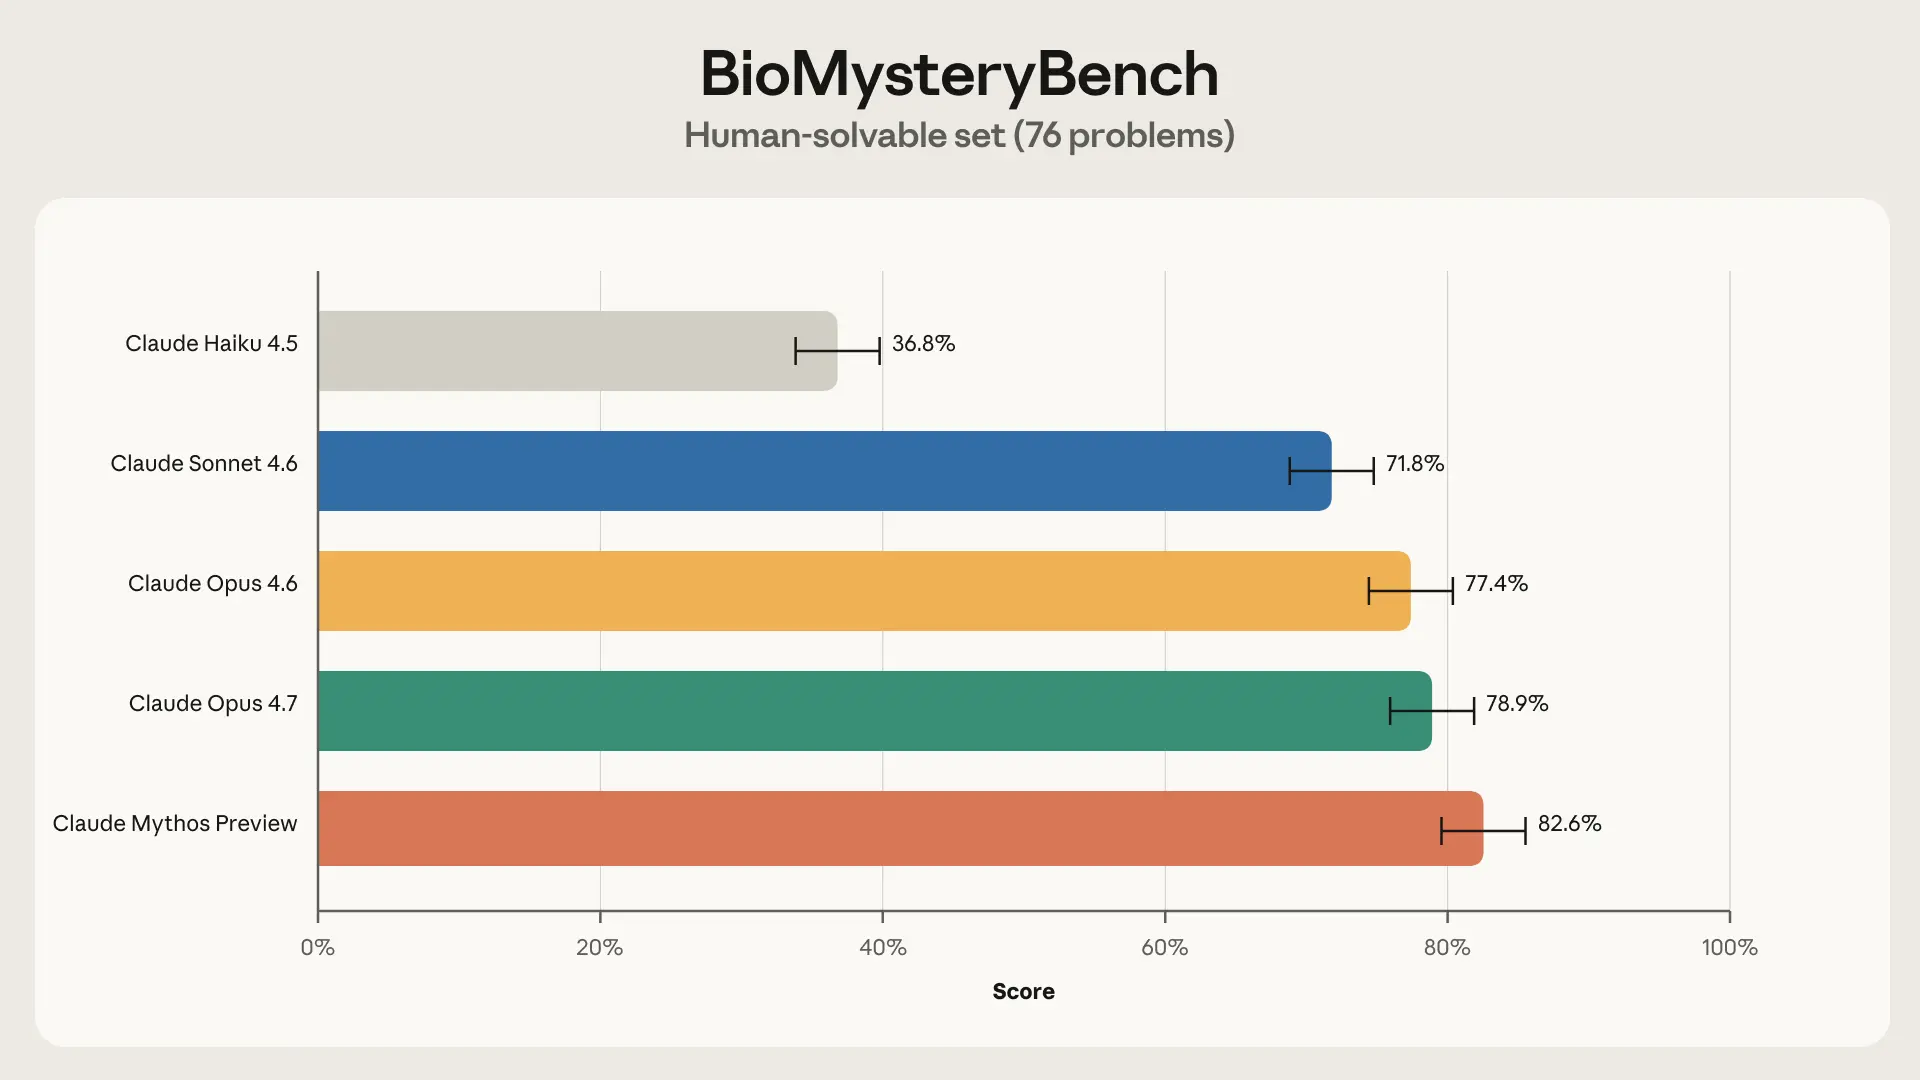
4月30日,Anthropic 发布生物信息学评估基准 BioMysteryBench——99 道由领域专家命题、用真实未处理数据集出题的开放式研究题。最具看点的一个数字是:在专家面板都解不出的 23 道难题上,未公开发布的前沿模型 Claude Mythos Preview 跑出 29.6% 的解决率,Claude Opus 4.7 紧随其后拿下 27.0%。在剩下 76 道人类专家可解的题目上,Mythos 的成绩是 82.6%,Sonnet 4.6 是 71.8%,而轻量级的 Haiku 4.5 只有 36.8%。 这份基准的发布,把 AI 在生物信息学领域的能力评估推到一个新的位置——不再是选择题,不再是已被人类解决过的"金标准"题,而是直接把模型扔到原始测序数据、未经处理的临床样本面前,看它能不能给出可验证的科研结论。
99 道题怎么出:用"答案可验证"换"解法自由"
传统的生物信息学 AI 评估有几个老大难。BixBench 这样的基准把 60 个计算生物学分析胶囊压缩成 205 道选择题,虽然好打分,但和真实科研脱节;GeneBench 走多阶段的科学数据分析路线,GPT-5.5 在上面只拿到 25.0%、Pro 版 33.2%——OpenAI 自己也承认这些题"通常对应科学家的多日项目"。问题在于,真实科研里一道题往往有多种合法解法,人类专家也未必能给出标准答案,主观评分容易把不同的合理路径打成错误。
BioMysteryBench 的设计思路是反过来的:挑那些数据中存在客观可验证属性的研究题——比如某个基因在样本中的表达状态、某段序列的功能注释、某个代谢通路的活性变化——这些答案要么能从数据本身推出,要么有已验证的元数据可以对照。覆盖的数据类型几乎是当前生信全栈:全基因组测序(WGS)、单细胞 RNA 测序(scRNA-seq)、ChIP-seq、宏基因组、蛋白质组学、代谢组学。
模型拿到题目后,可以用任何工具——pip/conda 装包、调用 NCBI、Ensembl 等数据库、写 Python 脚本、跑标准生信流水线,解法路径完全开放。打分只看最终答案是否正确,不看用的方法。这种设计有点像编程竞赛里的"答案校验"模式——过程可以千人千面,结果对得上就行。
99 道题里,Anthropic 邀请最多 5 位领域专家从零尝试解答,76 道至少被一位专家解开,被归为"human-solvable";剩下 23 道经过质量控制确认数据中信号确实存在,但专家面板没能解开,被标为"human-difficult"。
模型成绩从 36.8% 拉到 82.6%,代差肉眼可见
在 76 道人类可解题上,几代 Claude 模型拉开了非常清晰的能力梯度:Haiku 4.5 作为轻量模型只解开 36.8%;Sonnet 4.6 跳到 71.8%——这意味着大部分常规生信分析任务上,Sonnet 已经接近或追平人类专家中位数;Mythos Preview 拿下 82.6%,在很多任务上超过专家。
Anthropic 在博客里特别提到模型展现出和人类不同的解题策略。一种被称为"知晓一切"模式:模型不走经典生信流水线,而是把内部记忆里的结构生物学知识、文献片段、数据库注释直接拼接,跳过中间步骤;另一种是"多方法融合求证",模型同时跑两到三种独立路径,用结果一致性来做交叉验证。这两种策略在人类专家身上不太常见——人受时间和工具切换成本约束,通常会先押注一条最熟悉的路径。
不过 76 道题上的表现只是基线。真正撬动行业讨论的是 23 道专家无解题上的成绩。Mythos 解开 29.6%、Opus 4.7 解开 27.0%——前提是,这些题已经被多位专家试过、确认数据中信号存在但人解不出来。换句话说,这是模型在"超人类边界"上的初步穿透。
Anthropic 自己对这个数字也没有过度乐观。博客里强调,可解题上的表现是"高度可靠的"——多次重跑结果一致;但难解题上的成功具有明显"脆性",部分正确答案是模型撞上了一条"运气路径",换个 prompt 或随机种子就跑不出来。也就是说,30% 这个数字是上限,不是稳定能力。
和 BixBench、GeneBench 的差别:测什么决定了能比什么
BioMysteryBench 不是第一个生信 AI 基准,但它选的赛道和现有评估有明显错位。
BixBench 由 FutureHouse 团队维护,205 道选择题压在 60 个分析胶囊里,GPT-5.5 在 4 月 23 日发布时跑到 80.5%,GPT-5.4 是 74.0%——这个分数看着高,但本质上测的是"在给定选项里挑对",和真实科研里"从一堆原始数据里推出结论"是两件事。GeneBench 难度更高,GPT-5.5 25%、GPT-5.5 Pro 33.2%、GPT-5.4 仅 19%,主要测多阶段基因组分析,但题目仍然偏结构化任务,答案口径相对收敛。
BioMysteryBench 的差异化在于"原始数据 + 开放解法 + 客观答案"这套组合。模型拿到的是 fastq 文件、count matrix、peak 文件这种生信日常输入,不是预处理过的简化版本;解法没有引导;评分只认结果。这套设计逼着模型必须真的会"做生信",而不是会"答生信题"。
横向比对会发现一个有意思的现象:GPT-5.5 在 BixBench 上 80.5%、GeneBench 上 25%,Mythos 在 BioMysteryBench 可解集上 82.6%、难解集上 29.6%——单看数字,几个模型在不同基准上的相对表现差不多在同一档。但 BioMysteryBench 的难解集是别的基准没有覆盖的维度——它直接把"AI 能不能解决人类专家解不了的科研问题"摆上桌。
生态层面,Claude 在生物领域已经跑出了一批落地案例。斯坦福的 Biomni 基于 Claude 构建,把可穿戴设备的生信分析从 3 周压缩到 35 分钟(800 倍),在 LAB-bench DbQA、SeqQA 上达到人类水平,设计的克隆实验在盲测中被评为相当于 5 年以上专家工作。Benchling 把 Claude 接入 Amazon Bedrock 服务生命科学客户;FutureHouse 用 Claude 跑科学发现 agent。这些案例和 BioMysteryBench 形成了印证关系:基准上的成绩,在真实研究场景里有对应的产能输出。
"超人类"的边界还很模糊
30% 解决专家无解题听起来很惊人,但要小心几个解读上的陷阱。
第一,人类专家组不是无限专家。每题最多 5 人尝试,这 5 人可能在该题领域不是最顶尖的,而是 Anthropic 能招到的"领域熟手"。如果换成全球 top 5% 的某个细分子领域专家,无解题数量很可能少于 23 道,模型表现也会被重新校准。
第二,"运气路径"的脆性意味着模型在难解题上的能力还没固化。同样的题让 Mythos 跑十次,可能只成功两次,而且每次的解法都不一样。这种"间歇性闪光"在真实科研里不能直接当成能力——研究员需要可复现的方法,不是偶发的灵感。
第三,客观可验证的答案设计本身有筛选偏差。真正困难的科研问题往往答案模糊、需要多方证据综合,这类题目根本进不了 BioMysteryBench 的题库。所以 30% 这个数字测的是"答案唯一且可验证"的难题里 AI 的穿透率,不是所有难题。
第四,与 GPT-5.5 在生物领域的横向对比目前还缺数据。Anthropic 没在 BioMysteryBench 上公开 GPT-5.5、GPT-5.5 Pro 的成绩,反过来 OpenAI 也没在 BixBench/GeneBench 上发 Claude 系列的数据。两边各自在自己更擅长的基准上发布数字,真正的横向对比要等独立第三方评估。
实操选型怎么看
BioMysteryBench 公布后,生信团队选模型时几个判断点变了:
如果是常规生信流水线任务——质控、比对、peak calling、差异表达——Sonnet 4.6 的 71.8% 已经能覆盖大部分日常工作,加上它在 Claude Code 里的低延迟和性价比,基本是首选。Haiku 4.5 的 36.8% 决定了它只适合做轻量任务和数据预处理,核心分析不要交给它。 如果要做开放式科研探索、需要模型给出非常规假设和多路径验证,Opus 4.7 在难解题上 27% 的成绩说明它已经具备穿透专家盲点的潜力。Mythos Preview 因为没有公开发布,只能通过 Anthropic 的 Glasswing 合作项目接触到——拿不到的话,Opus 4.7 是次优选。
对纯查询和结构化生信问答场景,GPT-5.5 在 BixBench 上的 80.5% 和 GeneBench 的 25% 仍然是有竞争力的选项,尤其是结合 Codex Security 这类工具链时。但凡涉及到从原始数据出发的开放式分析,Claude 在 BioMysteryBench 上展示的能力曲线更值得参考。
最后一个常被忽略的点:BioMysteryBench 测的是"模型能不能解题",不是"模型能不能在科研流程里和人类协作"。真实生信研究里,AI 的价值往往不是独立解题,而是把研究员的 3 周工作压到 35 分钟——Biomni 那种用法,可能比 30% 解开专家无解题更接近大多数实验室能直接受益的形态。
 AI 速览