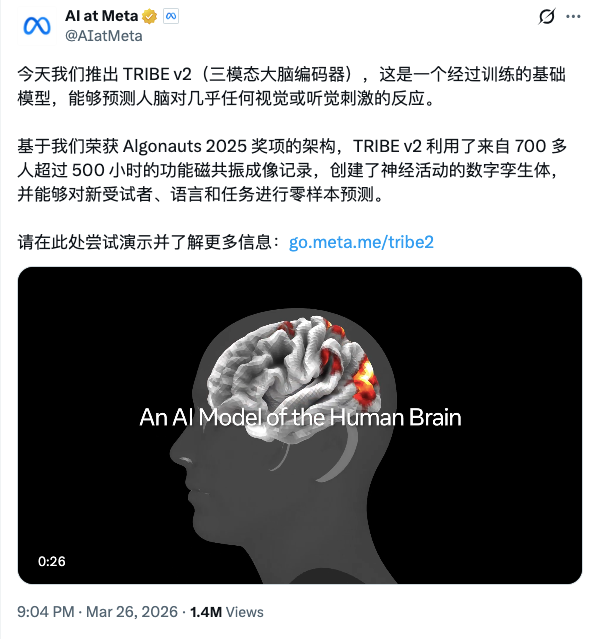
3月27日消息,Meta 正式推出 TRIBE v2,一个经过训练可预测人类大脑对几乎任何视觉或听觉刺激如何响应的基础模型。该模型由 Meta FAIR(基础AI研究)巴黎团队开发,模型、代码库和演示 demo 已全部向研究社区开源发布,以加速神经疾病治疗领域的突破。
从竞赛冠军到基础模型
TRIBE v2 建立在 TRIBE v1 的基础之上。此前 Meta FAIR 的 Brain & AI 团队凭借 TRIBE(TRImodal Brain Encoder)在 Algonauts 2025 脑建模竞赛中获得第一名,从263支参赛队伍中脱颖而出。TRIBE 是首个经训练可跨多种模态、多个皮层区域和多个个体预测大脑响应的深度神经网络。
该方法整合了 Meta 旗下多个基础模型的预训练表征——文本使用 Llama 3.2,音频使用 Wav2Vec2-BERT(来自 Seamless),视频使用 V-JEPA 2,通过 Transformer 架构处理这些时序演变的多模态信息,精确建模大脑对视频刺激的时空 fMRI 响应。
v2 的核心突破
TRIBE v2 的训练数据涵盖超过 700 名个体,累计超过 1115 小时的训练材料,相比 v1 大幅扩展了数据规模和多样性。
关键技术进步包括:
无需任何重新训练,TRIBE v2 就能可靠预测从未见过的新个体的大脑响应,在电影和有声书场景中均实现了比此前方法高出近2-3倍的性能提升。该模型相比前代系统实现了70倍的空间分辨率提升,使研究者能够以更精细的粒度观察预测的神经活动模式。
消融实验显示,单模态模型虽然可以可靠预测其对应的皮层网络(如视觉网络或听觉网络),但在高级联合皮层区域,多模态模型系统性地优于单模态模型——这表明大脑对复杂刺激的处理本质上是跨模态整合的。
"计算机内神经科学"的新范式
TRIBE v2 创建了神经活动的"数字孪生体",使科学家能够以物理 fMRI 实验成本的一小部分运行数千次虚拟实验。Meta 将这一方向称为"in-silico 神经科学"——通过计算机模拟而非活体受试者来进行生物学研究。
该模型的"零样本"能力意味着它可以预测新个体甚至未见过的语言的大脑活动,无需重新训练。这对于大规模神经科学研究和神经疾病诊断具有深远意义。
局限与边界
fMRI 数据相比实际神经元放电速度具有较低的时间分辨率,模型处理的是间接的、经过平均化的脑活动测量。个体在认知、注意力和情绪状态上的差异也会引入难以完全捕获的噪声。目前该模型聚焦于编码(预测大脑对输入的反应),而非解码(读取私人思想),距离科幻意义上的"读心术"还很遥远。
开放科学承诺
Meta 已将 TRIBE v2 模型、代码库和演示向全球科学社区开放发布,研究者可通过 GitHub(facebook research/algonauts-2025)获取代码,并在 Meta 的 AI Demo 平台体验在线演示。
 AI 速览