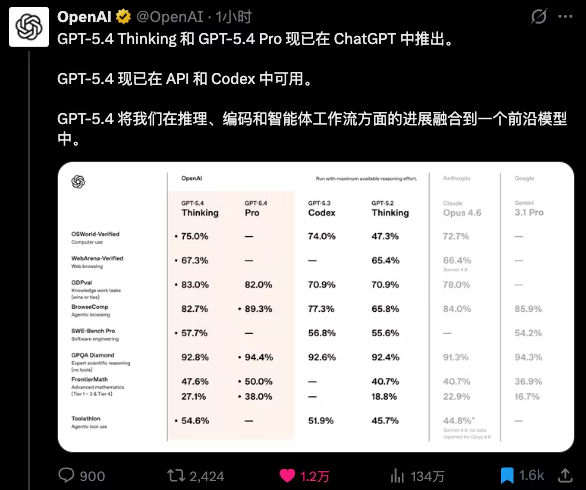
如果非要用一句话形容GPT-5.4,"撸起袖子干活的学霸"这个标签其实挺准的。GPT-5.4在2026年3月5日正式发布Sznews,OpenAI将其定位为目前面向专业工作推出的能力最强、效率最高的前沿模型之一Tencent Cloud。这一代没有搞什么颠覆性的大招,而是把该补的短板一一补上,然后在效率和Agent能力上做了相当扎实的升级。
这次升级的核心逻辑
GPT-5.4整合了GPT-5.3-Codex的前沿编程能力,同时在工具调用、软件环境操作以及涉及表格、演示文稿和文档等专业任务的处理方式上都有改进。Sznews这意味着你不再需要在通用模型和代码专精模型之间做取舍,一个模型把两件事都干了。
OpenAI对推理效率的执念由来已久。他们认为真正聪明的人不是靠"想得更久"来解决问题,而是靠对复杂问题的有效分解、精准洞察和果断决策。从GPT-5到5.4,这条路线一直没变,只是越走越深。
改进的地方
Token效率是这次升级最值得说道的一块。GPT-5.4是迄今为止OpenAI最省Token的推理模型,解决同样的问题,消耗的推理Token比GPT-5.2少得多Sznews——平均下来压到了17K左右,大幅低于同级别竞争对手。但要说清楚:这不是所有问题都更省,而是模型学会了更有效地分配算力。遇到复杂问题或条件繁多的指令,GPT-5.4照样会跑到40K甚至接近80K;但在不太需要智力、主要考验专注度的上下文类任务上,消耗就明显低于5.2,尤其是数学计算,极端情况下只有上一代的一半。
与此同时,GPT-5.4还引入了Tool Search机制,重构了工具调用的方式。以前给模型配工具,所有工具定义都得塞进prompt里,工具一多光定义就能吃掉上万Token。新机制让模型按需查找工具定义,在工具密集型工作流中能大幅降低Token消耗,同时也更快。Zhihu
指令遵循方面,作为面向Agent开发的模型,GPT-5.4在复杂多条件场景下可以稳定遵循几乎全部指令,但多轮工况下基本和上一代持平,没有质的飞跃。
可读性这个点看起来不起眼,但实际用起来体感差别挺明显的。从GPT-5到5.2,如果没有特别要求,模型给的答案往往就是冷冷的几个字。GPT-5.4 Thinking现在会先给出一个思考计划,你可以在它回答的过程中随时插嘴、补充信息、调整方向,模型会把新指令融入进去继续生成Sznews,输出里也默认带上了一定的过程解释。当然,GPT-5.4对"过程要写多详细"这件事还把握得不太稳定,有时精炼,有时冗长,偶尔还会带着推理草稿一起甩出来。
没解决的问题
GPT-5.4和Claude Opus 4.6是2026年3月最强的两个模型,各有擅长领域,但GPT-5.4自己也有明显短板。 上下文幻觉比预想中复杂。GPT-5.4在Codex和API中支持最高100万Token的超长上下文Sznews,这是个很大的上限,但在实际使用中,5K、10K长度的信息抽取测试里都会出现问题,每一轮会错几处,而且每轮出错的位置还不同Zhihu。哪怕文本不长,也有一定概率疏忽,这在Agent模式下尤其棘手——需要智力不高但中间步骤特别多的任务,稳定性会明显下滑。
洞察力方面,GPT-5.2这块就比GPT-5和5.1弱,5.4有所恢复,但还没回到自己的最好水平。背后的原因大概是:5.1靠消耗大量Token来跑高分,而5.4为了省Token,在训练阶段就注入了"不要过度发散"的倾向。OpenAI还没找到在较低Token预算下保留较高直觉洞察的方法,这条路仍在摸索中。
复杂计算也出现了问题。或许是受幻觉影响,GPT-5.4在长步骤复杂计算时,错误率比上一代有所上升,下限很差,几乎不像GPT系列该有的表现。
把这些放到更大的背景下看,OpenAI和Anthropic的路子正在越来越明显地分叉。OpenAI不遗余力地推进自家Codex桌面版,GPT-5.4与Codex深度结合,成为桌面Agent场景的重要驱动力Sznews,野心和方向已经很明朗。
GPT-5.4在定价上也给出了压力,API标准输入15/百万Token Workbuddycn,约为Claude Opus 4.6输出Token成本的40%。考虑到Agent应用本来就是Token黑洞,这个降本幅度对推动实际落地的意义不小。 GPT-5.4不是什么超级大招,就是一次带有明确应用倾向的常规升级。但这已经够了——对于正在爆发的Agent市场来说,再浇一桶汽油,火还会更旺一些。
 AI 速览