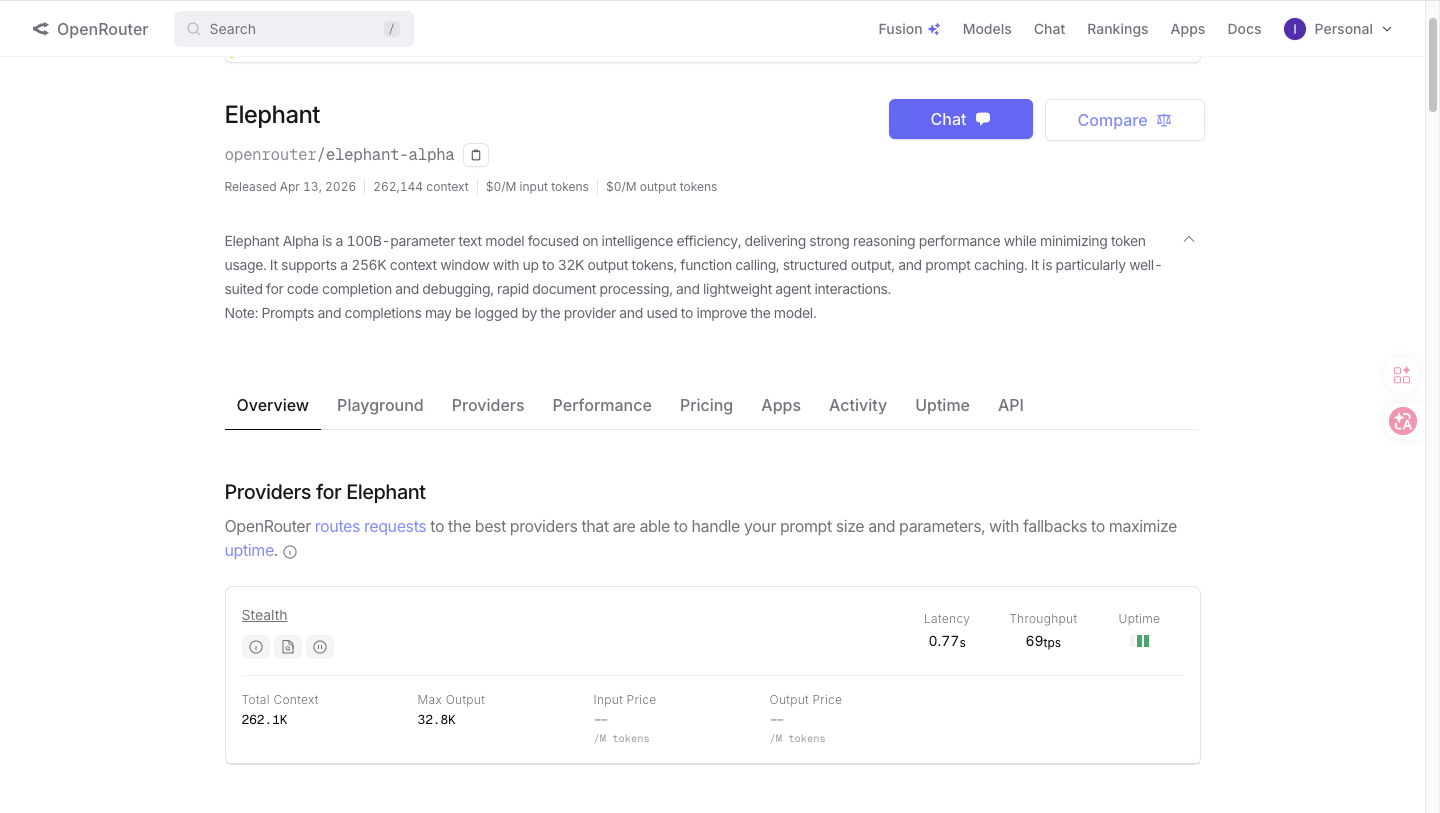
4月14日消息,OpenRouter以"stealth"方式上架Elephant Alpha,一个100B参数的纯文本模型。据OpenRouter模型页面描述,该模型来自"一家知名开源模型实验室",核心卖点是"智能效率"——在保持同规模SOTA级推理能力的同时,显著降低token消耗。模型当前完全免费(输入/输出均为$0/百万token),支持256K上下文窗口、最大32K输出token、函数调用、结构化输出和提示缓存。 定位与技术规格:效率优先的"instant"模型
Elephant Alpha被定义为"instant"模型,与追求参数量和推理深度的前沿大模型走不同路线。据Kilo AI博客的介绍文章,该模型的设计目标是在100B参数规模上实现与SOTA模型可比的性能表现,同时大幅减少完成相同任务所需的token数量——这意味着更低的延迟和更低的实际使用成本。
OpenRouter模型页面列出的官方适用场景包括三类:代码补全与调试(快速生成逻辑连贯的代码建议)、大规模文档处理(利用256K上下文处理长文本而不产生大模型典型的高延迟)、轻量级Agent交互(适配快速迭代的智能体工作流)。
技术规格方面,256K上下文窗口足以加载完整代码仓库或大型依赖树,32K最大输出支持单次生成完整模块或测试套件。提示缓存功能可在重复性长上下文任务中降低延迟和成本。函数调用与结构化输出能力使其可直接接入Agent工具链。
需要注意的是,OpenRouter明确标注:stealth预览期间,用户的提示和补全内容可能被模型提供方记录并用于模型改进。这是OpenRouter所有stealth模型的通用条款,但对处理敏感数据的场景构成明确限制。
OpenRouter stealth模型的运作模式
Elephant Alpha是OpenRouter stealth模型系列的最新一员。OpenRouter的stealth发布机制已形成固定模式:模型提供方通过OpenRouter匿名上架未公开的模型,隐藏真实名称和所属机构,以获取社区无偏见的使用反馈和测试数据,测试期通常免费开放。
Elephant Alpha的100B参数规模将猜测范围缩窄到中小体量开源模型。LINUX DO社区讨论中,用户排除了Kimi K2(1T参数)和GPT-5.5(2T以上)的可能性,有用户实测后评价"速度很快,性能一般,感觉最多是个nano级模型"。Kilo AI博客将其定位为Giga Potato(此前另一个热门stealth模型)的互补——Giga Potato擅长深度文档生成,Elephant更适合快速文档处理和日常驱动。 效率路线的竞品格局
Elephant Alpha所代表的"效率优先"路线在当前模型竞争中越来越受关注。
在100B左右的参数规模上,NVIDIA Nemotron 3 Super(120B参数,MoE架构仅激活12B)同样走效率路线,面向多Agent应用场景优化,目前也在OpenRouter免费可用。Mistral的中等规模模型(如Mistral Medium/Large系列)在欧洲市场占据效率定位。国内方面,阿里通义千问的Qwen系列在中小参数规模上以效率著称,字节的豆包系列同样强调推理速度。 与追求极限参数量的旗舰模型(如Hunter Alpha的1T参数、GPT-5.4的超大规模)形成对比,Elephant Alpha的100B+效率优化路线瞄准的是高频调用、成本敏感的实际生产场景——Agent每天执行数百次工具调用时,单次调用的token消耗和延迟直接影响总成本和用户体验。
开发者可通过OpenRouter API(兼容OpenAI SDK)直接调用Elephant Alpha,模型ID为openrouter/elephant-alpha。Kilo Code用户可在VS Code扩展、CLI和KiloClaw中通过模型选择器搜索"Elephant"使用。
 AI 速览