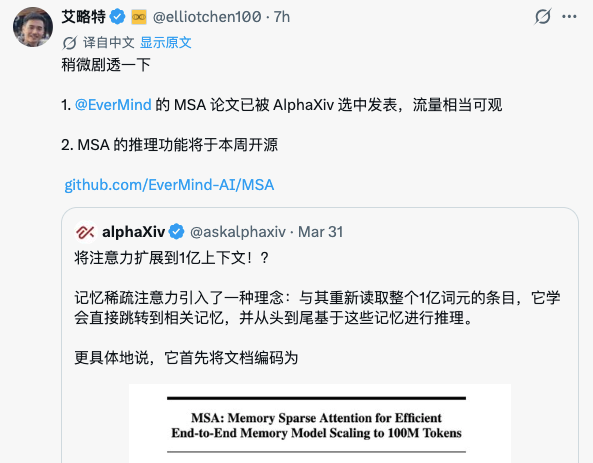
4 月 1 日消息,EverMind-AI 团队围绕大模型长上下文与记忆机制提出的 MSA(Memory Sparse Attention) 论文已在 alphaXiv 等平台上线展示。据项目方介绍,该稿在平台上获得了可观的阅读与传播;同时,MSA 的推理(inference)相关能力计划在本周内于 GitHub 开源,仓库地址为:https://github.com/EverMind-AI/MSA
公开可查的论文预印本亦可在 arXiv 检索(例如编号 2603.23516 条目,标题与 MSA 长记忆框架相关),便于读者对照技术细节与实验设置。
MSA 在解决什么问题
MSA 面向的是大语言模型在超长上下文与长期记忆场景下的效率与可扩展性:在上下文长度急剧拉长时,全量注意力带来的计算与存储压力会快速上升。MSA 一类「记忆稀疏注意力」路线,通常试图在可训练的稀疏记忆选择机制上做文章,以在控制复杂度的同时尽量保留对远端信息的有效利用。具体架构、训练目标与评测基准,应以论文全文与后续开源实现为准。
alphaXiv 与论文传播
alphaXiv 作为面向研究者的论文浏览与分发渠道之一,会对部分稿件给予版面或推荐层面的曝光。项目方称本次 MSA 论文在该平台获得了较好流量表现;需要注意的是,不同渠道的推荐逻辑、统计口径与时段波动较大,「流量可观」更适合理解为阶段性传播反馈,不宜直接外推为学术影响力或商业结果的结论。
本周开源:读者可以期待什么
EverMind-AI 方面表示,MSA 的推理功能将在本周内开源。对开发者而言,可优先关注 GitHub 仓库的 Release、README 与文档 是否给出:支持的模型形态、依赖环境与显存/内存建议、与论文实验是否对齐的推理示例,以及是否包含权重或仅代码框架。
值得关注的是,「开源」常分阶段推进(例如先推理后训练、或先部分模块后全栈),实际覆盖范围应以仓库提交记录与说明为准;若本周截止前未看到预期更新,属于常见节奏差异,建议以官方说明替代猜测。
局限与核实建议
MSA 在长上下文基准上的具体得分、与 RAG 或长窗口模型的对比结论,均受数据集、模型规模与评测协议约束,引用数据时应回到论文表格与附录。本文所涉alphaXiv 流量、推荐形态等未做独立第三方统计核实,仅转述项目方公开表述。投资、选型或复现决策,建议结合自有业务数据与实测结果。
 AI 速览