- Scroll 是 QwenPaw(AgentScope 团队开源,Apache-2.0,GitHub 34k+ stars)内置的检索驱动上下文管理器,2026-07-10 随 QwenPaw v2.0.0 发布,默认启用。
- 与压缩/摘要方案不同,Scroll 用 append-only Event Log(SQLite history.db)逐字保留会话历史,官方表述为 "nothing summarized away"——没有任何内容被摘要掉。
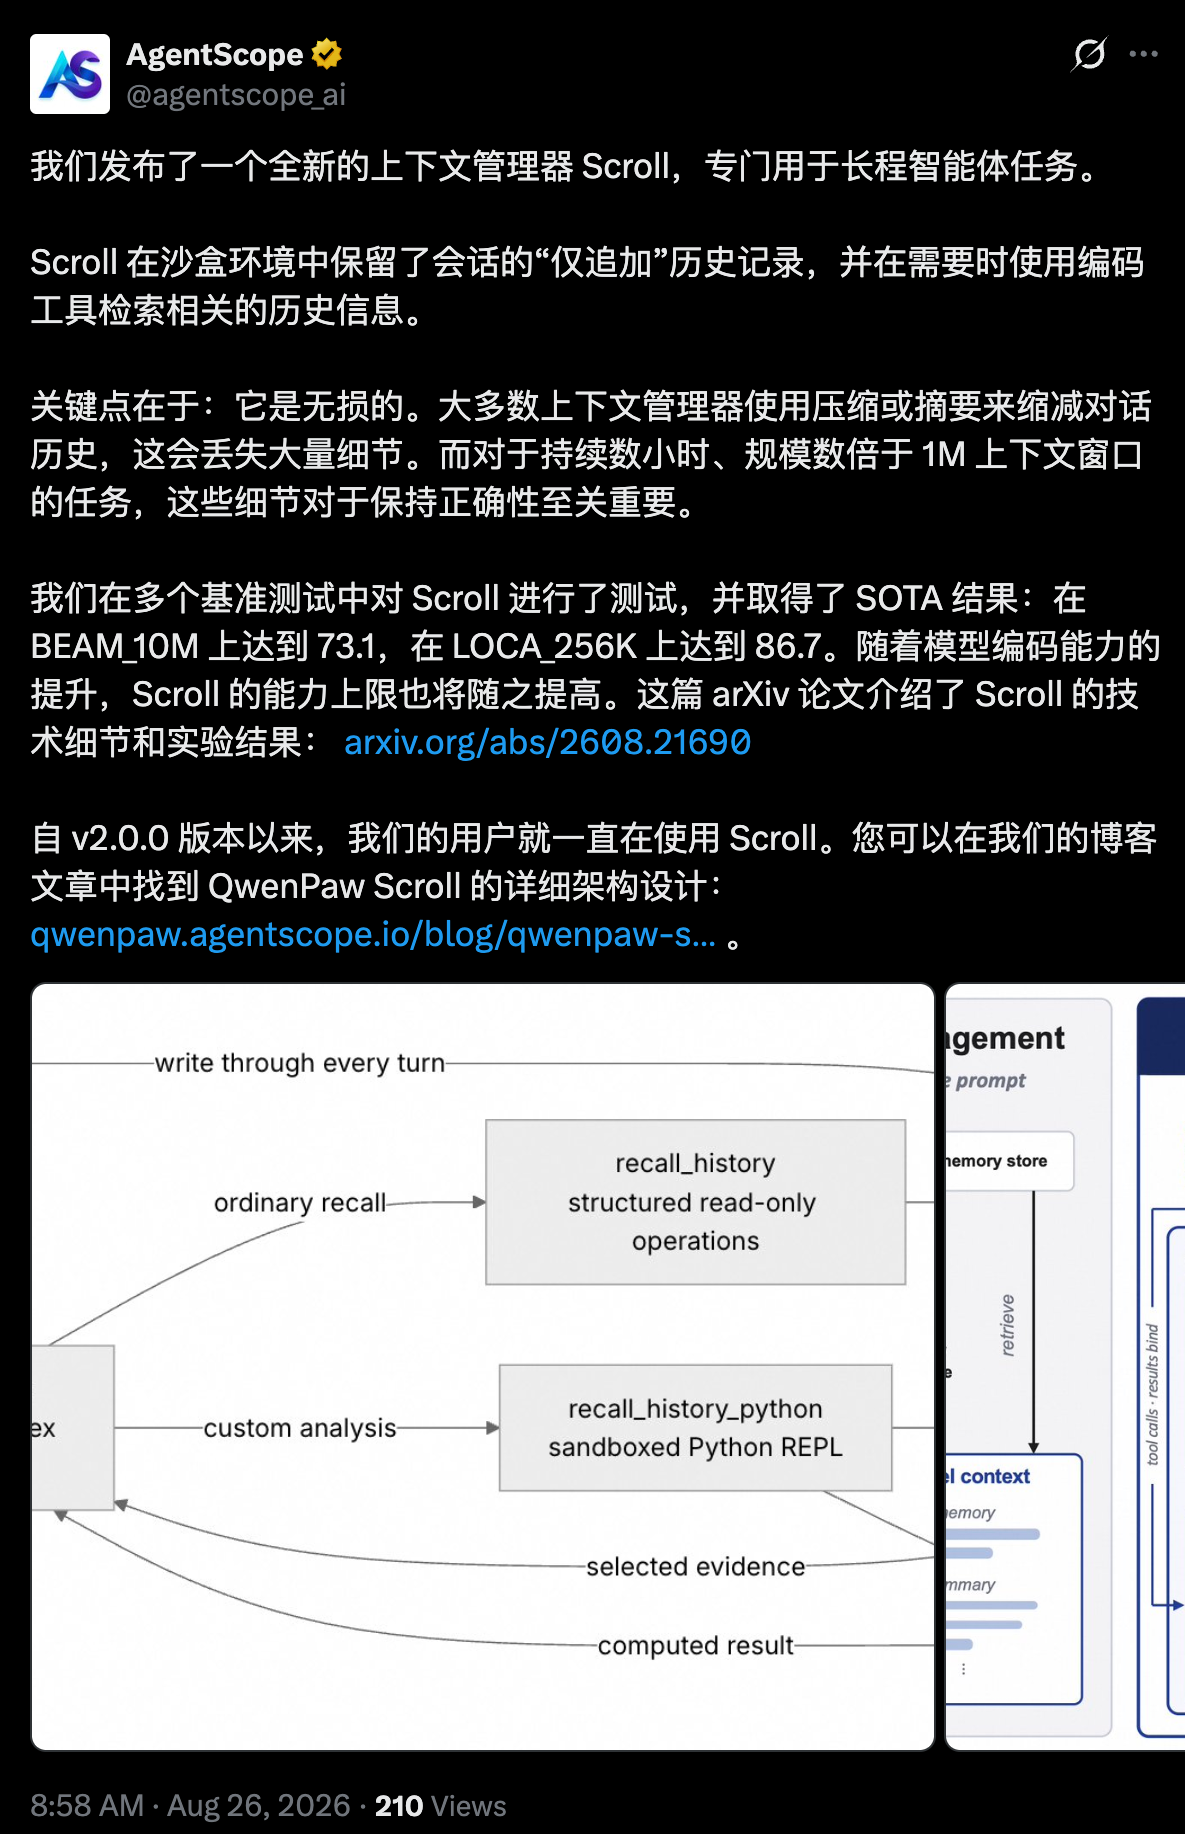
- 模型上下文窗口只是持久化历史之上的有界 working view;历史通过结构化 recall_history 或沙箱内 recall_history_python(预绑定 ms 接口)按需恢复。
- 以 Qwen3.8-Max 为 backbone,官方报告 LongMemEval_S 94.8、BEAM_10M 73.1(比此前 SOTA 高 5.1)、LOCA_256K 86.7(比此前 SOTA 高 37.4)。
- 技术细节与实验见 arXiv 2608.21690《Context as an Environment: Programmatic Context Management for Long-Horizon Agents》;发布仅数周,独立第三方评测尚缺。
Scroll 是什么:把上下文从"容器"变成"环境"
做过长程智能体任务的人多半经历过这种困境:任务跑到第 8 个小时,累计的工具调用、报错记录和中间决策已经塞满上下文窗口。传统做法是压缩或摘要早期内容,但压缩发生在"未来需要什么"尚不可知的时间点——一条精确报错、一个被否决的方案,都可能成为后续 3 小时任务里的关键证据,而摘要早就把它丢了。
Scroll 给出的答案是换一个比喻:上下文不再是一个必须装下全部历史的容器,而是持久化历史之上的一个"工作区"。输入是完整的会话历史,输出是模型每一步实际看到的有界上下文,外加一条随时可以精确恢复完整历史的路。历史本身被逐字保存,模型只处理投影出来的那部分。
具体链路是:每一轮对话(user 指令、模型回复、工具调用与结果)先追加写入 durable Event Log,再进入模型视野;当视野接近预算,较早的区段被移出窗口,但通过索引导航和按需检索仍然可恢复。上下文管理从"压缩"变成了"检索与计算",这正是 Scroll 论文标题里"programmatic context management"的含义。
核心技术一:append-only Event Log——无损历史的地基
压缩式方案的根问题是决策提前:系统必须在写入时就判断哪些细节值得保留。Scroll 把这个问题绕开了——它不判断。所有事件以追加方式写入 SQLite 的 history.db(conversation_history 表),每条记录有全局稳定的 seq 地址、会话/智能体范围、事件类型、时间戳和恢复元数据;超大工具输出不塞进数据库,而是以文本文件存入 tool_results/,消息里只留有界 preview 和指向完整文件的恢复信息。关键词检索走 FTS5 全文索引(BM25 排序),不支持时降级为 LIKE 扫描。
写入路径是 write-through:live turn 必须先成功持久化,才允许被移出窗口。如果写入失败,QwenPaw 会拒绝驱逐,避免生成指向不存在记录的恢复指针。这有点像数据库的 WAL(预写日志)——先落盘、后可见,保证任何时刻历史都是完整可恢复的 ground truth。
这套设计的代价也很直白:存储持续增长。默认 history_retention_days 为 30 天(可设 0 永久保留),需要自己配 retention 策略。但"存储增长"换来的是一份可以任意 join、过滤、聚合的原始事实,而不是一份被固定观点污染过的摘要。
核心技术二:CodeAct 按需检索 + eviction index——把上下文管理变成编程任务
历史无损保存只是第一步,难的是如何找回。Scroll 把窗口之外的恢复拆成两层互补视图:eviction index 负责"导航",continuation summary 负责"当前任务状态"。
导航层用 headline 机制:模型在每个有实质任务的回复后追加一条隐藏的语义摘要(如"模型发现修复|进行中:OpenAI 已完成;下一步:修复 DashScope|锚点:AllowlistFilter、registry.py"),持久化后与稳定的 seq 绑定。历史被移出窗口后,Agent 看到的是 compact 的 headline 列表,先定位相关区段,再按 seq 精确展开——类似先看 git log 再 git show commit,而不是在整份历史里盲搜。continuation summary 则明确只是"由证据支撑的 state cache",通过增量更新、固定 schema、provenance 校验、最多修复一次等机制限制摘要漂移(snowballing),它永远不替代原始历史。
恢复侧是 CodeAct 风格:recall_history 提供参数化的只读操作(expand、search、recall_tool、days_between),不依赖沙箱;沙箱可用时提供 recall_history_python,让模型自己写 Python,通过预绑定的 ms(MemorySpace)接口对历史做 SQL、join、聚合,然后只打印有界结果。比如一次检索可以取回 200 条候选,按 seq 排序后只保留最后 20 条输出。输出有明确上限且没有 cursor,程序必须在返回前完成过滤或分页;跨多次检索的分析可以写入 scratch table 持久化。因为模型代码在沙箱中运行,默认 fail closed——allow_unsandboxed 保持 false,沙箱配置缺失时该工具拒绝执行,而不是裸跑宿主代码。这里有损的只有导航视图(headline 粒度变粗),底层 Event Log 始终逐字可恢复。 效果与边界:benchmark、适用场景与已知局限
官方以 Qwen3.8-Max(阿里云千问 2026 年 8 月发布的旗舰模型)为 backbone 报告了三项结果:
| | |
|---|
| | |
| | 10M token 会话规模,比此前最佳记忆系统高 5.1 |
| | 256K trajectory 端到端完成,比此前最佳 long-horizon agent 高 37.4 |
这些数字需要放在正确的位置看:它们是官方自报,37.4 分的领先幅度取决于官方选定的 baseline;同时机制上的优势是清晰的——不依赖摘要就没有摘要漂移,历史越长,这种优势越明显。官方也明确表示,Scroll 的能力上限随模型编码能力提升而提升:检索逻辑本身就是模型写的代码,编码越强,检索越准。
适用场景:需要跨数小时、跨多会话续接的开发/调试/研究任务,反复依赖早期精确细节(报错原文、否决方案、具体日期)的任务,以及历史规模逼近或超过 1M token 窗口的任务。局限性同样要看清:完全依赖沙箱环境执行模型代码,部署成本比纯压缩方案高;没有沙箱时只能退化为结构化 recall_history;存储会持续增长,长历史需要 retention 治理。截至 2026 年 8 月下旬发布仅数周,尚未看到 Scroll 独立的第三方评测或社区翻车案例整理,这部分证据缺口留待观察,本文不补造。
快速上手:安装、启用与最小配置
Scroll 不需要单独安装——它随 QwenPaw 发布,且是默认的上下文管理策略(源码中 LightContextConfig.strategy 默认 scroll,native 才是 AgentScope 传统压缩)。前提是 Python >= 3.11 且 < 3.14,并准备好模型 API key。
启动后与智能体进行几轮带工具调用的对话,然后确认持久化历史已创建(工作区目录按官方约定):
沙箱可用时,你可以在对话中让智能体用 recall_history_python 对历史做程序化检索,例如让模型自己写代码筛选并打印有界结果(模型实际执行的是类似这样的逻辑):
按需调整的配置项包括:history_retention_days(默认 30,设 0 为永久保留)、repl_timeout_s(recall_history_python 单次超时,默认 300)、allow_unsandboxed(保持 false,官方标记为 UNSAFE 逃生通道)。常见失败:Python 版本不符安装报错;未配 API key 无法对话;沙箱未配置时 recall_history_python 会 fail closed,此时只有结构化 recall_history 可用——这是安全设计,不是 bug。
长程任务实践清单:
- 长会话前先确认 history.db 已随工作区创建,避免以为在记录实际没记录。
- 保留默认 allow_unsandboxed=false,模型代码只跑在沙箱里。
- 大型工具输出会由 pruning 中间件自动外存到 tool_results/,消息里只留有界 preview 与恢复指针,不需要手动干预。
- 30 天 retention 不够就显式设 0,并按自己的备份策略归档 history.db 和 tool_results/。
- 观察 headline 质量:如果模型生成的语义摘要频繁跑题,先换更强的 backbone,检索效果随编码能力变化。
在 AgentScope / QwenPaw 生态中的定位
QwenPaw 是阿里 AgentScope 团队的开源个人 AI 助手(仓库 agentscope-ai/QwenPaw),v2.0.0 基于 AgentScope 2.0 全面重构,引入 Agent OS 架构、Loop Engineering、Scroll 上下文与 ReMe 知识库。Scroll 承担的是三层记忆中的"逐字历史"层:live working context、full verbatim history、self-evolving personal knowledge base(ReMe)三者分工,Scroll 管前两层的事实完整性,ReMe 管语义抽象。
架构上 Scroll 与语义记忆解耦:episodic history 负责精确 recall、时间过滤与任意 join,外部 semantic long-term memory(graph、vector、hybrid)负责知识抽象与语义召回,两者可以同层协同——先从语义层检索实体,再回 Event Log 验证原始记录。论文作者包括 Jingren Zhou 等阿里云研究者,arXiv 编号 2608.21690。
对谁最有用:正在用 QwenPaw 跑长任务但受"中途失忆"困扰的用户,以及评估"无损上下文管理"这一新路线的技术选型者。Scroll 把一个长期被默认接受的折中(摘要必然丢信息)变成了可选项,这条路线是否能成为长程 agent 的主流,取决于后续第三方复现与更多长任务场景的验证。
 AI 速览