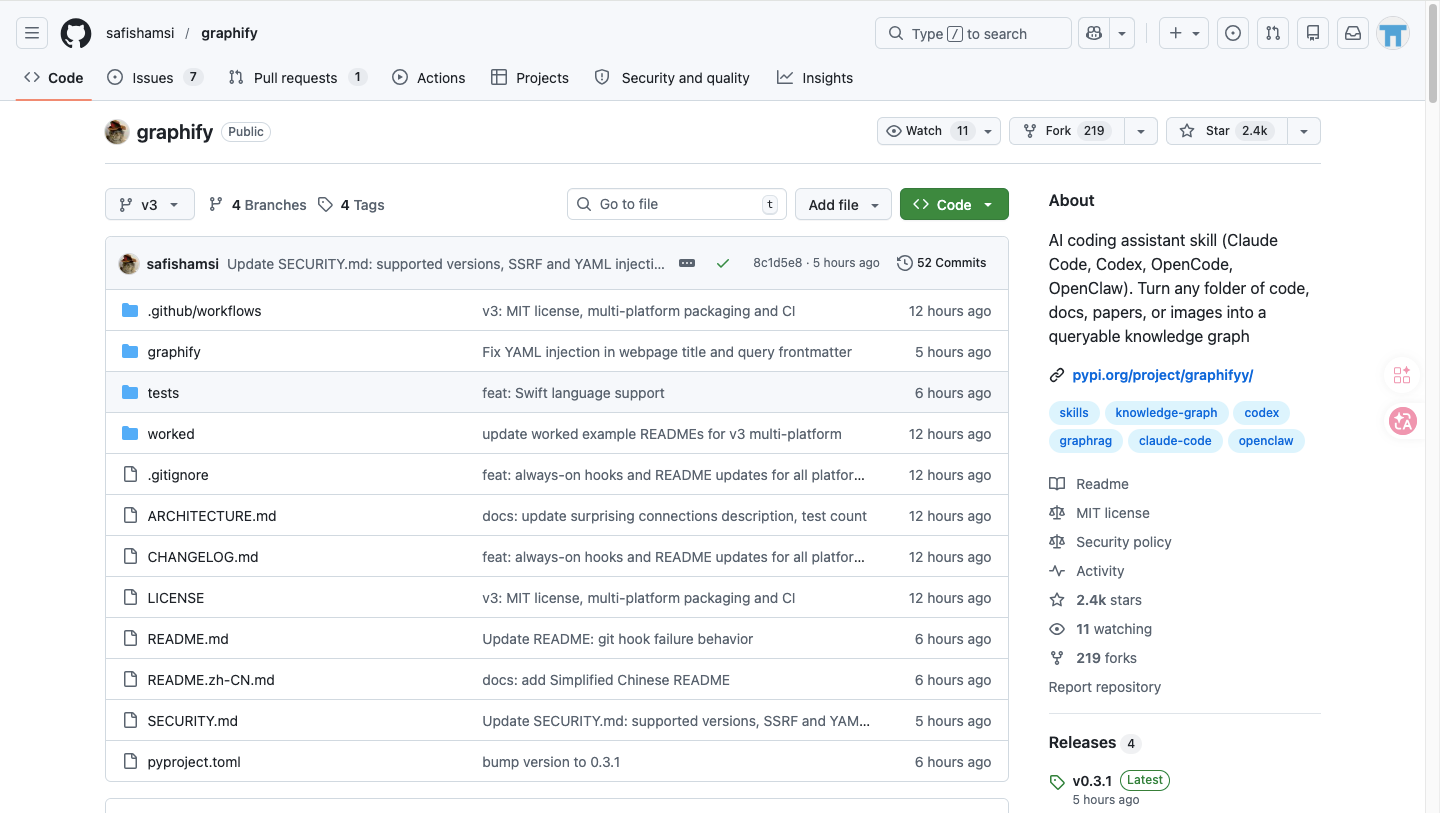
2026年4月3日,前OpenAI联合创始人、前Tesla AI总监Andrej Karpathy在X上分享了他用LLM构建个人知识库的工作流——将论文、推文、截图等原始材料投入一个/raw文件夹,由LLM自动编译为结构化Markdown维基,累计产出约100篇文章、40万字,本人一个字都没手写。他明确提出"这里有空间做一个不可思议的新产品,而不是一堆临时脚本"。48小时后,开发者safishamsi在GitHub上线了Graphify。
核心功能:文件夹进,知识图谱出
Graphify是一个AI编码助手技能,在Claude Code、Codex、OpenCode或OpenClaw中输入/graphify,它读取文件、构建知识图谱,返回用户此前不知道存在的结构。 输入是任意文件夹,输出包含四个核心产物:一个可交互的HTML知识图谱(支持点击节点、搜索、按社区过滤),一份GRAPH_REPORT.md(列出关键节点、意外连接和建议问题),一个持久化的graph.json,以及可选的Obsidian知识库。 Graphify完全支持多模态——代码、PDF、Markdown、截图、图表、白板照片,甚至其他语言的图片都能通过Claude Vision提取概念和关系,连接到同一个图谱中。支持13种编程语言的AST解析。 71.5倍Token节省:不是渐进优化,是范式转换
在混合语料(Karpathy仓库+论文+图片)上的基准测试显示,每次查询比直接读取原始文件节省71.5倍token。没有向量数据库、不需要配置文件、零设置。
核心原理是:首次运行时支付一次索引成本构建图谱,此后每次会话都从图谱查询而非重新读取原始文件。SHA256缓存确保重新运行时只处理变更文件。Token节省随语料规模扩大而增长——6个文件本身就能放进上下文窗口,此时图谱的价值在于结构清晰度而非压缩,但当文件数量达到数十上百时,节省效果急剧放大。
安装与使用
安装只需两行命令:pip install graphifyy && graphify install(Claude Code环境)。也可通过graphify install --platform codex/opencode/claw安装到其他平台。
核心操作命令包括:/graphify .(对当前目录构建图谱)、/graphify ./raw --mode deep(更激进的推断边提取)、/graphify ./raw --update(仅处理变更文件并合并到现有图谱)、/graphify add 加URL(抓取论文或推文并更新图谱)、/graphify query "问题"(自然语言查询)、/graphify --obsidian(生成Obsidian知识库)、/graphify --watch(后台自动同步,代码文件保存时即时重建AST,无需LLM调用)。
持续同步机制
Git hooks支持通过graphify hook install安装post-commit和post-checkout钩子,每次提交和分支切换后自动重建图谱。--watch模式适合多代理并行写代码的场景——图谱在各波操作之间自动保持最新。
对Claude Code环境,Graphify会在CLAUDE.md中写入一段指令告诉Claude在回答架构问题前先读取GRAPH_REPORT.md,并安装PreToolUse钩子,在每次Glob和Grep调用前触发——如果知识图谱存在,Claude会优先通过图谱导航而非遍历原始文件。
Karpathy的原始构想与Graphify的差异
Karpathy的系统基于三个目录结构(raw/存放原始素材、wiki/存放编译后的Markdown文章、outputs/存放查询结果),LLM承担编译和"linting"两个角色——编译时提取概念、创建或追加文章、更新索引和反向链接;linting时检测不一致和重复。整个wiki索引可以放进现代LLM的上下文窗口,无需任何检索系统。
Graphify的差异在于它走的是图谱路线而非纯wiki路线——通过社区检测算法自动发现概念集群、识别"关键节点"(god nodes)和跨集群的意外连接,这些是线性wiki结构难以呈现的。项目已催生.NET移植版本(graphify-dotnet),说明社区采纳正在跨语言扩展。
局限性
图谱漂移是主要的失败模式——使用--update合并新文件时,Graphify会重新运行社区检测,但不会自动移除或纠正早期索引中的过时关系。首次索引需要消耗大量token(全量读取+LLM提取),大型代码库的初始成本不低。此外,对于纯代码项目,图谱的价值主要体现在架构理解层面,日常bug修复等细粒度任务的收益有限。
项目GitHub地址:github.com/safishamsi/graphify。
 AI 速览