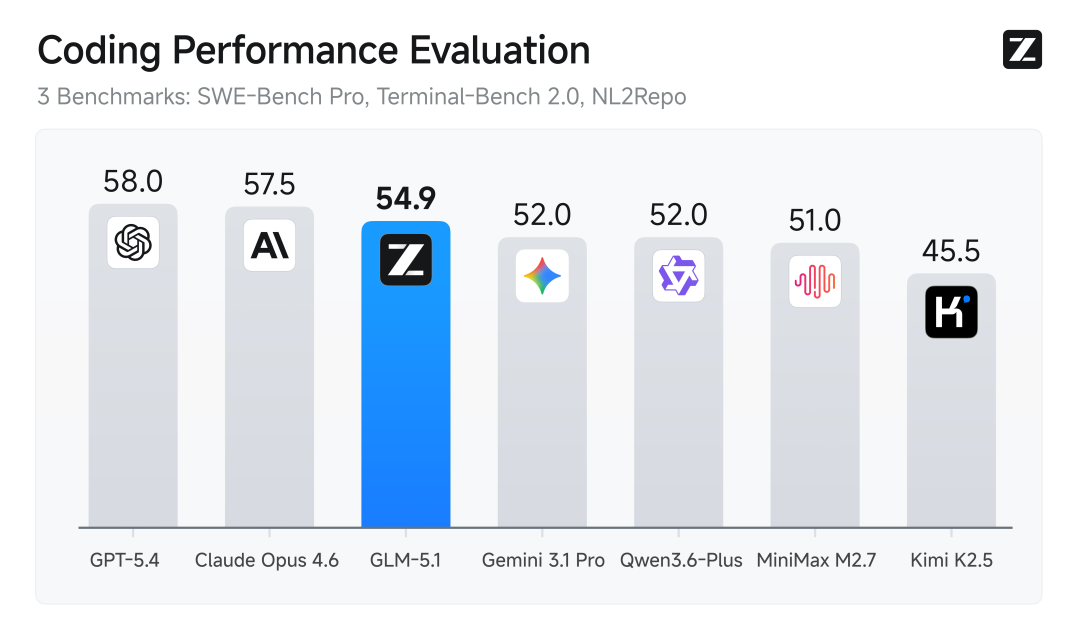
4月8日消息,智谱AI(Z.ai)正式发布并开源GLM-5.1,这是目前全球编码能力最强的开源模型。在业界最严苛的软件工程评测SWE-Bench Pro上,GLM-5.1以58.4%的得分超越GPT-5.4(57.7%)和Claude Opus 4.6(57.3%),成为首个登顶该榜单的中国模型。更引人关注的是,这个模型完全在华为昇腾910B芯片上训练,没有使用任何NVIDIA硬件——而智谱自2025年1月起就被列入美国实体清单。 基准成绩:三项编码评测开源第一、全球前三
GLM-5.1在SWE-Bench Pro、Terminal-Bench 2.0和NL2Repo三项编码基准的综合表现中取得开源第一、全球第三的成绩。
SWE-Bench Pro是目前衡量模型能否胜任专业软件开发的最硬指标,要求模型在真实GitHub仓库中定位并修复高难度工程Bug。GLM-5.1的58.4%不仅超过GPT-5.4和Claude Opus 4.6,更是相比基础版GLM-5的42.1%实现了16.3个百分点的跃升——对于一个编号仅从5升到5.1的版本更新而言,这个幅度相当惊人。
在其他关键基准上,GLM-5系列(含5.1的改进)表现同样突出:SWE-bench Verified 77.8%(落后Claude Opus 4.6的80.8%仅3个百分点),Terminal-Bench 2.0在Claude Code脚手架下达到竞争力水平,BrowseComp 75.9%,GPQA-Diamond 86.0%。数学推理方面,AIME 2026得分95.3%,Humanity's Last Exam带工具使用达52.3%。 不过值得注意的是,所有编码基准数据均为智谱自报。截至发布日,尚无第三方独立验证。多家评测媒体指出,此前GLM-5在SWE-bench Verified上的自报分数经第三方测试后基本成立,但GLM-5.1的新分数仍需等待外部确认。
8小时长程任务:模型的有效工作时间才是新标杆
GLM-5.1的核心差异化不在于某个单一基准分数,而在于"长程任务"(Long-Horizon Task)能力——模型能独立、持续工作超过8小时,期间自主规划、执行、自我评估和策略切换。
智谱在发布中展示了三个代表性场景。
第一个是8小时从零构建Linux桌面。模型执行1200多步操作,20分钟产生第一个有意义成果,8小时后交付了一套包含窗口管理器、状态栏、应用程序、VPN管理器、中文字体支持和游戏库的完整桌面系统,配套文件4.8MB。VentureBeat的报道确认,最终产出包括文件浏览器、终端、文本编辑器、系统监控器和可运行的游戏,模型在过程中持续迭代视觉一致性和交互逻辑。智谱称这相当于一个4人团队一周的开发工作量,全程无人参与测试或代码审查,模型甚至自行编写并通过了回归测试。
第二个是向量数据库优化。655轮迭代中,GLM-5.1自主完成了从全库扫描到IVF分桶召回、从单精度到半精度压缩、从单层路由到两级剪枝的整套优化链条,将查询吞吐从3108 QPS推到21472 QPS,提升6.9倍。关键在于模型展现的"阶梯型"优化轨迹——在一个策略收益趋于停滞时,主动分析Benchmark日志、定位瓶颈、跳转到结构性不同的方案,而非盲目重复同一方向。
第三个是KernelBench Level 3上的1000轮GPU内核优化。在50个真实机器学习计算负载上,GLM-5.1在超过24小时的不间断迭代中取得3.6倍几何平均加速比,大幅高于torch.compile max-autotune模式的1.49倍。模型自主编写了定制Triton Kernel和CUDA Kernel,运用了cuBLASLt epilogue融合、shared memory tiling和CUDA Graph优化等微架构级技术。
在METR榜单的同等评估标准下,GLM-5.1是唯一达到8小时级持续工作的开源模型,全球范围内除Claude Opus 4.6外少数具备这一能力。
技术架构:744B参数MoE,华为昇腾全栈训练
GLM-5.1继承GLM-5的基础架构:744亿总参数的混合专家模型(MoE),256个专家中每次推理激活8个,活跃参数约40B。上下文窗口200K token(部分资料标注为202,752 token),最大输出131,072 token,使用DeepSeek Sparse Attention实现高效长上下文处理。 GLM-5.1定位为GLM-5的后训练升级(post-training upgrade),核心改进在于重新设计的强化学习管线。智谱采用"渐进式对齐"训练流程:多任务监督微调→多阶段强化学习→跨阶段蒸馏,这一管线在GLM-5上已展示出显著效果——相比GLM-4.7在AA-Omniscience Index上提升35分,同时token效率更高(完成类似任务约1.1亿输出token vs 1.7亿)。
训练基础设施方面,GLM-5全系列在10万块华为昇腾910B芯片上使用华为MindSpore框架完成训练。在智谱被列入美国实体清单、无法获取美国制造加速器的背景下,这一事实本身就具有技术示范意义——证明中国半导体堆栈可以独立支撑前沿大模型训练。
模型权重已在Hugging Face(zai-org/GLM-5.1)、GitHub和ModelScope上以MIT许可证发布。完整BF16模型约需1.49TB存储,实际部署需要2×H100或同等级GPU。社区Q2量化版本可在4×24GB GPU上运行,但质量会有下降。
定价与竞争对比:编码能力94.6%接近Opus,价格不到十分之一
GLM-5.1的商业化路径包括API和订阅两种模式。GLM-5 API定价为每百万输入token 1美元、输出token 3.2美元。GLM Coding Plan订阅分三档:Lite(促销价3美元/月,120条提示)、Pro和Max,价格远低于Claude Max的100-200美元/月。
在使用Claude Code作为评测框架的内部测试中,GLM-5.1得分45.3,达到Claude Opus 4.6的47.9分的94.6%。多家分析指出,Claude Code本身是为Claude系列优化的工具,GLM-5.1在这个"客场"环境下达到94.6%意味着实际能力可能更强。
但GLM-5.1的局限性也很明确。纯文本模型,不支持图像、音频或视频输入。数学推理方面,AIME 2026得分95.3%落后于GPT-5.4(98.7%)和Gemini 3.1 Pro(98.2%),说明RL管线有意针对编码和代理执行而非通用推理进行优化。高峰时段(北京时间14:00-18:00)配额消耗为标准的3倍,4月促销期间非高峰时段按1倍计费。 智谱的节奏:六周三个重大模型更新
GLM-5.1的发布节奏值得关注。智谱2026年1月在港交所IPO,融资约5.58亿美元,市值达313亿美元(VentureBeat报道截至发布日市值528.3亿美元)。此后以极快节奏迭代:2月11日发布GLM-5,3月15日发布GLM-5-Turbo(为快速推理和工具使用优化的版本),3月27日发布GLM-5.1——六周内三个重大模型更新。
投资者阵容同样亮眼:阿里巴巴、腾讯、美团、蚂蚁集团、小米、沙特阿美旗下Prosperity7基金。这是一家2019年从清华大学孵化的公司,用不到7年时间走到了全球编码基准的顶部——尽管使用的是非NVIDIA硬件堆栈。
智谱在发布文章中的愿景描述直截了当:终极目标是全自治智能体(Autonomous Agent),7×24小时不间断分解目标、执行交付、自我评价与纠正、自我进化,无需人类介入。GLM-5.1是这条路径上的第一步——它证明了8小时的有效工作时长是可以实现的。下一个问题是:能不能到24小时,以及在没有明确数值指标的任务上(如Linux桌面构建),模型的自我评估机制能走多远。
对于开发者而言,无论是否认同智谱的自报基准,一个可以自托管、MIT许可、在三项主流编码评测中位列全球前三的开源模型,至少值得跑一轮自己的测试。模型已上线,权重已开放,剩下的事情数据会说话。
 AI 速览