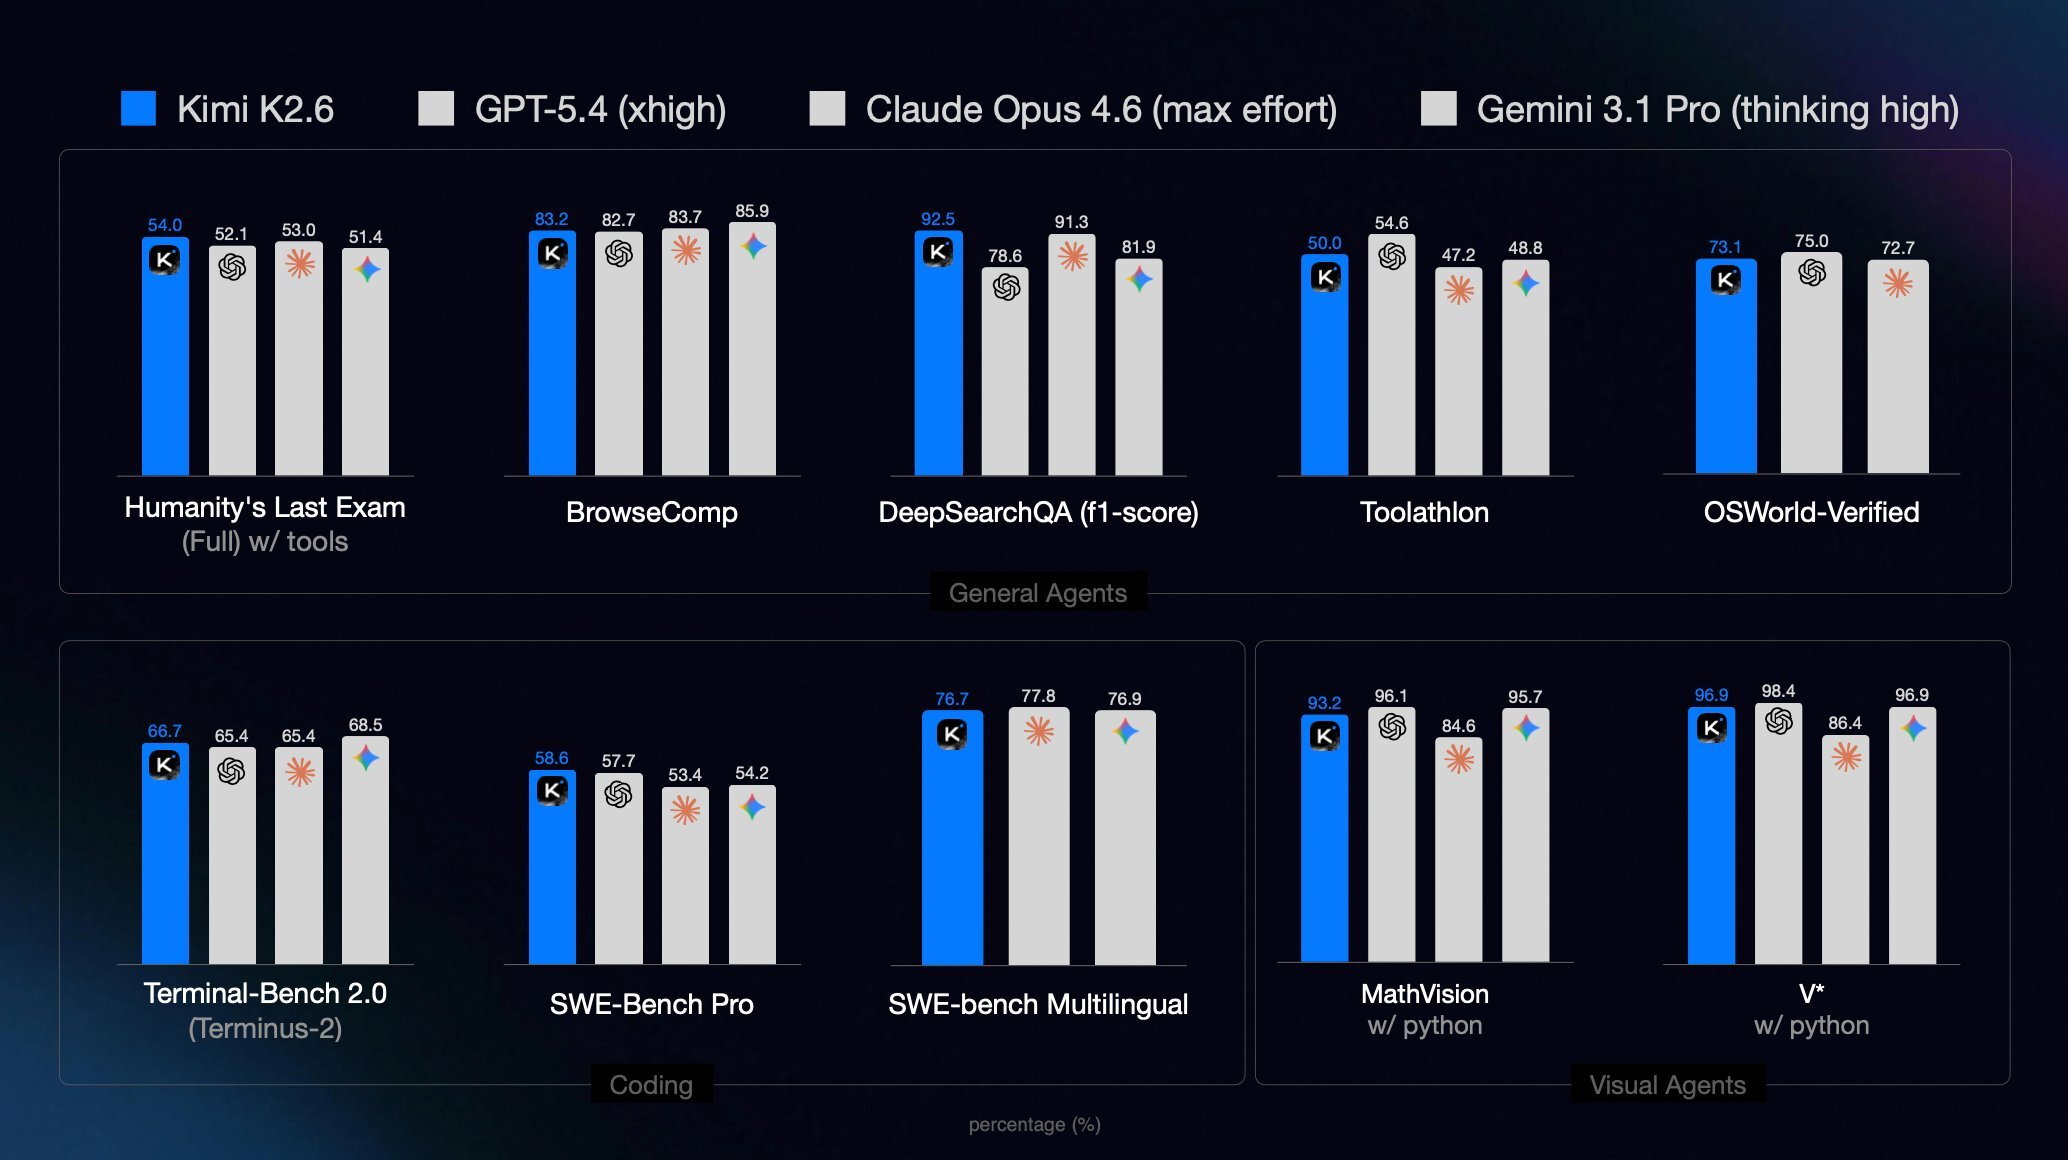
4月21日消息,月之暗面(Moonshot AI)发布并开源新一代大模型 Kimi K2.6,主打长程编码与多智能体协同。模型延续 1T 参数 MoE 架构(32B 激活、384 个专家),原生支持文本、图像、视频输入,256K 上下文窗口。官方数据显示,K2.6 在 SWE-Bench Pro、HLE with tools、Toolathlon、DeepSearchQA 等多项基准刷新开源 SOTA,并在部分指标上反超 GPT-5.4 xhigh 与 Claude Opus 4.6 max effort。权重已上线 HuggingFace,采用 Modified MIT License。 Agent Swarm 扩至 300 子代理,长程执行成为核心升级
K2.6 相较 K2.5 最显著的升级在于 Agent Swarm 架构——并行子代理数量从 100 个提升至 300 个,协调步骤从 1,500 步扩展至 4,000 步。Moonshot 公布的两个长程执行案例被业内视为"Agent 自主运行能力"的代表:
- 在 Mac 上用 Zig 语言对 Qwen3.5-0.8B 本地推理栈进行优化,K2.6 持续执行 12 小时、4,000+ tool calls,最终吞吐较 LM Studio 提升约 20%。
- 对有 8 年历史的开源金融撮合引擎 exchange-core 进行重构,运行 13 小时、12 轮优化,中位吞吐提升 185%,峰值吞吐提升 133%,代码变更超过 4,000 行。
新增的 Proactive Agents 支持 24/7 自主运行,无需用户逐步指令。Claw Groups(research preview)则允许用户从任意设备、任意模型接入不同智能体组,形成跨模型、跨团队的人机协作工作流——Moonshot 称其自有市场团队已在内部采用该机制组织 demo 制作、benchmarking、社媒与视频的并行生产。
7 项开源 SOTA,部分指标反超 GPT-5.4 与 Claude Opus 4.6
官方技术报告中 K2.6 与三款闭源模型做了直接对比(K2.6 于 thinking mode、GPT-5.4 于 xhigh、Claude Opus 4.6 于 max effort、Gemini 3.1 Pro 于 high thinking 级别下测试): - SWE-Bench Pro 58.6,领先 GPT-5.4(57.7)与 Claude Opus 4.6(53.4)
- HLE with tools 54.0,领先 Claude Opus 4.6(53.0)与 GPT-5.4(52.1)
- Toolathlon 50.0,领先 Claude(47.2)与 Gemini 3.1 Pro(48.8)
- DeepSearchQA 92.5,领先 Claude(91.3)
- SWE-Bench Multilingual 76.7,与 Gemini 3.1 Pro(76.9)基本持平
- Charxiv with Python 86.7、Math Vision with Python 93.2、V* 96.9
- SWE-Bench Verified 自测 80.2%
需要注意的是,分析认为 K2.6 并非"全面领先"——BrowseComp 83.2 虽然领先 GPT-5.4 和 K2.5,但仍落后于 Claude 与 Gemini;在部分需要深度英文指令跟随的多约束 Agent 循环中,Claude Code 仍保留优势。 API 输入 $0.95/MTok,相比 K2.5 上调但仍优于主流闭源
Kimi K2.6 提供四种部署路径:在线体验 kimi.com(Chat 与 Agent 模式)、API 调用 platform.moonshot.ai、HuggingFace 下载权重本地部署、以及面向编程场景的 Kimi Code 终端 CLI。Model selector 提供四个变体:K2.6 Instant(快速响应)、K2.6 Thinking(深度推理)、K2.6 Agent(研究/文档/网页/表格生成)、K2.6 Agent Swarm(大规模并行任务)。Cloudflare Workers AI 已上架 K2.6,可通过 @cf/moonshotai/kimi-k2.6 直接调用。 API 官方定价为输入 $0.95/MTok、输出 $4.00/MTok、缓存命中 $0.16/MTok,较 K2.5 的 $0.60/$3.00 上调约 50%。但相比 Claude Sonnet 4.6 的 $3.00/$15.00,仍保持约 3-4 倍的成本优势。Kimi Code 订阅制定价 $15-$159/月,5 小时窗口内 300-1,200 次 API 调用、最大 30 并发的配额对自动化流水线是一个明确约束。
局限与待观察
Benchmark 可比性:所有对比数据均来自 Moonshot 自建 harness,SWE-bench 官方 leaderboard 尚未收录 K2.6 独立验证数据。此前 K2.5 在 mini-SWE-agent v2 harness 下官方成绩 70.8%,明显低于 Moonshot 自测的 76.8%——这种差距并非造假,而是 agent benchmark 对 harness、retries、timeout 规则高度敏感,企业用户需以自身 workflow 实测为准。
Agent 编排稳定性:Implicator.ai 分析指出,K2.6 的真正战场已从"模型能力"转向 orchestration 控制层——300 子代理的理论上限在真实任务中受网络延迟、状态同步、agent 失败重分配等问题制约,版本管理与溯源仍是开源 Agent 栈的普遍短板。BrowseComp 83.2 亦不直接等于生产环境 tool-call 稳定性,网页结构变化仍会击穿基准表现。
成本与生态衔接:K2.6 较 K2.5 的定价上调说明 Moonshot 已不再以"最低价"作为单一策略,输出成本翻倍与 thinking mode 的算力开销直接相关。Kimi Code CLI 的 K2.6 接入在 Dashboard 上线后存在后端路由延迟,社区反馈"CLI 端显示 K2.6 的时间滞后",统一的"Kimi for Code"命名也被部分测试者认为是信任风险点。
 AI 速览