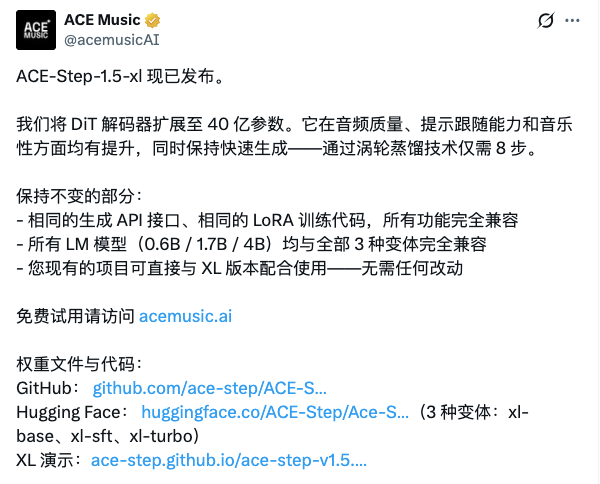
4月8日消息,ACE Studio与阶跃星辰(StepFun)联合开发的ACE-Step 1.5 XL正式开源发布,将DiT解码器从2B参数升级至4B参数。官方声称XL系列在全部11项评测指标上全面超越包括Suno在内的主流商用和开源音乐生成模型,音乐连贯性得分达到4.72+。模型权重以MIT许可证发布在Hugging Face和GitHub,允许免费商用,训练数据由授权音乐、无版权素材和MIDI合成音频组成。 ACE-Step 1.5于1月28日首次发布时已展现出强劲实力——在SongEval标准基准上超越Suno v5,被社区称为开源音乐生成的"Stable Diffusion时刻"。此次XL升级在音频质量、提示遵循度和音乐连贯性上进一步拉开差距,同时保持了与所有现有LM模型(0.6B/1.7B/4B)的完全向后兼容。
XL系列提供三个变体,覆盖不同使用场景。xl-turbo仅需8个扩散步骤即可生成完整歌曲,适合日常快速创作。xl-sft使用50步扩散并支持CFG(分类器自由引导),提供最高音质和精细控制。xl-base同样50步但支持全部高级任务模式——包括extract(片段提取)、lego(拼接组合)、complete(续写完成)等,面向专业编辑、翻唱和重新配乐场景。
生成速度是ACE-Step系列的核心卖点之一。在A100上生成一首完整歌曲不到2秒,RTX 3090上不到10秒,支持10秒到10分钟的灵活时长和最多8首歌曲的批量并行生成。XL版本的显存需求有所增加:模型权重约9GB(bf16),最低12GB VRAM(需INT8 offload加量化),推荐20GB以上获得最佳体验。相比之下,基础版ACE-Step 1.5仅需不到4GB VRAM即可运行。
架构方面,ACE-Step 1.5采用LM(语言模型)+DiT(扩散Transformer)的双阶段管线。LM作为全能规划器,通过思维链推理将用户的简单文本描述转化为完整的歌曲蓝图——包含风格描述符、歌词、编曲元数据等。DiT负责将这些蓝图转化为高保真音频。该架构整合了Sana的深度压缩自编码器(DCAE)和轻量级线性Transformer,利用MERT和m-hubert进行语义表示对齐(REPA),相比纯LM架构加速100倍以上。XL版本将DiT从2B扩展到4B参数,在不改变整体架构的前提下提升音频合成质量。
功能覆盖范围相当全面:文本到音乐(含自动歌词生成)、翻唱(Cover)、重新配乐(Repaint)、人声分离转背景音乐、片段提取、乐高式拼接。支持50+种语言的提示词输入,LoRA微调训练代码已开源——只需几首歌即可训练个人风格模型。全平台支持Mac(Apple Silicon)、AMD(ROCm)、Intel和NVIDIA(CUDA),ComfyUI已原生集成。
官方也坦诚列出了当前局限:对随机种子和输入时长高度敏感导致"抽卡式"输出波动;特定风格(如中文说唱)表现欠佳;重绘和延展操作中存在不自然过渡;人声合成粗糙缺乏细腻度;音乐参数控制粒度仍需提升。这些限制说明ACE-Step 1.5 XL虽然在基准测试上领先,但距离完全替代专业音乐制作流程仍有差距。
对于想要上手体验的用户,最便捷的路径是访问acemusic.ai在线Demo或Hugging Face Spaces。本地部署可直接克隆GitHub主仓库(ace-step/ACE-Step-1.5),使用一键启动脚本自动检测环境并安装依赖。ComfyUI用户可通过已发布的节点包以拖拽方式生成音乐。社区已有Stability Matrix等打包整合版本适合新手。项目同时提供了VST3插件(已独立到ace-step/acestep.vst3仓库)和API服务器,支持与现有音乐制作工作流集成。
 AI 速览