16G显存能跑MiniMax H3,8G也能勉强跑,但体验差得不是一星半点——这篇就是把折腾5小时踩的坑全部铺开讲清楚,你照着做基本能省掉大半时间。
8月3号那天,MiniMax把H3的权重丢上了HuggingFace,开源了。你刷到消息的时候可能正在吃饭,筷子都没放下就去看模型卡。33B参数,全模态,文生视频带原生立体声,最高2K分辨率15秒。评论区一片"开源之光""吊打Wan2.2"的欢呼,你低头看看自己那张RTX 4060 16G,沉默了。第一反应大概率是"算了,等大佬优化吧"——33B的模型,16G显存光装权重都紧张。但刷了两天帖子,看到有人用NF4量化在8G显存上跑出480p,还有人在RTX 4070 Ti上5秒视频只花47秒,你可能就坐不住了。泡杯咖啡,打开ComfyUI,五个小时后,output文件夹里终于躺着一个带音效的5秒MP4。中途重装两次ComfyUI、改三次分页文件、模型下错两次。但跑通那一刻,比第一次跑通Stable Diffusion还激动。
H3到底是什么
MiniMax H3是稀宇科技2026年7月31日发布、8月3日开源权重的全模态视频生成模型。33.1B参数,密集架构不是MoE,一个模型搞定文生视频、图生视频、参考视频生成,视频和音频同一个模型一起出,不是先出画面再配音那种拼接方案。文本编码器用Qwen3-VL-32B,本地默认768p,2K需要调官方API,时长4到15秒,24帧率,32kHz原生双声道立体声。帧数有个公式叫17n+5,后面调参数会用到,不是随便设的数字。
开源的部分是H3-Base,包含FL2VA首尾帧模式和Ref2VA全模态参考模式;没开源的是Context-IR多模态指令理解模块和Regenerate-2K高清重绘模块,这两块只能调API。所以本地部署的真实体验是768p分辨率加自己写提示词,质量不错,但比官方在线版少了提示词增强和2K超分。有个细节要注意,许可证排除了美国、欧盟、英国和韩国,这些地区本地跑不了,国内没问题。
显卡到底够不够
8G显存能跑但很慢,NF4量化配合磁盘卸载,480p一条5秒视频要8到10分钟;12G用INT8量化能稳定跑480p,5秒大概5分钟;16G是比较舒服的档位,480p流畅、720p可跑;24G以上720p丝滑。满血BF16全精度需要8卡H200集群,跟个人开发者基本没关系,大家跑的都是INT8、NF4这类量化版本,画质跟原版差距很小。
系统内存是个容易被忽视的坑。你显存放不下42.5GB的量化模型组合,ComfyUI会自动在显存和内存之间搬运,内存不够就得溢出到SSD分页文件,速度直接崩。32G是底线,64G才是甜点区。预算有限的话,优先加内存而不是换显卡,这点跟直觉相反但确实是实际情况。
部署流程和提示词写法
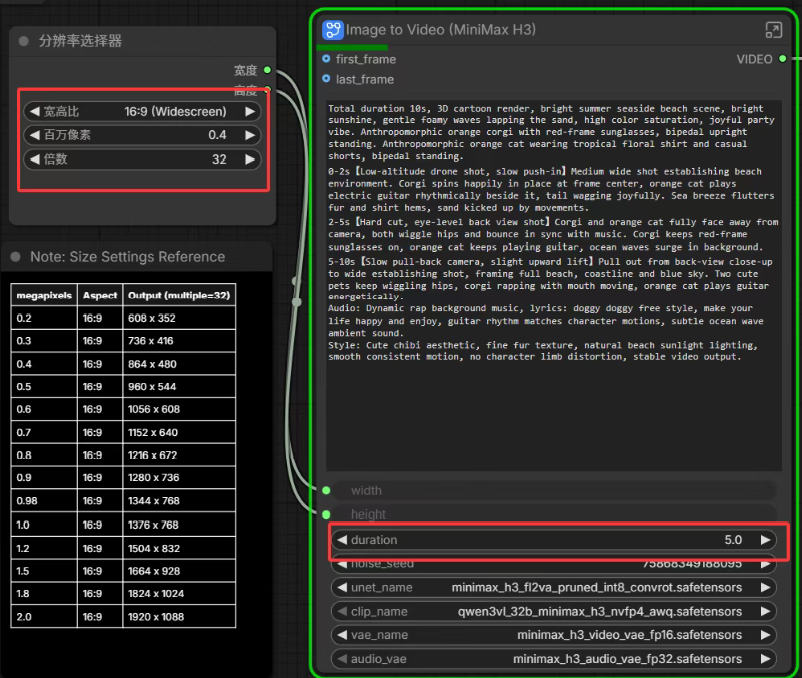
流程大致是下载ComfyUI、更新依赖、加载官方工作流、下载约42.5GB的四个模型文件(国内建议走ModelScope,速度快还支持断点续传)、重启ComfyUI。分辨率必须是32的整数倍,16G显卡建议从0.4MP起步确认提示词效果,再往上提。
H3的提示词跟普通文生图不一样,得按时间轴分层写。骨架是主题定调、主体动作分段描述、镜头运镜分段描述、声音分段描述,时间段必须连续不重叠,比如0到2秒接2到4秒再接4到5秒,不能跳着写。
容易踩的几个坑
显存不足就加--lowvram参数或者降分辨率;模型加载失败多半是文件名或目录放错了;画质模糊先检查分辨率是不是太低、VAE是不是用错了;音画不同步要核对帧率和时长对齐,5秒24fps对应约124帧。社区还有个SageAttention加速方案,能省将近一半采样时间,但配置有点门槛,新手不建议一上来就折腾这个。
出结果建议按四轮走:先用0.2到0.4MP超低分辨率快速验证构图对不对,再加参考素材确认效果,然后提到0.9MP出定稿母版,最后想要更高质量就交给外部超分工具。每轮只改一个变量,同时改提示词又改分辨率又换采样器,出问题了根本不知道该怪谁。
这套东西适合自媒体创作者、需要快速做产品演示的电商团队、有ComfyUI基础不怕折腾的爱好者;8G以下显存不想升级的、需要2K商用成片的、完全零基础的,大概率会劝退。如果你只是偶尔玩玩,直接用官方API更省心,768p每秒不到0.5元。如果是长期要做内容、想反复试错不想每次都花钱,花一个下午把本地部署搞通,值。折腾这5小时最大的体会是,系统内存和虚拟内存比显卡更重要——33B的视频模型动态卸载是常态,内存才是你真正的第二显存。
 AI 速览