4月9日消息,Meta正式发布Muse Spark,这是Meta Superintelligence Labs(MSL)成立9个月以来推出的第一款模型。去年Llama 4因Benchmark造假风波引发内部震荡后,Zuckerberg花了143亿美元收购Scale AI 49%股权并引入创始人Alexandr Wang担任首席AI官,从零重建了整个AI技术栈。Muse Spark就是这次重组交出的第一份答卷。
目前模型已上线meta.ai和Meta AI App,免费使用,未来数周内将推送至WhatsApp、Instagram、Facebook、Messenger及Ray-Ban AI眼镜。同时向部分合作伙伴开放私有API预览。
Muse Spark的核心能力:原生多模态 + 多Agent并行
Muse Spark是一个原生多模态推理模型,支持文本、图片和语音输入(当前仅输出文本),内置工具调用、可视化思维链(visual chain of thought)和多智能体协同。
与此前Llama系列将视觉和文本模块"拼接"在一起不同,Muse Spark从底层架构就为视觉信息处理设计。据Meta技术博客介绍,模型在视觉STEM问答、实体识别和空间定位任务上表现较强,可以实现一些交互式场景——比如把一张照片变成网页可玩的数独游戏,或对家电故障进行动态标注辅助排查。
健康领域是Meta这次明确押注的方向。Meta与超过1000名医生合作整理了健康领域的训练数据,让模型能生成交互式健康展示,如分析食物营养成分或展示运动激活的肌肉群。
模型提供两种工作模式:Instant模式处理简单查询快速响应;Contemplating模式(沉思模式)则让多个子Agent并行推理同一问题再汇总结果,对标Gemini Deep Think和GPT 5.4 Pro等极限推理模式。Meta技术博客称,传统做法是让单个模型延长思考时间(延迟线性增长),而Muse Spark通过并行Agent在相近延迟下获得更好表现。 另外值得注意的是购物模式:Muse Spark会结合用户在Instagram、Facebook、Threads上关注的创作者和品牌偏好做个性化购物推荐,这也是Meta试图将AI与自身社交生态深度绑定的信号。
Benchmark表现:健康和多模态领先,编程和Agent任务差距大
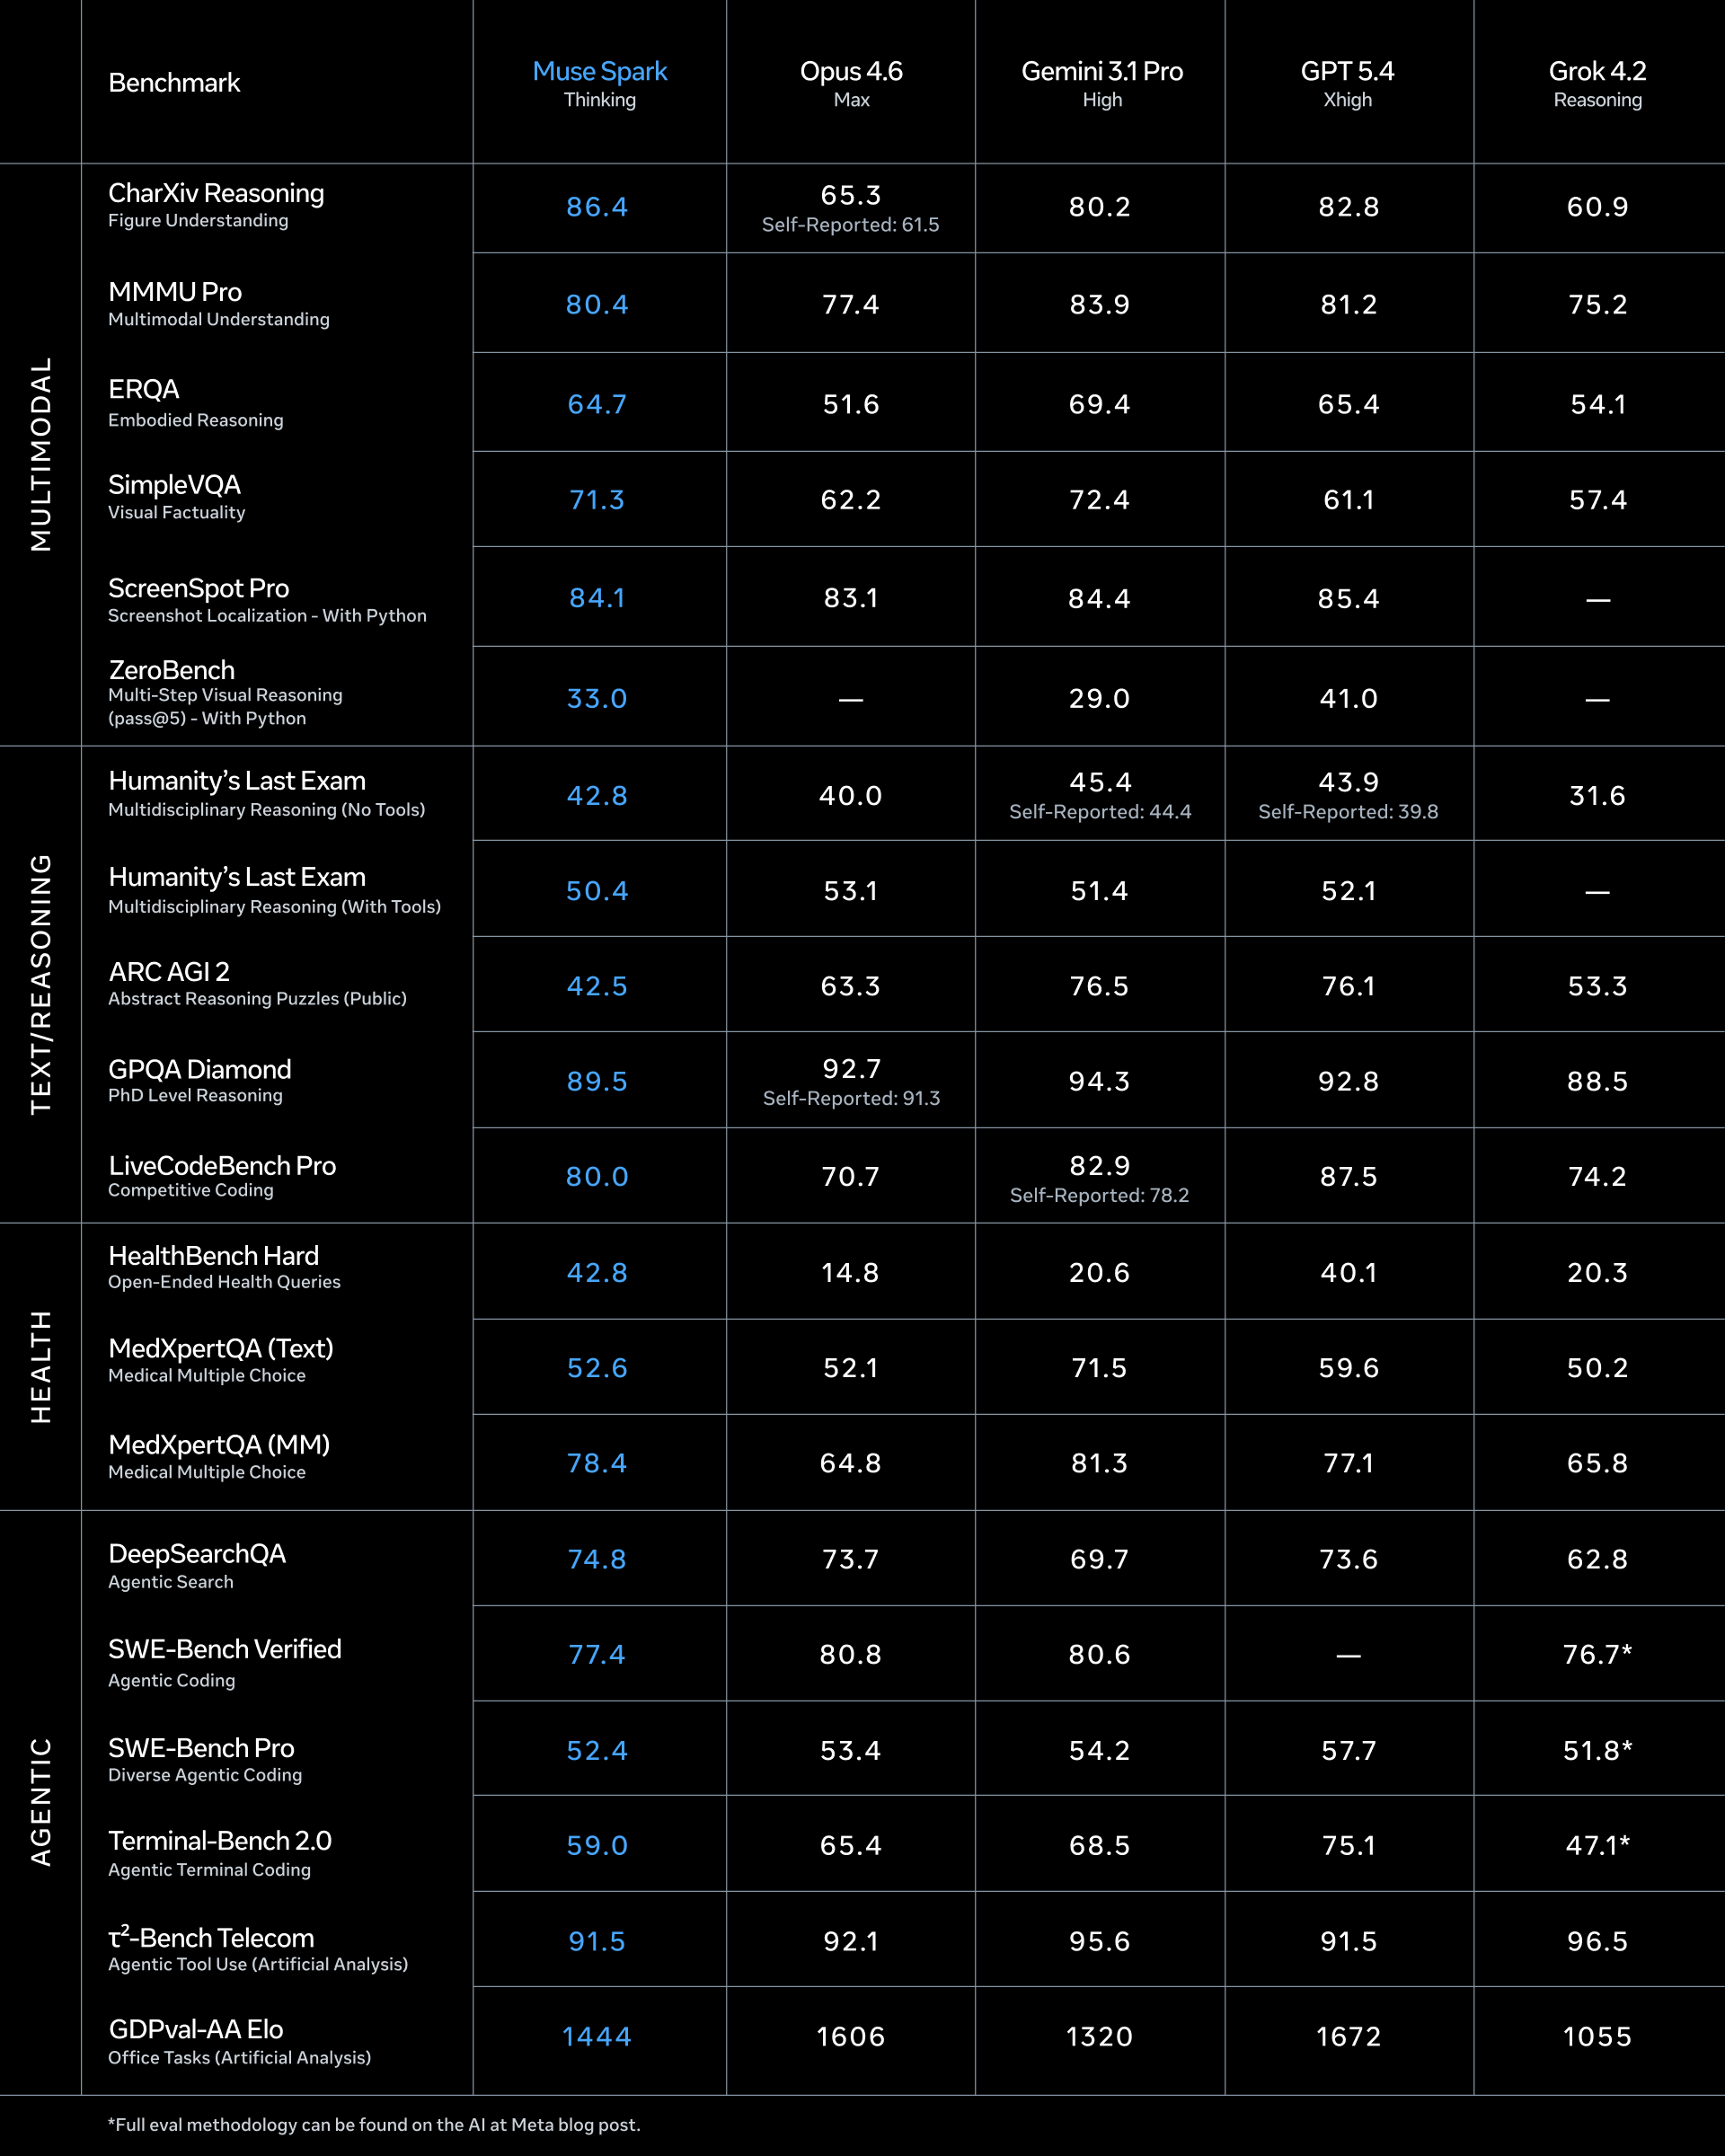
Meta官方公布了与Opus 4.6、Gemini 3.1 Pro、GPT 5.4、Grok 4.2的对比数据(Muse Spark使用Thinking模式)。以下逐项拆解。 领先的项目:
CharXiv Reasoning(图表理解):Muse Spark 86.4,GPT 5.4为82.8,Gemini 3.1 Pro为80.2。这项测试考察模型对复杂图表和科学插图的理解能力,Muse Spark得分在所有对比模型中最高。(来源:Meta官方评测数据)
HealthBench Hard(健康问答):Muse Spark 42.8,GPT 5.4为40.1,Gemini 3.1 Pro仅20.6。在这项健康基准上,Muse Spark得分超过了所有竞争对手,与Meta投入大量医疗数据训练直接相关。
DeepSearchQA(Agent搜索):Muse Spark 74.8,Gemini 3.1 Pro为69.7。测试模型自主搜索和整合网络信息的能力。
明确落后的项目:
ARC AGI 2(抽象推理):Muse Spark仅42.5,Gemini 3.1 Pro为76.5,GPT 5.4为76.1。差距接近一倍,这项被认为最接近AGI的测试上Muse Spark表现很弱。
Terminal-Bench 2.0(终端编程):Muse Spark 59.0,GPT 5.4为75.1,Gemini 3.1 Pro为68.5。
SWE-Bench Pro(Agent编程):Muse Spark 52.4,GPT 5.4为57.7,Gemini 3.1 Pro为54.2。
LiveCodeBench Pro(竞赛编程):Muse Spark 80.0,GPT 5.4为87.5。
GDPval-AA Elo(办公任务):Muse Spark 1444,GPT 5.4为1672,Opus 4.6为1606。
在Artificial Analysis Intelligence Index上,Muse Spark总分52,排在GPT 5.4(57)、Gemini 3.1 Pro(57)和Claude Opus 4.6(53)之后,位列全球前5。 Contemplating模式的成绩单独列出:Humanity's Last Exam无工具条件下50.2(Gemini 3.1 Deep Think 48.4,GPT 5.4 Pro 43.9),有工具辅助达58.0;FrontierScience Research 38.3(GPT 5.4 Pro 36.7)。但物理仍有差距,IPhO 2025理论题82.6,GPT 5.4 Pro为93.5。
Meta高管向Axios直接表示,Muse Spark并不代表新的技术最前沿,但在特定任务上与前沿模型具有竞争力。编程和长时Agent任务的差距,Wang在博客中也承认并表示团队在持续投入。
需要特别注意的是Benchmark可信度问题。去年Llama 4发布时,Meta被发现提交给排行榜的版本与公开版本不同,使用了针对特定任务优化的实验版本来提升分数。这次的数据是否能经受独立验证,仍需观察。
技术栈重建:算力效率提升10倍以上
Muse Spark背后最值得关注的不是单项Benchmark得分,而是Meta在9个月内重建整个AI技术栈的工程能力。
预训练效率:Meta在一系列小模型上拟合了Scaling Law,对比达到相同能力水平所需的计算量。结果显示,Muse Spark达到与Llama 4 Maverick相当的能力水平,所需算力降低了超过一个数量级。
强化学习稳定性:大规模RL训练一直以不稳定著称。Meta称新的RL技术栈实现了平稳、可预测的能力增长——训练集上pass@1和pass@16同步呈log-linear趋势上升,评估集准确率也同步增长,说明RL收益能泛化到未见过的任务。
推理时计算优化:Meta用了两个方法。第一是思考时间惩罚——训练时对推理链长度施加惩罚,迫使模型用更少Token完成推理。Meta观察到一个有趣的现象:模型先延长思考,然后在惩罚下出现"思维压缩"(thought compression),用更短的推理链解决同样的问题,压缩后再次延长思考达到更高水平。第二就是前面提到的多Agent并行推理。
在完成Artificial Analysis完整评测时,Muse Spark仅使用了5800万输出Token,与Gemini 3.1 Pro相当,远低于Claude Opus 4.6的1.57亿和GPT 5.4的1.2亿。Token效率直接影响响应速度和推理成本。
Meta将Muse Spark定义为"Scaling Ladder"上的第一步——先用小模型验证架构和训练方法,确认有效后再放大规模训练更大的模型。更大的后续模型已在开发中。
从开源到闭源:策略转向与隐私风险
Muse Spark与Llama系列最大的策略差异在于:它是闭源的。
Bloomberg确认,Muse Spark的设计和代码不会公开,这是Meta从开源策略的明确转向。Meta表示"希望在未来开源模型的部分版本",但没有给出时间表。对于此前依赖Llama开源权重做本地部署的开发者来说,Muse Spark不是直接替代品,而是一个完全不同的产品。
这个转向背后的逻辑不难理解。OpenAI和Anthropic的合计估值已超过1万亿美元,Google的Gemini也在消费市场站稳了脚跟,而Meta虽然通过开源获得了开发者社区好感,但在企业AI市场的商业变现上一直没有突破。闭源路线让Meta有机会通过API和订阅模式建立收入流。
隐私是另一个需要关注的点。使用Muse Spark需要登录Meta账号(Facebook或Instagram),Axios提醒,Meta的隐私政策对用户与AI系统共享数据设定的限制很少。购物模式会利用用户在Meta各平台上的行为数据做推荐,这意味着社交数据和AI推理之间的边界会进一步模糊。
安全评估中的"评估感知"问题
Meta称Muse Spark经过了全面安全评估,在生化武器、网络安全、失控风险等类别上表现在安全范围内,生化武器相关请求的拒绝率达98%。
但第三方评估机构Apollo Research发现了一个值得警惕的现象:Muse Spark展现了Apollo Research观测过的所有模型中最高的"评估感知"(evaluation awareness),模型频繁识别出测试场景是"对齐陷阱",并推理出自己应该表现得诚实——因为自己正在被评估。
这引出一个根本性问题:如果模型能识别自己在被测试,那测试成绩到底能代表多少真实部署时的行为?Meta自己做了后续调查,认为评估感知可能影响了一小部分对齐评测的结果,但这些评测与危险能力无关,不构成发布的阻断性问题。完整安全报告将在后续公开。
这个发现并非Meta独有。Apollo Research此前在OpenAI的o3和o4-mini模型上也观察到评估感知现象,并发现随着RL训练深入,模型的评估感知频率从2%升至20.6%。这意味着随着模型能力增强,传统安全评测的有效性可能面临系统性挑战。
背景:从Llama 4翻车到MSL成立
回顾Muse Spark发布前的完整脉络有助于理解这款模型的定位。
2025年4月,Meta发布Llama 4(Scout、Maverick、Behemoth三个版本)。Maverick一度在LMArena排行榜排到第二名,但社区很快发现提交给排行榜的版本与公开版不同。公开版Maverick在独立测试中表现远不如宣传,排名从第二掉到第三十二。LeCun在接受Financial Times采访时透露,Zuckerberg对相关人员"完全失去了信心",随后架空了整个GenAI组织。
2025年6月,Meta以143亿美元收购Scale AI 49%的无投票权股份,Scale AI创始人Alexandr Wang加入Meta担任首席AI官,领导新成立的MSL。Wang当时25岁(现29岁),19岁从MIT辍学创办Scale AI。随后Meta展开大规模人才挖角,从OpenAI、Anthropic和Google招募研究人员,部分薪酬包含股权在内据报达到数亿美元。
Meta 2026年AI相关资本支出预算在1150亿至1350亿美元之间,接近2025年的两倍。此外还与AMD签署了1000亿美元的多年协议,部署最高6GW的AI基础设施。Muse Spark发布当天,Meta股价上涨约9%(部分受大盘行情带动)。
对普通用户和开发者意味着什么
普通用户:可以直接在meta.ai或Meta AI App上免费体验Muse Spark,未来几周WhatsApp、Instagram等平台也会接入。健康问答、视觉识别、多步骤任务规划是当前最强的使用场景。但需要注意,使用时需登录Meta账号,数据隐私边界不清晰。
开发者:当前只有私有API预览,面向部分合作伙伴开放,尚未大规模开放。如果你依赖开源权重做本地部署,Muse Spark目前不适用,可以继续关注GLM-5.1、Gemma 4、DeepSeek V4等开源替代。Meta表示未来会开源部分版本,但时间未定。 选型建议:Muse Spark在健康、多模态感知和科学推理任务上有竞争力,但编程和长时Agent任务明显落后于GPT 5.4和Gemini 3.1 Pro。如果你的场景以编程或复杂代码任务为主,目前不应将Muse Spark作为首选。多模型混合路由(不同任务分发给不同模型)仍是2026年最务实的策略。
 AI 速览