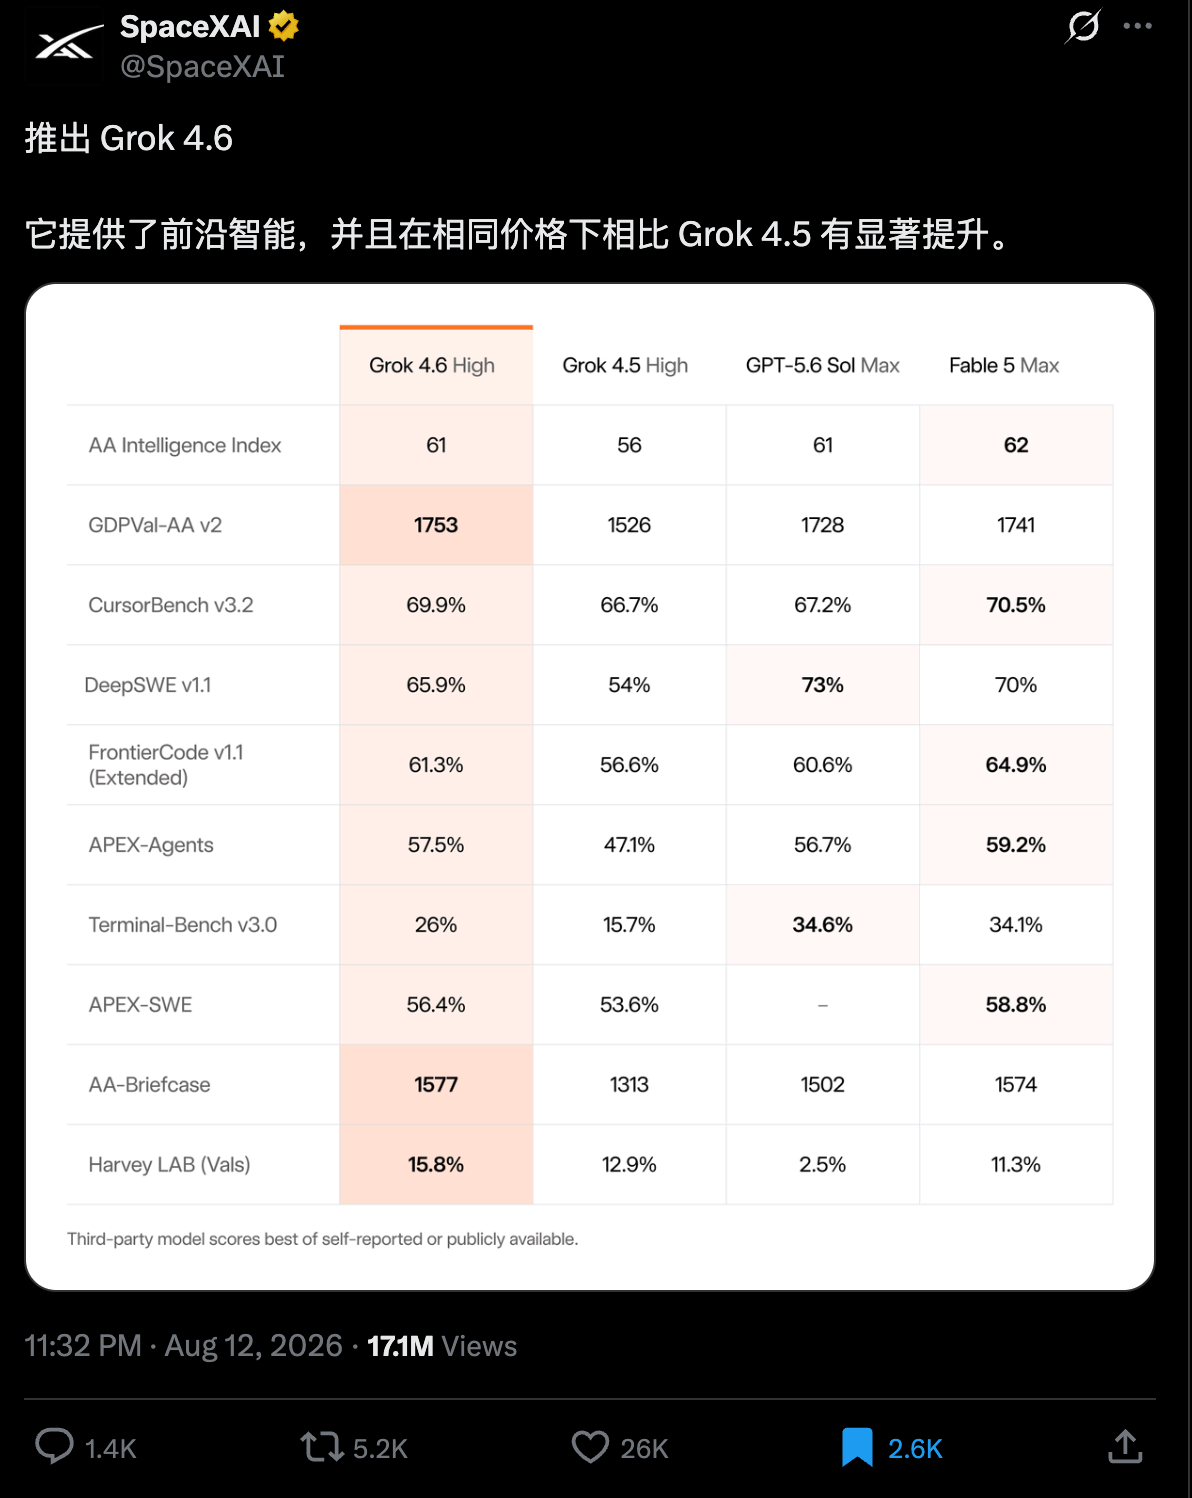
8月13日消息,SpaceXAI 发布 Grok 4.6。发布说明写到,一个更早的检查点被要求加速自身的聊天推理:5 小时内处理 297 个候选优化,提交 7 个拉取请求,其中 3 个已进入 Grok Chat 生产流量。官方给出的合计收益是预填充吞吐量提高 3.1%,解码吞吐量提高 1.5%。模型当天可在 Cursor、Grok Build 和 API 使用。消费端网页、移动应用和 X 上的 Grok 入口,官方写明将晚些时候再加。 开发者入口当天开,消费端入口还没开
Grok 4.6 是 SpaceXAI 1.5T 规模系列的最新一代,上一代 Grok 4.5 于7月16日发布。文档中的模型名是 grok-4.6,上下文窗口为 50 万 Token。补充训练使用了匿名化的 Cursor 工作流数据。
当天可用的入口是 Cursor 全套餐、Grok Build,以及 SpaceXAI API。公告还列出 OpenRouter、Vercel 和 Cloudflare。首周内,Grok Build 和 Cursor 的含用量加倍。标价与 Grok 4.5 相同:输入 2 美元 / 百万 Token,输出 6 美元 / 百万 Token。另有价格翻倍的快变体。提示低于 20 万 Token 时,缓存输入为 0.50 美元 / 百万 Token;超过该阈值后,输入、缓存输入和输出价格翻倍。 Artificial Analysis 同日测得 Grok 4.6 在 Intelligence Index 上为 61,与 GPT-5.6 Sol 持平,落后 Claude Opus 5 的 63 和 Claude Fable 5 的 62。官方表中的 Terminal-Bench v3.0,Grok 4.6 为 26%,低于 GPT-5.6 Sol Max 的 34.6%。这和 Artificial Analysis 使用的 Terminal-Bench v2.1 不是同一套题目。 五个小时筛出三个进生产的补丁
发布说明还评估了 Grok 4.6 能否承担训练和下一版模型时的部分工程与研究工作。Agentic 强化学习覆盖了知识工作、通用编程,以及内核优化、网页开发和计算机辅助设计等专用环境。
生产实验用的是更早的检查点,任务是加快自己的聊天推理。它被允许试错,但必须先验证端到端收益,才能提交拉取请求。官方写道,5 小时内它处理了 297 个候选,覆盖融合 MoE(混合专家)、FMHA(Flash 多头注意力)、内核调度和通信。没有可测端到端收益的方案被丢掉,其中若干已经通过微基准。最终提交 7 个拉取请求,3 个现已服务 Grok Chat 生产流量,合计解码吞吐量提高 1.5%,预填充吞吐量提高 3.1%。但这组数字是对自家 Chat 服务栈的自测。Cursor 用户不会因此获得一条对等的编辑器加速承诺。3.1% 和 1.5% 幅度不大。
SpaceXAI MTS Eval 还面向公司工程师的日常模型研发,题目包括诊断训练中的 reward hacking(刷奖励)、生成和审计训练数据、调试大规模训练基础设施,以及为新能力编写评测。标准套件在 Grok Build 工具链下计分。Grok 4.6(high)正确率 61.1%,高于 Grok 4.5 的 57.1%,也高于所列 Opus 4.8、Opus 5 和 GPT-5.6 Sol。脚注写明,GPT-5.6 Sol 拒答 29 题中的 2 题,被拒任务不计入其得分。
InferenceEval 要求智能体在真实承载聊天推理的代码上落地生产改动,从内部推理栈的冻结镜像出发提交可工作补丁。Grok 4.6(high)准确率 46.9%,高于 GPT-5.6 Sol 的 44.1% 和 Opus 5 的 43.0%。KernelBenchInternal 没有把 Grok 4.6 放在最前:GPT-5.6 Sol 73.1%,Opus 5 73.0%,Grok 4.6 70.6%。
马斯克称 Grok 4.7 初始训练完成,3 到 4 周内就绪
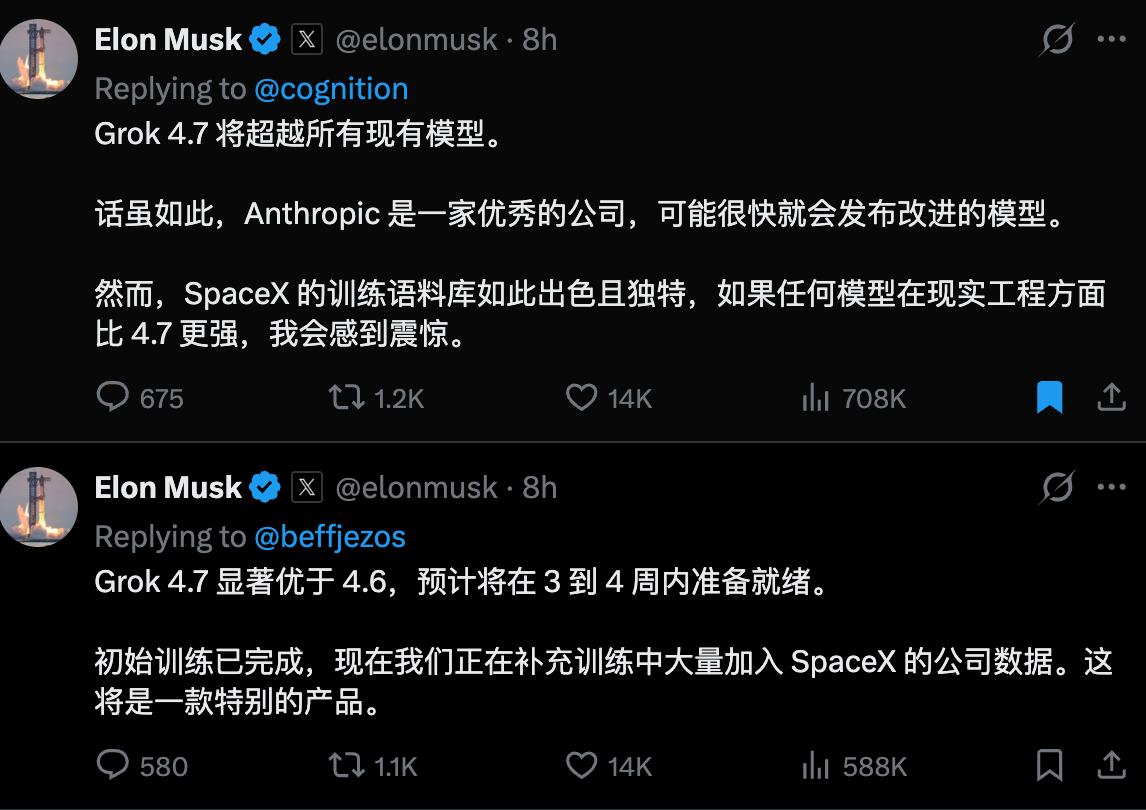
马斯克 8月12日在 X 上称,Grok 4.7 的初始训练已经完成,目前正在补充训练,并大量加入 SpaceX 公司数据,预计 3 到 4 周内准备就绪。他写道,Grok 4.7 将超过目前所有模型;SpaceX 的训练语料足够独特,若有模型在现实工程上强过 4.7,他会感到震惊。
 AI 速览