4月9日消息,字节跳动Seed团队正式推出原生全双工语音大模型Seeduplex,已在豆包App全量上线,面向上亿用户提供实时语音交互。相比此前豆包使用的半双工端到端语音模型,Seeduplex通过"边听边说"的架构设计,在抗干扰和对话节奏控制两项核心指标上实现显著提升。 两项核心能力提升的具体数据
Seeduplex的技术突破集中在两个方向。
第一是抗干扰能力。模型在回复过程中持续接收用户侧音频,能感知全局声学环境,区分用户指令与背景噪音、无关人声。官方评测数据显示,在复杂声学干扰场景下,Seeduplex的误回复率和误打断率相比半双工模型降低了约50%。实际场景举例:车内导航播报混杂时能剥离干扰精准响应,咖啡厅中用户与他人对话时不会错误抢答。
第二是动态判停。模型联合语音声学特征和语义信息判断用户是否说完,解决了传统半双工系统依赖单一VAD机械切音导致的"抢话"问题。数据上,AI抢话比例相对下降40%,判停延迟降低约250ms。同时在用户主动打断时,响应延迟比半双工方案缩短约300ms。
技术架构:从级联模块到原生端到端
传统半双工语音对话系统采用级联设计:独立的VAD模块做语音检测,前端降噪算法处理音频,ASR转文字后送入LLM,再由TTS输出语音。各模块独立运作,判停依据局限于单一声学特征或局部语义,复杂环境下极易误判。
Seeduplex的核心架构变化是将"听"和"说"统一到一个原生端到端框架中。模型基于字节自研LLM底座,通过大规模语音数据预训练获得语音语义联合建模能力,能流式处理输入音频,实时决策当前应开始回复、继续倾听还是响应打断。
工程层面,团队通过投机采样和量化优化推理性能,在保持超低延迟的前提下控制成本;并解决了高并发场景下收音和播报卡顿等稳定性问题,使模型可在大流量环境下持续运行。
评测结果与人人对话对比
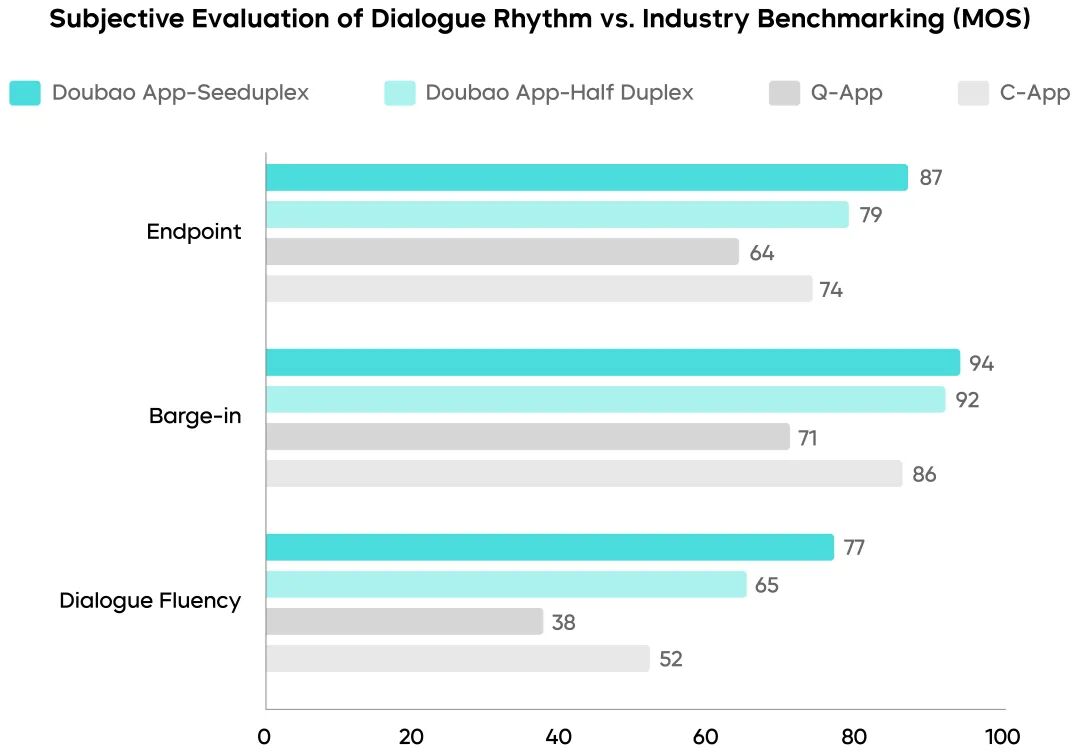
官方A/B测试数据显示,相比此前上线豆包的半双工模型,Seeduplex在整体通话满意度上绝对值提升8.34%,判停MOS分提高8%,对话流畅度MOS分提升12%。用户反馈中"抢话""响应慢""误打断"等负面标签的提及比例明显下降。
与行业主流App语音通话功能的横向对比中,Seeduplex在判停和打断响应任务上展现出优势。
更值得关注的是与真人对话的对标测试。以真实人人对话为基准,Seeduplex的判停表现比半双工方案提升了8%;在打断响应上,Seeduplex的表现甚至略优于人人对话的平均水平(真人对话在响应打断时有时反应滞后)。但团队坦承,在整体对话流畅度上,Seeduplex与真实人人对话仍有明显差距。
竞品格局与局限性
全双工语音交互是当前语音AI的核心赛道。OpenAI已推出gpt-realtime模型及Realtime API,支持实时语音对话。Google Gemini系列也在持续强化实时多模态交互能力。国内方面,阿里通义、科大讯飞等也在推进端到端语音对话方案。 Seeduplex的差异化在于全双工能力已大规模落地——直接全量上线至拥有超过1.55亿周活用户的豆包App(据EvoLink引用的Reuters数据),而非停留在API或实验室阶段。但也存在明确限制:目前仅支持语音+文本双模态,尚未引入视觉模态;模型的"主动交互"能力(如在倾听中附和用户)尚在规划中,当前版本不具备;对话流畅度与真人对话仍有可感知差距。
后续方向
团队公布了五个迭代方向:深度优化多人对话和智能硬件场景表现;通过数据Scaling提升对话节奏多样性;引入倾听中附和等主动交互能力;融合视觉模态实现"边听边看边说";以及探索"边听边想""边听边搜"的感知-思考-输出一体化方案。
项目主页:https://seed.bytedance.com/seeduplex
 AI 速览