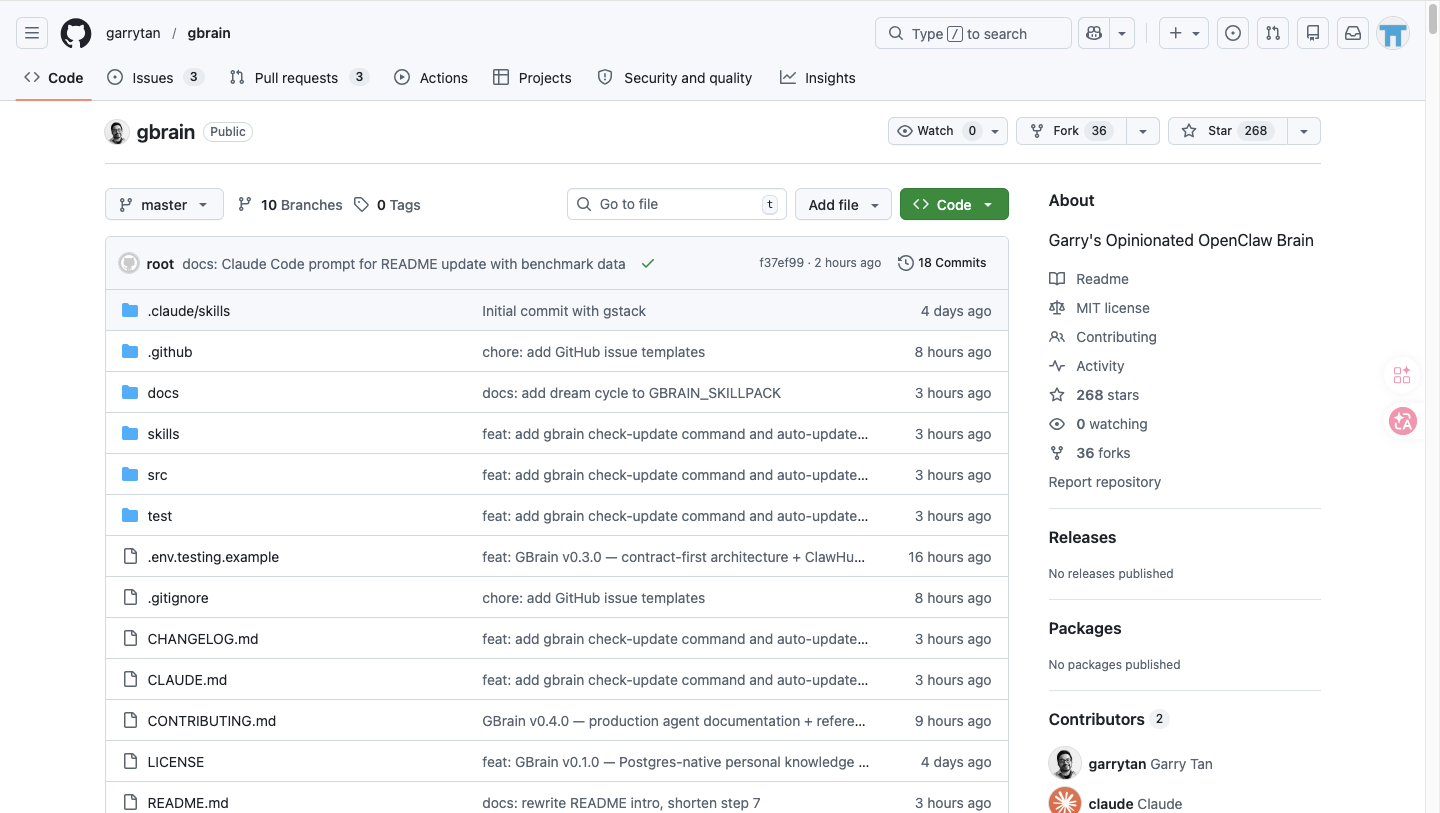
2026 年 4 月,Y Combinator 现任 CEO Garry Tan 开源了 GBrain——一个基于 Postgres pgvector 的个人知识库工具,核心卖点是"混合搜索真的能用"。项目直接脱胎于 Andrej Karpathy 在 4 月 3 日发布的 LLM Wiki 理念,但 Tan 认为当语料库膨胀到 13000 个 Markdown 文件时,Karpathy 那套"LLM 自己维护索引文件 + grep"的方案已经撑不住了,必须上真正的向量数据库。
Karpathy 的 LLM Wiki 解决了什么,又在哪里断裂
Karpathy 在 X 上分享的 LLM Knowledge Base 工作流核心思路是:把原始文档扔进 raw/ 目录,让 LLM 增量"编译"成结构化的 Markdown Wiki,包括摘要、反向链接和概念文章。他本人在约 100 篇文章、40 万字的规模上运行良好,不需要向量数据库,LLM 自己维护索引文件就够了。Lex Fridman 也确认自己在用类似方案,甚至会生成临时的"迷你知识库"带去跑步时用语音模式交互。
但 Karpathy 自己也承认,这个方案的适用范围是"小规模"。当文件数从 100 增长到数千甚至上万时,LLM 无法在上下文窗口里装下所有索引文件,grep 的关键词匹配也无法处理语义搜索需求——"最大风险"这个查询不会命中一篇标题叫"竞争壁垒"的文章。
GBrain 就是在这个断裂点上接手的。
GBrain 的技术架构:9 张表 + 三层搜索 + RRF 融合
GBrain 的数据库层由 Postgres + pgvector + pg_trgm 三个扩展撑起,托管在 Supabase Pro(25 美元/月,8GB)上。核心是 9 张表:pages 存储编译真相和时间线、content_chunks 存储分块后的嵌入向量(1536 维,text-embedding-3-large)、links 存储实体间的有向关系图。
搜索流程分四步。第一步,用 Claude Haiku 做多查询扩展——把用户输入"什么时候该忽略传统智慧"拆成"逆向思维创业""逆流而上"等多个变体。第二步,向量搜索(HNSW 余弦相似度)和关键词搜索(tsvector + ts_rank)并行执行。第三步,用 Reciprocal Rank Fusion(RRF)把两路结果融合,公式为 score = sum(1/(60 + rank))。第四步,四层去重:每页取最佳 chunk、余弦相似度 > 0.85 的合并、类型多样性 60% 上限、每页 chunk 数上限。 分块策略有三种可选:递归分块(300 词 + 50 词重叠,用于批量导入)、语义分块(逐句嵌入后用 Savitzky-Golay 平滑找主题边界,用于编译真相)、LLM 引导分块(Claude Haiku 在滑动窗口中识别主题转换,成本最高但质量最好)。
数据模型值得注意的是"编译真相 + 时间线"的双层结构:分割线以上是当前最佳理解,会随新证据被重写;分割线以下是追加式证据链,只增不改。这个设计来自情报分析方法论,确保每个知识点都可溯源。
与竞品对比:Brainfork、Obsidian 原生、传统 RAG 各有短板
Brainfork 是另一个面向 OpenClaw 的记忆插件,采用托管服务模式,每月起步价加上按量计费。优势是即插即用,不需要自己管数据库;劣势是数据主权问题——你的知识存在别人的服务器上,且在 100k 行时放弃了 SQLite 转向自有后端。GBrain 的数据完全在你自己的 Supabase 实例里,可以随时导出为 Markdown。
Obsidian + LLM(Karpathy 原版方案) 适合 100-500 篇文章的个人研究场景,零基础设施成本,LLM 自己管理索引。但没有真正的语义搜索,不支持多查询扩展,且随着语料增长会撞上上下文窗口天花板。
传统 RAG(Pinecone/Weaviate/Qdrant + LangChain) 在大规模向量检索上性能更强,Pinecone 在数百万向量场景下延迟更低。但它们是纯向量方案,缺少 GBrain 的混合搜索和 RRF 融合,也没有内置的知识模型(编译真相、时间线、实体链接)。部署复杂度和成本也更高——Pinecone 从原型阶段的 70 美元/月到 800 万向量时可以飙到 2800 美元/月。
pgvector 本身的边界也需要说清楚:据多个基准测试,pgvector 在 1000 万向量以下表现良好,超过这个规模后索引构建时间和内存压力会显著上升。对于个人知识库场景(GBrain 测算 7500 页约 22000 个 chunk),这个上限足够。
实际部署:成本、依赖和上手门槛
GBrain 需要三个外部依赖:Supabase Pro 账号(25 美元/月)、OpenAI API key(初始嵌入 7500 页约 4-5 美元)、Anthropic API key(多查询扩展和 LLM 分块用 Haiku)。没有 OpenAI key 可以退化为纯关键词搜索;没有 Anthropic key 可以跳过多查询扩展。
推荐的安装方式是通过 OpenClaw 一键部署:粘贴一段指令,OpenClaw 会自动安装 bun、运行初始化向导、扫描本地 Markdown 仓库、导入并验证搜索功能。也支持 ClawHub(clawhub install gbrain)或独立 CLI(bun add -g gbrain)。
导入 7000 个文件的文本处理约 30 秒,嵌入约 10-15 分钟。导入是幂等的,通过 SHA-256 内容哈希跳过未变更文件。后续通过 gbrain sync --watch 轮询 git 仓库增量同步。
存储方面,7500 页的完整脑容量约 750MB(含 HNSW 索引开销 270MB),Supabase 免费层的 500MB 放不下,至少需要 Pro 层。
局限性和风险
GBrain 目前的局限很明确。第一,SQLite 引擎只有设计文档还没有实现,意味着必须依赖 Supabase 或自建 Postgres,没有本地零成本方案。第二,项目只有 Garry Tan 一个贡献者、14 个 star(截至发稿),尚未经过社区大规模验证。第三,嵌入模型绑定 OpenAI 的 text-embedding-3-large,如果想切换到开源嵌入模型需要自行适配。第四,MCP 服务器提供 21 个工具,但目前没有权限控制——任何连接到 MCP 的客户端都能读写你的整个知识库。第五,编译真相由 AI 代理维护和重写,存在幻觉风险——如果 LLM 在实体之间建立了错误关联,这个错误会被持久化到知识库中。
对于 ChooseAI 的用户画像(16-40 岁、非技术背景居多)来说,GBrain 的上手门槛偏高:需要理解 Supabase、API key 配置、CLI 操作。更适合有开发能力的 AI 重度用户,而不是普通工具浏览者。
谁应该关注 GBrain
GBrain 填补的是一个真实存在的空缺:当你的个人知识库超过了 LLM 上下文窗口能装下的规模,但又没大到需要企业级向量数据库的程度时,它提供了一个成本可控(约 30 美元/月)、数据自主、搜索质量可靠的中间方案。对于已经在用 OpenClaw 做日常工作的开发者和知识工作者,GBrain 是目前最接近"可用的个人第二大脑后端"的开源选项。但它仍处于极早期(v0,5 个 commit),押注前需要评估项目持续维护的可能性。
 AI 速览