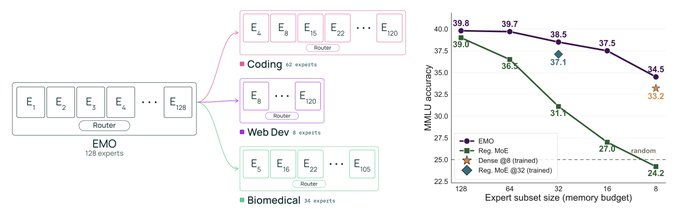
5月9日消息,Allen Institute for AI(Ai2)正式开源 EMO,一款总参数 14B、活跃参数 1B 的混合专家(MoE)模型,每 token 从 128 个专家中激活 8 个,在 1T tokens 上完成预训练。EMO 的最大特点是模块化结构完全从数据中自然涌现——无需人为预定义任何先验领域标签,专家分组通过文档边界约束自发形成。零微调情况下,仅保留 25% 的专家整体性能下降约 1 个百分点,保留 12.5% 也只下降约 3 个百分点。
EMO 模型本体、配套的标准 MoE 基线模型、完整训练代码同步开源在 Hugging Face 与 GitHub。这套发布组合明确指向"邀请社区共同研究数据驱动模块化"的研究路径,而不是单纯发一个新模型。
文档级共享池:让模块化从数据涌现的核心机制
EMO 的方法论比想象中朴素。核心约束只有一条:同一篇文档内所有 token 必须从一个共享的专家池中选择激活专家,不同文档可以使用不同的池。在 128 总专家、8 活跃专家的架构下,文档内 token 从一个 32 专家的共享池中选 8 个。
这个看似简单的约束恰好契合预训练数据的天然结构——同一篇文档内的 token 通常共享主题领域(一篇医学论文里的 token 大概率都涉及医学)。EMO 把这个数据先验直接编码进路由约束,迫使语义相近的 token 走相似的专家路径。结果是无需任何人为标注,专家分组就在预训练过程中自发形成连贯结构。
这条路径与 Ai2 此前的 FlexOlmo、Meta 的 BTX 等项目形成对照。后者尝试用"数学、生物、代码"等预定义语义领域显式路由 token,但存在两个硬伤:跨语料的领域标签获取昂贵且模糊;推理时若出现训练阶段未定义的新领域,模型无法决定该调用哪些专家。EMO 用文档边界这个无需标注的天然信号替代了人工标签,模块化结构因此具备开放性,不被训练阶段定义的领域清单锁死。
12.5% 专家保留下的鲁棒性数据
性能数据是 EMO 最反直觉的部分。在不做任何微调的前提下,按语义相关性筛选并保留专家子集后,保留 25% 专家整体性能仅下降约 1 个百分点,保留 12.5% 专家整体性能下降约 3 个百分点。
作为对比,标准 MoE 模型在同等压缩比例下性能会大幅崩盘——这也是 Ai2 同步开源基线 MoE 模型的用意所在,让社区可以直接对比验证。EMO 的专家子集甚至能在内存受限场景下匹配或超越从零训练的同等内存小模型,这意味着 EMO 不再是"加载全模型才有用的稀疏架构",而是真正可以按需裁剪的模块化系统。
对实际部署而言,这组数据的意义直接而具体。一个 14B 总参数的 MoE 模型,在保留 12.5% 专家时的工作内存需求接近 2B 量级,但能力退化只有 3 个百分点。这条曲线让"按领域裁剪后部署"从理论走向工程可行——电商客服、医学问答、法律分析等垂直场景可以直接加载最相关的专家子集,而不必为单一任务背着全模型的内存账单。
专家围绕语义领域聚类 vs 传统 MoE 表面模式
EMO 另一个值得关注的发现是专家聚类的语义层级。可视化结果显示,专家自动围绕健康、新闻、政治、影视音乐等真实语义领域形成集群。
这与传统 MoE 的专家分化模式形成鲜明对比。早期 MoE 研究反复观察到的现象是:未经引导的专家路由往往收敛到"介词、冠词、标点符号"等浅层语言学特征,专家之间的差异主要体现在表面 token 模式而非深层语义。这种聚类对模型推理性能或许影响不大,但对"按领域选择性部署"这一目标几乎毫无用处——无法说"加载介词专家而不要冠词专家"。
EMO 的语义级聚类则让"选择性部署"具备真实可操作性。给定一个垂直任务,可以直接定位与之相关的专家集群(健康场景调健康集群,新闻场景调新闻集群),剩下的部分可以从内存中卸载。这是从研究层面到工程层面都能落地的模块化能力。
同步开源基准 MoE 与训练代码
Ai2 这次的发布策略值得单独提一句。除了 EMO 主模型,团队还开源了一个匹配规格的标准 MoE 基线模型——同样 14B 总参数、1B 活跃、128/8 专家配置、1T tokens 训练,唯一区别是不施加文档级共享池约束。这相当于把对照实验直接交到社区手里,研究者可以在同等条件下验证"模块化涌现"的实际收益,而不是只能看 Ai2 自己给出的数字。
完整训练代码也同步公开。结合 Ai2 在 OLMo、Tülu、FlexOlmo 等项目上一贯的"模型加数据加代码加论文"全栈开源传统,EMO 实质上把 MoE 模块化研究的门槛拉到了"任何有 1T token 算力的团队都可以复现"的水平。
局限性
EMO 当前公开的性能曲线主要由 Ai2 自测,第三方独立评测尚未铺开。1B 活跃参数的规模在当前 MoE 旗舰阵营中属于中等偏小,与 DeepSeek V4、Kimi K2、Qwen3-Next 等百亿活跃参数级别的旗舰模型相比,EMO 的能力上限受规模限制存在天然差距。文档级共享池约束依赖训练数据中"文档边界等同于领域边界"这一假设,对于多领域混合长文档(如学术综述、新闻汇编)这一假设可能失效,对应的专家路由质量需要更多验证。专家子集的"语义相关性筛选"具体如何执行——是关键词路由、聚类标签、还是另需推理时确定——目前公开材料未给出可直接复用的工程方案。当模块化部署真正进入生产环境,子集选择本身可能成为新的工程开销,这部分成本与"裁剪后省下的内存"之间的权衡有待社区案例验证。
 AI 速览