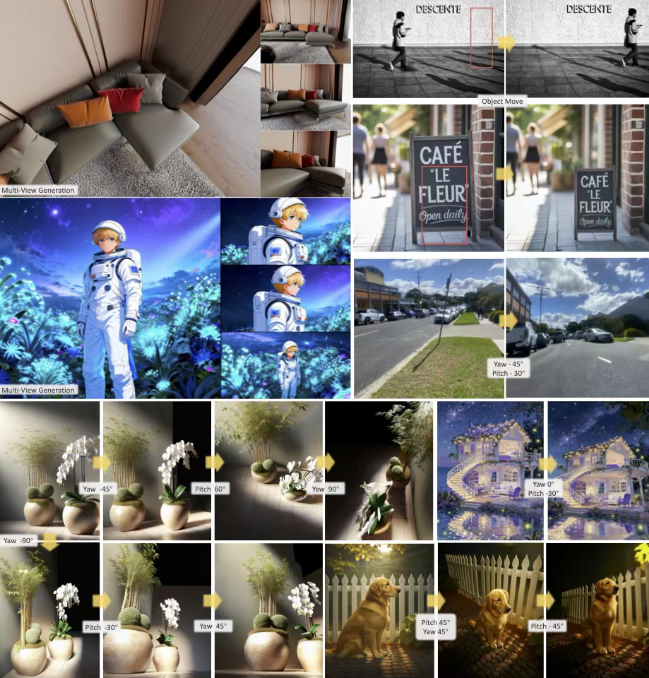
2026年4月11日,京东探索研究院正式开源240亿参数图像AI模型JoyAI-Image-Edit,以Apache 2.0协议完全开放,业内首次实现空间智能架构底层嵌入,性能超越Nano Banana 2、Qwen-Image-Edit等模型,标志图像AI从“平面生成”迈入“空间理解”新阶段。
一、核心技术突破
架构创新:80亿参数多模态语言模型+160亿参数多模态扩散Transformer,实现理解、生成、编辑闭环协同。
空间编辑能力:支持相机控制、物体旋转、空间位移三大核心操作,保持透视、遮挡、光影逻辑一致,不穿帮、不变形。
通用能力:兼容替换、删除、长文本渲染等15类常规编辑,兼顾空间可控与实用效果。
二、核心优势与性能
空间一致性行业领先,可精准执行视角变换、物体挪动、姿态调整。
兼容ComfyUI、Diffusers,开箱即用,支持商用与二次开发。
多项评测力压同类模型,成为图像编辑领域新标杆。
三、核心应用场景
电商场景:一张商品图生成多视角、多场景展示图,大幅降低拍摄与设计成本。
具身智能:为机器人提供空间理解与动作预演,解决训练数据稀缺难题。
设计与创作:可控编辑、空间重构,提升内容生产效率与真实感。
四、京东AI战略意义
不追风口、深耕产业场景,聚焦零售、物流、具身智能等核心领域落地。
与JoyAI大模型、JoyStreamer数字人、具身智能JoyInside形成完整技术矩阵。
以开源推动空间智能普及,为AGI提供关键空间理解能力。
京东JoyAI-Image-Edit让AI真正看懂3D空间,是图像AI的范式升级,也是电商与具身智能的重磅生产力工具。
 AI 速览