做了两年 RAG 的团队现在大概都意识到一个问题:企业知识库里真正难啃的根本不是文本,是 PPT 里的图表、产品手册里的接线图、培训录播里的讲师板书、客服视频里的操作演示。传统 RAG 的管线对这些内容只有一种办法——先转成文字,再走老流程。
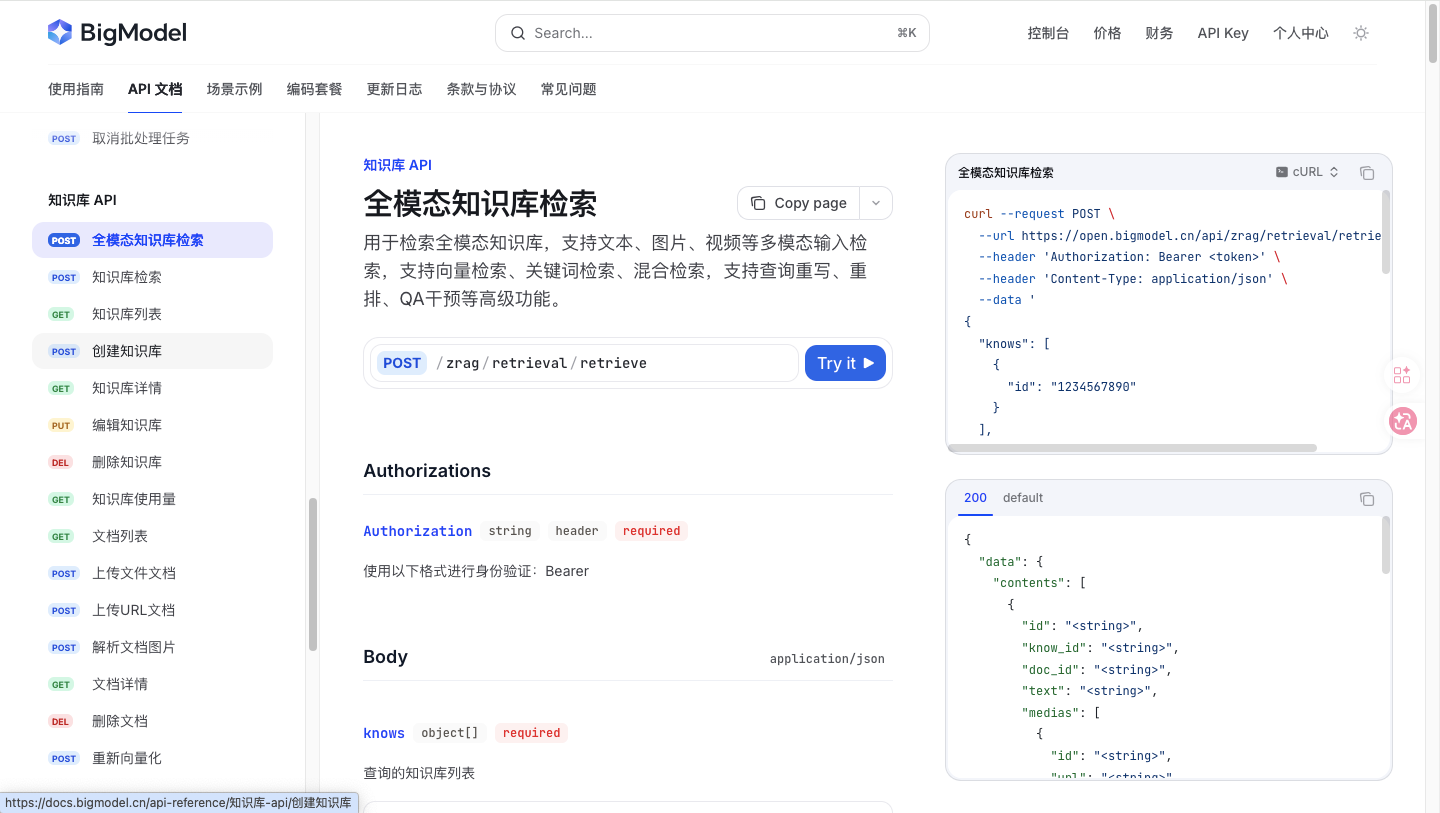
4月15日,智谱在 BigModel 开放平台上线了 GLM 全模态知识库,主打文本、图片、音频、视频四模态原生入库与跨模态召回。这篇文章把它和目前市面上主流的六套 RAG 方案——阿里云百炼、RAGFlow、Dify、FastGPT、腾讯 IMA——拉到同一张桌子上对比,看看"全模态"在 2026 年到底意味着什么,以及不同业务场景该怎么选。
一、文本 RAG 为什么只看懂了一半世界
传统 RAG 的三步管线很清晰:文档解析 → 切片 → 向量化检索。问题出在第一步。
一份带图表的产品手册进来,OCR 先把页面文字抠出来,图片往往被扔掉或者用 caption 模型生成一句描述,表格被拍平成行列字符串。一段 30 分钟的讲师录播视频进来,ASR 转个语音稿,画面里的板书、PPT 截图、演示操作——全部丢失。最后向量化的是一堆文本 token,所有视觉层面的"空间关系、颜色标注、流程连线",在送进 embedding 之前就已经残缺。
阿里云百炼团队开源 V-RAG 方案时讲过一个观察:完全采用视觉模型直接识别 Page 内容,把每个 Page 当做一个切片,避免了传统 Chunk 切分导致的信息丢失,在产品操作手册、长篇论文这类 Page 结构完整的文档上,效果提升立竿见影。这句话其实点破了多模态 RAG 的核心思路:不再把图片/视频"翻译"成文字,而是让多模态 embedding 模型直接把原始形态塞进向量空间。
沿着这条路走下去,2026 年一线厂商的知识库产品开始分化出两条路径:一条是"保留原模态直接向量化"(智谱 GLM、阿里云百炼),另一条是"继续走文本化但把解析做到极致"(RAGFlow、腾讯 IMA)。
二、智谱 GLM 全模态知识库:能力拆解
GLM 全模态知识库这次升级的核心,是把"存进去什么格式,就能检索出什么格式"这件事做完整了。具体四块能力:
2.1 四模态统一入库
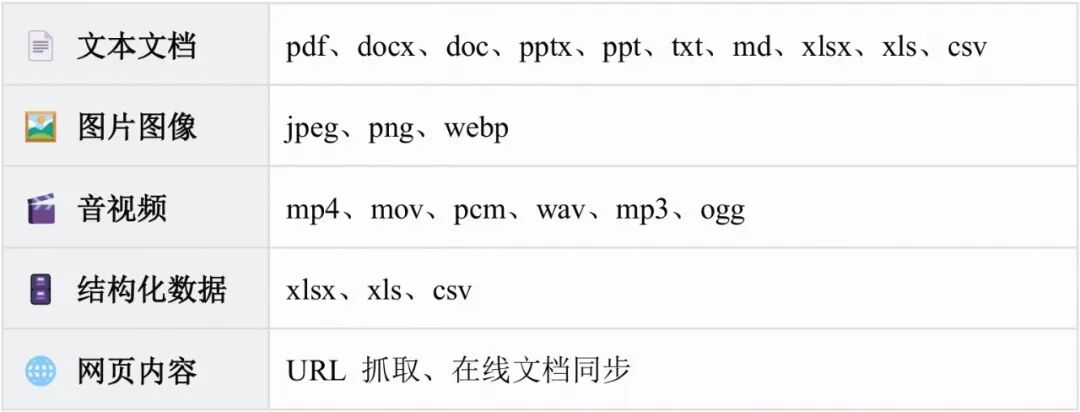
文本、图片、音频、视频一个入口上传,自动识别类型并结构化存储,支持批量导入和增量更新。不同于"图片走 OCR 文本化、视频走 ASR 文本化"的拼装式多模态,GLM 走的是多模态 embedding 直接入库的路线——这意味着图表的趋势、画面里的颜色/物体、讲师的手势,都能以原始形态参与检索。
2.2 段落级 / 时间戳级定位
文档类内容定位到段落切片,音视频精确到时间区间。这对企业级场景很关键:客服回答需要跳到视频的第 37 秒,合规审计需要回到 PDF 的具体段落,不能只给一个整文档链接。
2.3 图文混排输出与溯源
检索结果按原模态呈现:文档段落直接引用原文,视频命中就给时间戳片段,图片就返回原图。每条结果可点击跳回原始来源。这个设计让知识库的输出可以直接贴到报告/培训材料里,不用再做"从 AI 回答里找配图"的二次工作。
2.4 检索参数全开放
这一项是企业级 RAG 的分水岭。GLM 全模态知识库把四组参数开放给开发者:
- 问题改写(Query Rewrite):把用户口语化提问改成更易检索的查询
- 召回分数阈值 / 数量调整:控制严格度与完整度的取舍
阿里云百炼的知识库同样提供 Rerank(推荐使用 qwen3-rerank(hybrid),综合语义相关性与 BM25 匹配特征,适合需要精确关键词命中的查询),但把所有参数一次性开放并且对接多模态检索链路的产品并不多。
2.5 素材层再创作
GLM 全模态知识库还能直接作为素材库输出图文并茂的内容。比如输入"以海边听音乐为主题写一篇 600 字作文",产品会先在知识库里找语义相关的海边图片,再生成文字内容,图片直接嵌在输出里——这对做培训材料、产品方案、内容营销的团队来说是个切实的减负。
三、三个官方案例:看看"全模态"究竟在干什么
光看参数意义不大,看智谱放出来的三个案例更直观:
案例一:视频里的图表检索
提问:"2017 年茅台的茅台酒销量比 2018 年少多少万吨?"
这是个典型的"答案藏在视频图表里"的问题。文本 RAG 基本无解——ASR 转出来的讲解稿里可能压根没念出这两个具体数字,数字就画在柱状图上。GLM 全模态知识库直接命中视频中的图表,把关键数字纳入检索链路,返回 0.23 万吨。
案例二:视频内容结构化召回
提问:"教师在实际教学中想要呈现与学生活动为主的课堂,需要做到哪四个关注?"
这是课堂录屏里的知识点,问的是"四个关注"这种结构化答案。基于视频的跨模态向量语义索引,模型完整召回了课堂录屏中的四项关键信息。
案例三:14 个混合文档精准溯源
提问:"蜘蛛侠在街道上飞行时用蛛网抓住的那辆车是什么颜色?"
知识库里灌了 14 个混合文档,包含 PDF、音视频、图片。GLM 全模态知识库不仅给出正确答案,还把溯源定位到了对应视频片段的具体时间戳。这是企业级合规场景(金融、医疗、法务)最看重的能力——可查、可验、可复核。
四、六大知识库平台横评:谁适合谁
| | | | | |
|---|
| | 全开放(Rewrite/Rerank/混合/阈值) | | | |
| 多模态向量(qwen3-vl-embedding),视觉整页切片 | | | | |
| 文档侧最深(DeepDoc + OCR + 版式分析);多模态需外接 | | | | |
| | | | | |
| | | | | |
| | | | | |
4.1 阿里云百炼:GLM 的直接对手
阿里云百炼是目前多模态 RAG 另一极的代表。它在"视觉理解(富文本文档)"场景下使用 qwen3-vl-embedding 多模态向量模型,不走传统文本切片而是基于视觉索引对文档整页理解,同时提供独立的"音视频搜索"知识库类型,支持 MP3/WAV/AAC/MP4/AVI/MOV 等主流音视频格式。
和 GLM 的核心差异在两点:一是阿里把 V-RAG 视觉 RAG 方案开源了,对有技术实力的团队留出了定制空间;二是阿里绑定的是千问系列向量和解析模型,智谱绑定的是 GLM 家族。如果你的业务已经深度接入阿里云生态(OSS、ADB-PG、百炼 Agent),百炼天然顺手;如果在意中文底座模型的独立性或已经在用 GLM,智谱这套整合度更高。
4.2 RAGFlow:文档解析的天花板
RAGFlow 更偏"RAG 引擎/底座",强调深度文档理解与引用追溯,对复杂格式更友好。它内置 OCR、版式分析算法,支持 PDF/Excel/PPT 等多格式结构化提取,通过文本切片、向量检索与混合搜索(关键词+语义)提升答案准确性,自动标注答案在原文中的位置。
但 RAGFlow 的多模态是"深度文档理解"意义上的多模态——它把 PDF 里的表格、版式、图表解析得很好,但原生的图片向量化、视频 embedding 并不是它的强项。RAGFlow 的不适用场景明确包含"开发多模态应用(如结合文本+图像生成)"。在 GLM 全模态知识库或阿里百炼已经做到原生视频检索的 2026 年,RAGFlow 更适合放在"文档解析底座"的位置,和 GLM 之类的多模态 RAG 产品互补。
4.3 Dify:RAG 是工作流的一部分
Dify 是低代码通用 AI 应用开发平台,通过可视化界面拖拽编排工作流,无需编码即可调用大模型能力。Dify 支持大量外部拓展工具,新工具的支持更便利,任务流编排良好。
但说到纯 RAG 能力,Dify 实际测试中检索效果不佳,经常召回不到正确内容——这也是为什么现在出现了 "Dify + RAGFlow" 或 "Dify + 第三方知识库"的组合架构。对于多模态需求,Dify 本身不具备原生支持,需要在工作流里拼接外部多模态模型。现实可行的组合是:Dify 做工作流编排 + GLM 全模态知识库作为外部 RAG 服务。
4.4 FastGPT:快速搭原型的选择
FastGPT 在 README 里提到"混合检索 & 重排、RAG 模块热插拔",给了 Docker Compose 快速部署路径,入门成本低。中文社区活跃、部署简单、QA 模式开箱即用,非常适合中小企业在一两周内搭一个"特定行业知识库智能客服"的雏形。
但 FastGPT 的短板也清晰:多模态不是核心方向,视频、音频这类场景基本需要另想办法。如果业务一开始就有大量音视频素材,从 FastGPT 起步后期迁移成本不低。
4.5 腾讯 IMA Copilot:个人侧的舒服选择
腾讯 IMA 的定位和前面几家不在一个赛道。IMA 支持 PDF、Word、PPT、图片、Markdown 等多种格式,单次最多可上传 10 个文件,内置 OCR 能自动识别并提取图片中的文字信息,但图片仍然走的是 OCR 文本化路径,音视频原生支持有限。
IMA 实际体验上混元大模型可以进行多模态识别图片中的物体,而 DeepSeek-R1 只能识别图片中的文字部分。所以它的多模态能力更多停留在"读图"而非"图片向量检索"层面。配合微信生态(公众号文章、视频号、小程序入口)的便利性,它在个人知识管理、小团队协作场景很顺手,但做不了企业级千万文档 + 多模态混合检索这类需求。 五、选型决策路径:按场景开单
技术参数说完,回到最实际的问题:你现在面临的需求,该选谁?
场景 A:有大量培训视频/操作录屏/图表文档,需要跨模态检索 → 首选 智谱 GLM 全模态知识库 或 阿里云百炼。两家都是原生多模态路线,都支持时间戳级溯源。深度绑阿里云生态选百炼,在意 GLM 模型链路一致性选智谱。
场景 B:合规/金融/医疗,重扫描件和复杂 PDF 解析 → RAGFlow 做解析底座 + GLM 全模态知识库做素材层和多模态补充。RAGFlow 的文档侧引用追溯能力在开源圈第一梯队,适合要求答案可追溯至原文条款的合规场景。
场景 C:主做 Agent / 工作流产品,RAG 只是其中一环 → Dify 做编排 + GLM 全模态 / 阿里百炼做外部知识库。Dify 的工作流能力替代不了,但它自己的 RAG 别硬用。
场景 D:中小企业两周内上线第一个知识库客服 → FastGPT 起步,业务跑通后再评估是否迁移到 GLM / 百炼。
场景 E:个人/小团队,想要一个"第二大脑",重微信生态 → 腾讯 IMA,别折腾企业级 RAG 了。
场景 F:企业内部千万级文档 + 严苛数据合规 + 多模态 → 走私有化路径,评估 阿里百炼 V-RAG 开源版,或等待 GLM 全模态知识库的私有化方案(截至发稿,智谱官方未明确给出私有化部署细节,需与商务沟通)。
六、一个被低估的维度:检索参数开放度
横评完再回头看,GLM 全模态知识库和阿里百炼之间的真正差异,其实藏在一个容易被忽略的细节里:检索参数到底开放到什么程度。
问题改写能决定"用户口语化提问"的召回命中率;Rerank 决定多段相似内容里谁排在前面;召回分数阈值决定是宁缺毋滥还是宁多勿少;混合检索配比决定长尾关键词(编号、术语、人名)能否被稳定抓到。这些参数任何一个被锁死,企业级场景就会出现"效果调不动"的窘境。
GLM 全模态知识库把这四组参数全部开放;阿里云百炼开放了 Rerank 和阈值、排序模型可选 qwen3-rerank 或 hybrid;RAGFlow 在混合检索权重上给了控制;Dify 和 FastGPT 更偏工作流层的调参;腾讯 IMA 基本不开放。这个维度在选型时常被忽视,但真上线之后,它决定了你能不能从 70 分优化到 90 分。
总结
2026 年的 RAG 赛道已经不是"谁的向量模型更准"这种单点比较了。企业真实需求是"多模态 + 精准溯源 + 参数可控 + 能嵌进业务工作流",每一项都得在线。
智谱 GLM 全模态知识库的位置很清楚:它是目前少数把"四模态原生入库 + 时间戳溯源 + 检索参数全开放 + 素材层再创作"凑齐的产品之一,直接对标阿里云百炼的多模态 RAG 能力。在 GLM 模型生态里做多模态 RAG,它是最顺手的那一个。
如果你的业务里有大量视频、图表、音频素材,而不是纯文本文档,是时候跳出"文本 RAG + 接一堆解析器"的老架构了——全模态检索已经不是未来,是 2026 年的基本款。
 AI 速览