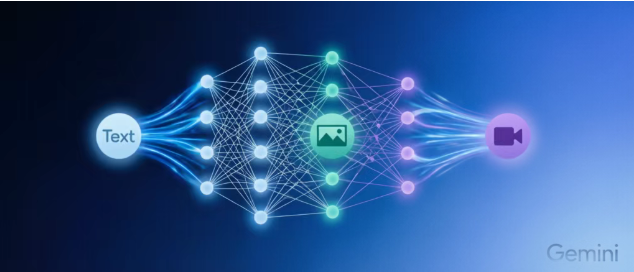
说实话,这次谷歌发布的东西,在AI圈子里其实没引起太大水花,但如果你了解一点技术背景,应该能感觉到这事儿不小。北京时间3月11日凌晨,谷歌发布了全新的Gemini Embedding 2模型,这是谷歌首个原生多模态嵌入模型,能把文本、图像、视频、音频和文档全都映射到同一个嵌入空间里。说白了,就是让机器在理解不同类型内容这件事上,往前迈了一大步。 嵌入模型是干啥的,跟Gemini 3这类生成式模型有啥区别
这俩其实完全是两条路。Gemini 3这类生成式模型,主要负责"生产内容"——写文章、回答问题、画图;而嵌入模型干的是另一件事:把文字、图片、视频之类的数据转换成向量这种数学形式,让机器能"读懂"它们之间的关系。
打个比方,你搜"苹果",关键词检索会把所有含"苹果"的页面都扒出来,但嵌入模型能理解你到底是想查水果还是那家手机公司,然后给你更准的结果。语义搜索、分类、聚类这些应用场景,背后靠的就是这类模型。
Gemini Embedding 2能处理哪些内容
谷歌最早推出的嵌入模型只支持文本,这次Gemini Embedding 2直接打通了五种数据类型,还能在100种语言里识别语义意图——这个跨度挺大的。
具体的处理限制你可以参考一下:文本方面,上下文窗口最高支持8192个token;图像每次请求最多6张,格式限PNG和JPEG;视频最长支持120秒输入,支持MP4和MOV;音频可以直接处理,不用先转成文字;文档则支持最多6页的PDF。
值得一提的是,这个模型还可以在一次请求里同时接收"图像+文本"这类混合输入,分析不同媒体类型之间的关联,这个能力在过去是做不到的。
实际能用在哪
谷歌给了个挺具体的例子:诉讼取证阶段,律师要从海量记录里找关键证据,靠人工翻几乎不现实。测试结果显示,多模态嵌入在数百万条记录中,能明显提升检索的精度和召回率,图像与视频搜索的效果也跟着改善了。
当然法律场景只是其中一个,检索增强生成(RAG)、语义搜索、情感分析、数据聚类……这些领域理论上都能用上。
尤其是RAG,现在很多大模型应用都依赖这套机制来扩展知识边界,如果嵌入层能同时处理多模态内容,整个链路的能力上限就不一样了。
现在能用吗
目前Gemini Embedding 2(模型标识为gemini-embedding-2-preview)已经通过Gemini API和Vertex AI开放公开预览,你可以直接去试。
另外,原来的gemini-embedding-001还在,如果你的应用场景只涉及文本处理,继续用旧版也没问题。
多模态嵌入这个方向,说起来并不新鲜,但真正做到把文本、图像、视频、音频、文档统一放进同一个嵌入空间,谷歌这次算是走到了前面。
从实用角度看,Gemini Embedding 2最大的价值不在于炫技,而在于它能把原本需要多套系统分别处理的内容,整合进一个统一的语义框架里。对开发者来说,这意味着构建复杂多模态应用的成本可能会显著降低——这才是这个模型真正值得关注的地方。
 AI 速览