4月16日消息, Anthropic 发布 Claude Opus 4.7,定位为其当前面向所有用户的最强通用模型。官方数据:SWE-bench Verified 87.6%、SWE-bench Pro 64.3%、Terminal-Bench 2.0 69.4%、Finance Agent v1.1 64.4%,CursorBench 70%(较 4.6 提升 12 个百分点),在 Anthropic 93 题内部编码基准上解决率提升 13%,视觉锐度从 4.6 的 54.5% 跃升至 98.5%,输入图像分辨率上限提升到 3.75MP。价格维持 Opus 4.6 水平,$5 / 百万 input token、$25 / 百万 output token,prompt caching 最高 90% 折扣、batch 50% 折扣。 但能力本身只是地基。Claude Code 创始人 Boris Cherny过去几周在内部"dogfooding"Opus 4.7,发现同样的模型配不同工作流,产出相差 2-3 倍。他在推文线程里抛出 6 个实战技巧,Anthropic 官方博客《Best practices for using Claude Opus 4.7 with Claude Code》也同步刷新了推荐配置。这篇文章把两份官方材料合并,补上在 Cursor、OpenAI Codex、GitHub Copilot 上同类特性的横向对照,给出一份可以立刻上手的操作清单。 为什么 Opus 4.7 需要重新调参
4.7 不是 4.6 的等比例升级,官方特别点明两处会影响 token 账单的变化,忽略这两点迁移后很可能出现"账单暴涨 + 速度变慢 + 质量没感觉变好"的错觉:
- 新 tokenizer:同一段输入,token 数较 4.6 增加 1.0–1.35 倍,具体取决于内容类型(代码、中英文混排、长 diff 差异较大)。production 流量切过去前应重新跑一遍成本估算。
- 高 effort 思考更多,尤其在 agentic 长 session 的后段:可靠性提升的代价是 output token 变多。Box AI 负责人 Yashodha Bhavnani 公开反馈 4.7 在其内部评测里"保持 4.6 质量的同时实现了可观的效率提升",但 Hex 等合作方也提到 4.7 "更愿意深思、在自己不确定时会直说 data missing 而不是编造 fallback"——换句话说,它会"磨"更久。
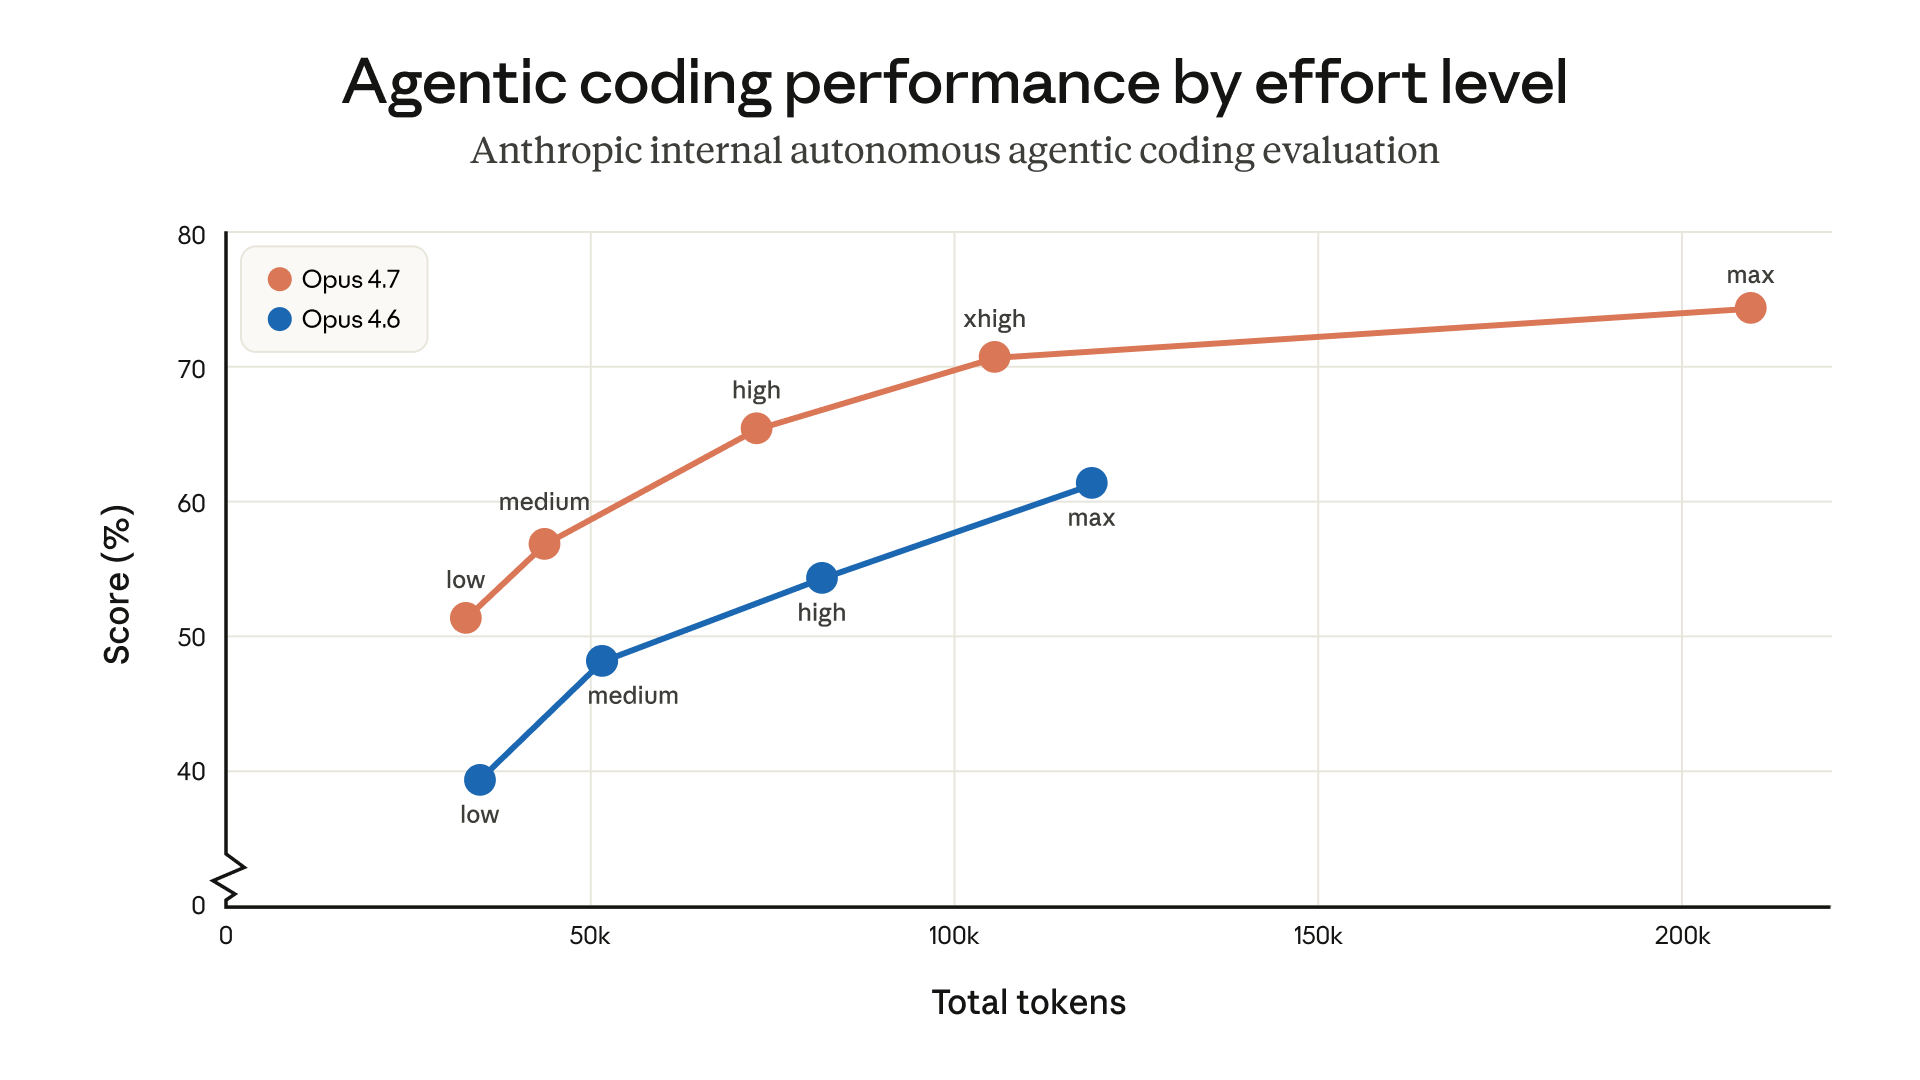
Anthropic 官方基准还给出一个更直观的信号:Opus 4.7 在 low effort 下大致等于 Opus 4.6 在 medium effort,这意味着成本敏感场景升到 4.7 反而可以把档位下调。
技巧 1:Auto Mode——让 Claude 自己判断命令是否安全,停止敲 y/n
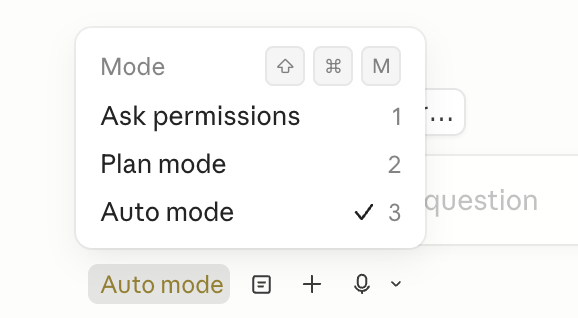
Claude Code 原本采用"逐条命令请求授权"的机制,遇到长任务时体验极差——你得一直盯着屏幕按 Enter。Auto Mode 用模型分类器自动判断 bash / MCP 命令的风险:安全就直接执行,有风险才弹确认。 - 启用方式:CLI 下按 Shift + Tab 切换;Desktop / VSCode 从下拉菜单选。
- 可用范围:Claude Code Max 用户以研究预览形式开放(Teams / Enterprise 后续跟进)。
- 最适合的场景:深度研究、大规模重构、端到端新功能开发;同时开多个 Claude Code session 并行跑不同任务。
- 对照竞品:Cursor 3 的 Agent 模式有独立 yolo 模式类似理念;OpenAI Codex 4 月 16 日桌面更新新增"Computer Use 后台并行"能力,允许多个 agent 同时操作 macOS 应用而不抢焦点,但仅限 Mac、不在 EEA / 英国 / 瑞士开放;Google Antigravity 则走"任务队列 + 审批面板"思路。Auto Mode 的差异点在于"按会话授权 + 模型分类器 + 白名单记忆"的组合粒度。
技巧 2:/fewer-permission-prompts——让安全命令进白名单,一键少敲几百次回车
如果你不放心直接开 Auto Mode,也可以走渐进路线。/fewer-permission-prompts 是新技能,会扫描你的历史 session,找出那些"明显安全却反复弹窗"的 bash / MCP 命令(例如 git status、ls、npm test),推荐添加到权限白名单。
Boris Cherny 本人在 1 月那波 13 条 CC 使用技巧里就强调过:"Most sessions start in Plan mode (shift+tab twice)"——他倾向保留人机界面的明确性。/fewer-permission-prompts 更像是把 Auto Mode 拆成可审计的子集:你知道自己允许了什么,不会被无声代执行。
技巧 3:Recaps——离开一小时回来,先看一页摘要再接手
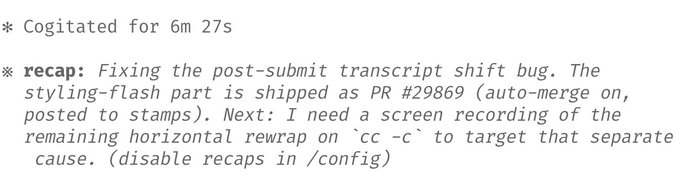
长 agentic 任务的最大痛点不是 AI 写得差,而是你中途离开之后回来不知道它走到哪、接下来要干什么。Recaps 会在任务运行一段时间后自动产出简短摘要:之前做了什么、下一步是什么、中间踩过什么坑。
这和 Opus 4.7 官方强调的"carries context across sessions more reliably"是一套组合拳——Anthropic 在 4 月 15 日单独发布了一篇《Using Claude Code: session management and 1M context》的姊妹博客,配合 1M token 上下文窗口与自适应记忆,长项目跨多天接续的可用性明显优于 Codex 的"Memory + Heartbeat Automations"方案(后者目前需 Enterprise / Edu / EU / UK 之外的地区才能拿到个性化记忆预览)。
技巧 4:/focus——隐藏中间过程,只看最终结果
4.7 的可靠性到了一个关键临界点:Boris 本人用下来的感受是"我现在信任模型,只看最终输出就够了"。/focus 切换专注模式,隐藏所有中间工具调用、思考 trace、自检过程,只呈现最终 diff、测试结果、PR 链接。
这对看惯 Cursor "内联 diff 预览 + tab 补全"的人可能是反直觉的选择——Cursor 强调每一步都可见、可即时纠正;Claude Code 的 /focus 则押注"让模型把事情办完、别打扰我"。选择哪条路线取决于你的心智模型:你是想要"AI 实习生"(看他每步)还是"AI 中级工程师"(看最终交付)。
技巧 5:/effort——从 low 到 max 的五档思考档位
Opus 4.7 是首个把 effort 档位提到用户面前的 Claude 模型。Anthropic 在 Claude Code 里新增了一档 xhigh,介于 high 与 max 之间,并把它设为默认:
| | |
|---|
| | 即使低档也优于 4.6 同档,有时 token 用得更少 |
| | |
| 大多数 agentic coding、API 设计、遗留代码迁移、大代码库 review | |
| | |
- 切换方式:CLI 输入 /effort。Boris 的个人工作流是"日常 xhigh,最难的任务临时切 max"——注意 max 只影响当前会话,其他档位会被记住。
- 重要转变:固定 thinking budget 在 4.7 上不再支持,模型改用 adaptive thinking(自适应思考),自己决定每一步要不要思考、思考多久。想让它想更久,就在 prompt 里直接说 "Think carefully and step-by-step before responding; this problem is harder than it looks";想让它快,改成 "Prioritize responding quickly rather than thinking deeply. When in doubt, respond directly."
和竞品的差异:OpenAI Codex 的 GPT-5.4 在 Codex CLI 里提供 reasoning.effort 字段,Cursor Composer 2 主打"token-to-money 比"而非显式档位,GitHub Copilot 则把 Opus 4.7 设为 7.5× premium request 乘数(4 月 30 日前促销价)。Claude Code 的五档体系把"思考成本—产出质量"权衡显式化,对习惯手动调参的重度用户更友好。 技巧 6:给 Claude 验证自己工作的能力——把产出拉高 2-3 倍
Boris Cherny 把这条放在最后,并明确说"这是最重要的一条"。原因是:Opus 4.7 的关键能力升级不是会写代码,而是会自己验证。Anthropic 官方博客原文:"the model devises ways to verify its own outputs before reporting back."
落地到工作流,就是按任务类型给它配"验证手段":
- 后端:让它自己启动本地 server 跑端到端测试、curl 接口、检查 response。
- 前端:搭配 Claude for Chrome 扩展,让它直接控制浏览器截图、点击、比对视觉。
- 桌面 App:用 Computer Use 工具在桌面应用里点按、输入、验证状态。
- 组合起来:Boris 常用的 /go skill 一次性完成"自己测试 → 简化代码 → 直接提 PR"。
竞品对照:OpenAI Codex 4 月 16 日的超级应用更新同样新增了内置浏览器(可在页面上逐元素评论)、gpt-image-1.5 原生图像生成、macOS Computer Use;Cursor 内置了 GA 版 browser、BugBot 自动代码 review(解决率从 52% 升到 70%+)。三者思路一致:让 AI 自己跑闭环。差异在于:Claude for Chrome 作为扩展是独立产品(Pro/Max 测试中),不绑定 IDE;Codex 的 Computer Use 目前仅限 Mac;Cursor 的 browser 深度绑定其 IDE。
官方博客补充的 3 条易被忽略的行为变化
Boris 的推文偏战术,Anthropic 官方博客《Best practices》额外给了三条"升 4.7 前必须知道的默认行为变化":
- 响应长度按任务复杂度校准:4.7 不再像 4.6 那样默认絮絮叨叨。简单查询更短,开放分析更长。如果你依赖固定长度 / 风格,显式写在 prompt 里,而且用正向示例("我想要这种风格")比用否定指令("不要这样")效果更好。
- 工具调用变少、思考变多:大多数场景下质量更高,但如果你的流水线依赖"激进搜索、频繁读文件",需要明写"在 X 情况下应调用 Y 工具"。
- 默认 spawn 更少 subagent:4.7 更谨慎地派生子代理。如果你的场景受益于并行(跨文件扫描、独立条目处理),Anthropic 推荐的 prompt 模板是:"Do not spawn a subagent for work you can complete directly in a single response (e.g., refactoring a function you can already see). Spawn multiple subagents in the same turn when fanning out across items or reading multiple files."
另外 Anthropic 官方强调了一条通用原则:把 Claude 当"可托付的工程师",而不是"结对编程伙伴"——把任务一次性说清(意图、约束、验收标准、相关文件路径),减少用户 turn 次数。每次用户 turn 在 4.7 上都会增加推理开销,这不仅影响 token 账单,也会因 context 被打断而降低 coherence。
如何选型:Claude Code / Cursor / Codex / Copilot 在 4 月 16 日这一天同时刷新
过去两周几乎所有头部 AI 编程工具都在同一时间窗完成了重要升级,做选型时建议别只看单一维度:
- Claude Code × Opus 4.7:上下文 1M token,xhigh 默认档位,Auto Mode + 自适应思考 + Recaps 组合对"长 session 无人值守"体验最成熟;Claude for Chrome / Computer Use 作为独立模块,前端 / 桌面验证闭环完备。适合:后端服务改造、大型单体重构、需要跨 session 携带上下文的多日项目。上手门槛:Pro $20/月起,Max $100/月起(Auto Mode 预览仅 Max)。
- Cursor 3 + Composer 2:内置 Composer 2 自研模型(主打 token-to-money 比 + 低延迟),同时可切 Opus 4.7、GPT-5.4、Gemini 3 Pro;BugBot 自动 PR review 已 GA;2026 年 1 月起推了 Cursor CLI。适合:在 IDE 里做"flow-state coding"、需要 tab 补全、多模型混搭。坑:credit 计费模式下 Opus 消耗是便宜模型的 2.5 倍,曾有团队 $7000 年费一天烧完的报道,务必开 spend limit。
- OpenAI Codex 桌面版(GPT-5.4 系列):4 月 16 日升级为"超级应用"——后台 Computer Use(仅 Mac)、内置浏览器、gpt-image-1.5 原生画图、Heartbeat Automations(跨日自唤醒)、Memory 预览、90+ 插件(CircleCI、GitLab、Microsoft Suite、Atlassian Rovo)。适合:已深度绑定 ChatGPT 生态 + 想让一个工具覆盖"代码 + 文档 + 日程"的用户;注意:Memory / 主动建议功能 Enterprise / Edu / EU / UK 稍后开放。
- GitHub Copilot:Opus 4.7 已在 Pro+ / Business / Enterprise 的 model picker 中 gradual rollout,4 月 30 日前 7.5× premium request multiplier 促销。适合:团队已在 GitHub 上、需要原生 PR review 与 IDE 插件(VS Code / JetBrains)覆盖。
- Google Antigravity + Gemini 3 Pro:免费层可用,走 agent-first 哲学。适合:预算极敏感 + 不介意被 Google 生态锁定的个人开发者。
一个简化的决策路径:后端主导 / 长任务无人值守 → Claude Code;IDE 内 flow 编码 / 多模型切换 → Cursor;想要"超级应用 + 跨 App 联动" → Codex;团队已在 GitHub → Copilot;预算紧 → Antigravity。这几款都支持 MCP,切换成本在降低,"同时用两款"正在变成新的默认打法。
小结:Opus 4.7 拉开的差距,需要你花时间重配工作流
Opus 4.7 在原始能力上比 4.6 强一档,这是 Rakuten-SWE-Bench 上 3× production 任务通过率、XBOW 98.5% 视觉锐度、Factory 10–15% 任务成功率提升等外部数据共同印证的事实。但 Boris Cherny 的核心论点是:如果你把 4.7 插进 4.6 的旧工作流,最多只能感受到"还不错";只有改掉"逐条点确认、短 prompt 多轮交互、盯着中间过程"的旧习惯,把它当作"可以放心托付 8 小时的工程师"来用,才会体验到"巨大飞跃"。
今天就可以立刻试的 4 个动作:
- CLI 按一次 Shift + Tab 打开 Auto Mode(Max 用户)。
- 输入 /effort 确认默认已切到 xhigh,最难的任务临时试一次 max。
- 给下一个任务写一段"含意图 + 约束 + 验收标准 + 相关文件路径"的 one-shot prompt,尽量把它跑到 PR 为止再介入。
- 装 Claude for Chrome 扩展或开 Computer Use,让它"自己测完再提交"——这是 Boris 认定的 2-3 倍产出增量来源。
这轮升级也刚好给出了一个适合国内工程团队验证"AI coding 能不能放进生产流"的节点:Opus 4.7 的 1M 上下文足够塞进中等规模单体 repo;Sonnet 4.6 的 5× 低成本可用于外围批量任务;Kimi Code、Qwen3.6-35B-A3B 等开源 / 国产方案则在价格敏感 / 数据不出境场景形成互补。不存在"唯一正确的工具",只存在"针对你当前瓶颈最对路的组合"——这也是 Boris Cherny 在那条线程结尾想说的真正意思。
 AI 速览