你要是好奇现在几个主流AI编程工具谁写游戏写得最靠谱,这篇给你个明确答案:同样一句"复刻一下魂斗罗,做好第一关",Claude Code拿了95分完成度最高,GLM-5.2 85分紧随其后,Codex垫底,差距还不小。这次测试没给复杂需求文档,也没做详细任务拆解,就是要看这几个模型在同一个起点下,能不能自己把"能玩""像那么回事""细节完整"这几件事做出来。 测试怎么设计的
参与测试的三个模型是Claude Code、GLM-5.2和Codex,评价标准也简单:游戏能不能跑,画面是否合理,人物动作是否自然,关卡和障碍是否可理解,最后有没有做出一个完整的关底体验。没给三个模型不同需求,也没专门帮某一个写详细任务拆解,所以对比的重点不是"谁会不会写代码",而是看它们在一句话提示下会不会主动理解游戏目标。一个好的结果需要自己补齐几件事:横版射击游戏的基本操作、角色动画和移动反馈、敌人障碍子弹和关卡节奏、画面可读性,还有关底或Boss这样的完成感。 Claude Code:基本做出了想要的东西
Claude Code跑出来的成品是能玩的,不是那种勉强能动一下的Demo。整体画面比较合理,角色、场景、敌人和关底的关系都能看明白。最让人意外的是它把最后Boss也做出来了,这点很重要,因为很多模型做小游戏容易停在"角色可以左右移动、可以开枪、地图上有几个敌人"这个层面,看起来像游戏,但没有完整关卡、没有节奏、也没有一个结束点。Claude Code的结果说明它理解了这不是要写一个横版射击小样,而是要做一个接近《魂斗罗》体验的小游戏。人物动作也比较到位,尤其是腿部动作,不是一个方块在屏幕上平移。画面风格不可能真的和原作一样,但作为一句话提示生成出来的结果,已经非常接近一个可展示、可试玩的版本。这一项给95分,不是因为它完美,而是在这个测试条件下,它已经把主要体验都交出来了——能玩、能看、能打,最后还有Boss。
GLM-5.2:完成度不错,还做了关底特效
第二个是GLM-5.2,把前面的模型都换成GLM-5.2跑同样任务,整体过程比较顺,做出来的效果基本实现了横版动作射击游戏该有的东西,游戏能跑,操作也比较流畅。画面和关卡虽然没有Claude Code那么完整和稳定,但并不是乱糟糟的堆砌。比较加分的是它还做了关底的一个特效,说明它不只是机械地做"移动、跳跃、射击、敌人"这些基础模块,而是会尝试补一点游戏结束阶段的表现。哪怕这个特效不是特别复杂,也让整个作品更像一个完整关卡,而不是一个还没收尾的工程。GLM-5.2给85分,比Claude Code少一些成熟度,整体完成感也弱一点,但作为一句话提示的结果,已经是可接受甚至不错的水平。
Codex:最大的问题不是差,是改了很久还差
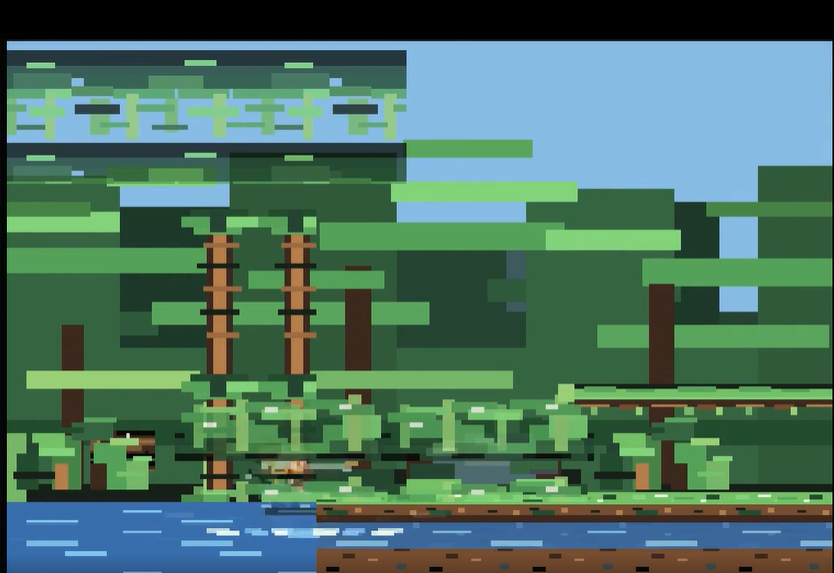
最后是Codex,结果比较让人失望。一开始直接做出了一个非常粗糙的版本,画面和玩法都不太能看。继续要求它修改之后,它没有很快把问题拉回来,而是进入了一个很长的反复修补过程,最后工作了大约18个小时,还耗费了大约10%的周额度,最终结果依然很差。最大的问题是画面完全看不清,人物、障碍、跳跃路径和场景关系都不清楚,很多地方不知道它到底想表达什么。对一个《魂斗罗》式横版动作射击游戏来说,清晰度是基本要求,玩家至少要看得懂自己在哪里、敌人在哪里、平台在哪里、子弹从哪里来、要往哪里跳,Codex的结果在这些基础体验上都没有站住。人物跳跃、障碍布置和整体关卡逻辑也很混乱,像是把很多"游戏元素"都塞进去了,但没有真正形成一个可玩的游戏场景。最不满意的地方不是它第一版差,而是它在长时间修改之后,仍然没有把核心体验修回来。
这次测试真正拉开差距的地方
Claude Code在完成品意识这几方面最完整,GLM-5.2有一些不足,但整体方向是对的,Codex最大的问题是缺少完成品意识,不是没有做东西,而是做出来的东西没有形成清晰体验。这一次的评分是Claude Code 95分、GLM-5.2 85分、Codex明显不及格,同样一句话提示,模型之间的"自动补全能力"和"完成品意识"差别相当大。这只是一次具体任务的测试,不代表所有场景,用不了Codex的话,智谱的ZCode(深度适配GLM-5.2的国产编程工具)也是个可以考虑的选项,国产大模型这条路值得持续关注。
 AI 速览