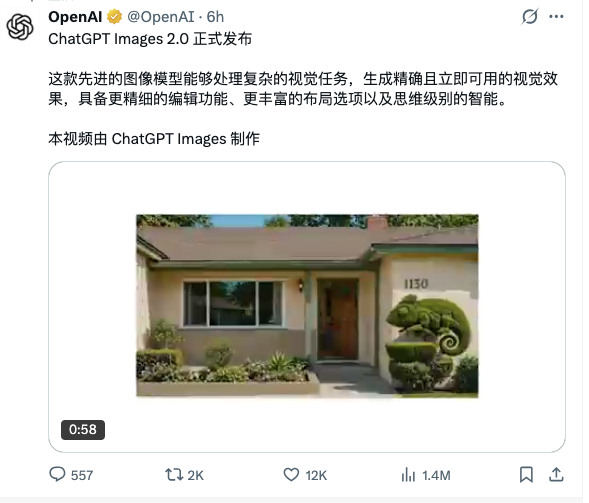
4月22日消息,OpenAI 发布 ChatGPT Images 2.0,底层模型命名为 gpt-image-2。新模型知识截止日期更新至 2025 年 12 月,支持 ChatGPT 侧最高 2K 分辨率输出、API 侧最高 4K(beta),纵横比范围从 3:1 到 1:3。该模型即日起向所有 ChatGPT 与 Codex 用户开放,gpt-image-2 同步进入 API,按输出质量与分辨率分级定价。
文本渲染和非拉丁语种是核心增量
Images 2.0 将精力押注在此前主流图像模型普遍失守的细节层——小字、图标、UI 元素、密集排版。OpenAI 在新闻稿中明确提到,模型对日语、韩语、印地语、孟加拉语等非拉丁语种文本的渲染能力显著提升。TechCrunch 实测用该模型生成墨西哥餐厅菜单,结果可直接用于商业场景,不再出现两年前 DALL-E 3 把 margarita 拼成 margartas、burrito 拼成 burrto 的情况。
这种准确度的来源 OpenAI 刻意回避披露。有媒体在沟通会直接询问 Images 2.0 采用的是扩散模型还是自回归架构,OpenAI 拒绝回答。行业此前的共识是扩散模型在文字重建上存在结构性缺陷——因为文字像素在整张图中占比极小,模型倾向于忽略,而自回归路线更接近语言模型的预测机制。
Thinking 模式提供多图联动和网络搜索
Images 2.0 引入了"thinking"能力层。选中 thinking 模型后,系统会花更多时间处理,可以搜索网络、分析上传材料、在生成前先推演版式,并支持一次输出最多 8 张保持连贯性的图像。这是 Images 2.0 区别于前代最直接的工作流级变化——营销素材多尺寸批量、多面板漫画、角色设定表都落在这个能力之下。
代价是生成速度。OpenAI 在发布材料中承认,图像生成"不像打字提问那样快",一组多面板漫画需要几分钟。这与 Google 今年 2 月发布的 Nano Banana 2(即 Gemini 3 Pro Image)形成对比,后者同样主打图像内密集文本,但更偏轻量化。 分层解锁,Enterprise 暂缓
分发策略分三档。基础版 Images 2.0 向所有 ChatGPT 与 Codex 用户开放,包括核心的指令跟随、文本渲染、多语言、宽高比改进。Thinking 能力限 ChatGPT Plus、Pro、Business 用户使用,Enterprise 档位注明"即将推出"但未给时间表。开发者侧,gpt-image-2 进入 API,支持最高 4K 分辨率(beta)。
这个节奏延续了 OpenAI 一贯的分发逻辑——消费者端先铺,企业端滞后,API 随后。上一代 GPT Image 1.5 于 2025 年 12 月发布,距离 Images 2.0 仅约四个月,迭代周期明显压缩。
对手是 Nano Banana 2,不是 Midjourney
VentureBeat 的报道把 Images 2.0 直接对标 Google Nano Banana 2,理由是两者都在解决同一件事:把高密度文本"焊进"图像里。这是 2024—2025 年被称为"多模态大战"的直接延续——图像生成的评价维度从"艺术感"迁移到"可直接用于生产"。Midjourney 所代表的艺术化路线不再是 OpenAI 的参照系。
另一层竞争是速度。从 GPT Image 1(2025 年 3 月,GPT-4o 原生图像)到 GPT Image 1.5(2025 年 12 月)再到 gpt-image-2(2026 年 4 月),OpenAI 在 13 个月内完成三次主版本迭代。这个节奏对标的是 Google Gemini 系列图像模型的滚动更新,以及 Adobe、Black Forest Labs 等专业图像工具厂商的产品窗口。
未披露信息构成主要不确定性
目前公开材料存在三个关键盲区。
第一,OpenAI 未发布任何基准测试数据,所有能力描述停留在定性层面。
第二,模型架构未披露,这影响开发者对 API 调用成本与延迟的预期。
第三,具体的 API 定价结构、Enterprise 档位的开放时间表、以及水印与溯源分类器的技术细节均未给出,OpenAI 仅表示内嵌了"新一代水印和溯源分类器",但未说明对下游商用合规的实际效力。
此外,knowledge cutoff 定在 2025 年 12 月,意味着涉及近四个月内新闻、产品、事件的提示词可能仍会出现事实偏差。
 AI 速览