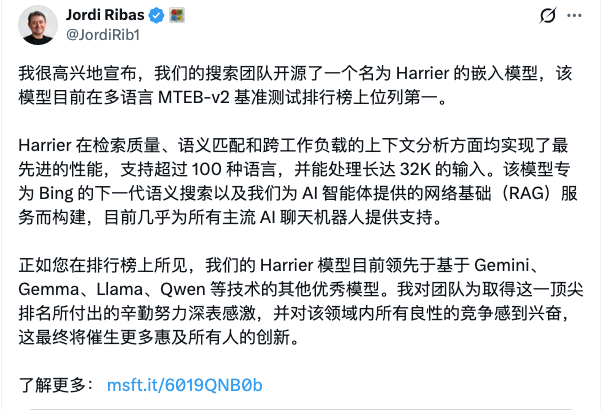
4月8日消息,微软Bing搜索团队发布博客公告,宣布开源Harrier-OSS-v1系列多语言嵌入模型。该模型家族包含27B、0.6B和270M三个规格,全部采用MIT许可证,27B旗舰版以74.3分登顶多语言MTEB v2基准排行榜,超越OpenAI text-embedding-3-large、Amazon Titan Embed等闭源竞品以及阿里Qwen3-Embedding-8B(70.58分)、NVIDIA NV-Embed-v2等开源模型。但多数报道忽略了一个关键细节:Harrier的27B和270M版本基于谷歌的Gemma 3架构构建,0.6B版本基于阿里的Qwen 3——微软用竞争对手的开源架构训练出了超越他们自己的嵌入模型。
架构突破:抛弃BERT,用解码器做嵌入
嵌入模型领域近十年来几乎由BERT式双向编码器架构统治。BERT的优势在于双向注意力——每个token同时看到前后所有token,理论上能获得更完整的上下文理解。Harrier彻底抛弃了这一路线,转向Decoder-only Transformer架构——与GPT、Claude、Llama等生成式大模型相同的架构范式。 在解码器架构中,token只能关注其之前的内容(因果注意力)。为了从这种单向模型中提取整段文本的语义表示,Harrier采用last-token pooling:取序列中最后一个非填充token的隐藏状态作为整段文本的聚合表示,再通过L2归一化生成最终嵌入向量。
这个设计看似反直觉——单向模型怎么可能比双向模型更好地理解语义?答案在于三个优势:解码器模型天生擅长指令跟随,当模型被训练为根据指令(如"为法律检索嵌入这段查询")生成嵌入时,它能动态适配不同任务的向量空间;解码器架构可以直接受益于大语言模型领域的持续进步,而BERT式架构的扩展已接近天花板;32K token的上下文窗口直接消除了传统512 token限制带来的长文档切分和语义碎片化问题。
需要指出的是,Harrier并非第一个采用解码器架构的嵌入模型——E5-Mistral、GTE-Qwen2、NVIDIA的Llama-Embed-Nemotron系列都做过类似尝试。Harrier的差异化在于:同时覆盖94种语言、MIT许可证、三个部署友好的模型规格一次性发布。
用谷歌和阿里的架构击败谷歌和阿里
这是此次发布中最值得玩味的细节。微软没有从头构建Harrier的基础架构。270M和27B两个版本均基于谷歌的Gemma 3架构,0.6B版本基于阿里巴巴的Qwen 3架构。微软在这些基础模型之上,使用对比学习目标在大规模多语言数据集上进行微调,最终生成嵌入模型。
竞争层面的反讽显而易见:微软拿了谷歌自己的开源模型架构,训练成了SOTA嵌入系统,然后在多语言检索基准上超过了谷歌。谷歌上月发布的Gemini Embedding 2支持最高8192 token但只能通过API访问,而Harrier可以自托管、MIT许可、且上下文窗口是谷歌的4倍。 训练数据方面,Harrier使用了超过20亿条弱监督样本以及GPT-5生成的合成数据,另有千万级高质量精调数据。270M和0.6B两个小模型额外采用了知识蒸馏技术——用大模型作为"教师"训练小模型模仿其输出分布,以在更小参数量下保持尽可能高的嵌入质量。
不过蒸馏的效果递减明显。从实际得分看,270M为66.5分,0.6B为69.0分,27B为74.3分。270M和0.6B之间差距2.5分,但0.6B到27B之间跳了5.3分,说明蒸馏在保留旗舰模型质量方面存在显著衰减。
三个模型的部署定位
三个规格覆盖了从边缘设备到GPU集群的完整部署光谱。
27B旗舰版:嵌入维度5376,MTEB-v2得分74.3。以bfloat16精度运行需要约54GB显存,适合配备完整GPU节点的企业级RAG系统和高精度跨语言检索场景。这不是能在笔记本上跑的模型。
0.6B中型版:嵌入维度1024,得分69.0。在受限的云端预算下提供平衡的性能和成本,基于Qwen 3架构,适合中等硬件环境的原型开发和生产部署。
270M轻量版:嵌入维度640,得分66.5。可在CPU上运行,适合边缘设备、低延迟场景和轻量级应用。
三个模型共享32768 token的上下文窗口和MIT许可证。已集成sentence-transformers、LangChain和LlamaIndex生态,开发者可以通过一行代码调用。
但有一个容易被忽略的使用要求:Harrier是指令微调(instruction-tuned)嵌入模型。要达到论文基准性能,查询端必须添加一句话的任务指令(如"检索语义相似的文本"或"寻找该查询的翻译"),而文档端则不需要添加指令。这意味着Harrier不是现有管线的即插即用替代品——替换旧模型时必须同步更新编码逻辑。
为什么Bing团队做嵌入模型
微软在博客中明确将Harrier定位为"Agentic Web(智能体网络)"的基础层技术。Bing团队的论述逻辑是:在代理时代,嵌入不再仅仅是检索原语,而是记忆、排序和编排的基础设施层。AI代理需要跨多样化来源搜索、长时间维护记忆、在多步骤任务中持续更新上下文——这些场景对嵌入质量的要求远高于传统搜索。
更好的嵌入带来的是连锁效应:首轮检索的准确率提高意味着更少的重试和更小的上下文窗口开销,进而降低延迟和成本;事实准确性提升意味着更少的幻觉和更可靠的引用;多语言性能改善意味着代理在跨语言场景下的行为一致性更强。
微软表示,基于Harrier同核心技术的下一代grounding服务正在开发中,将提供更好的检索质量、更强的语义理解和更稳健的上下文选择能力。这些技术也将整合进Bing搜索,用于改善真实用户体验。
值得注意的是,微软此前在嵌入模型领域的代表作是E5系列,主要面向英语场景。Harrier虽然没有被官方明确定位为E5的继任者,但从多语言定位和架构升级来看,实质上承担了这一角色。
竞品格局与局限性
嵌入模型市场在2026年已相当拥挤。阿里的Qwen3-Embedding、NVIDIA的Nemotron系列、谷歌的Gemini Embedding 2、Jina v4、Cohere embed-v4各据一方。Harrier的差异化在于MIT许可证+94种语言+三个规格+32K上下文的组合拳——目前没有其他单一模型家族同时覆盖这些维度。
但几个局限性需要注意。第一,74.3分的SOTA声明基于特定版本的Multilingual MTEB v2基准(截至2026年3月16日),跨版本比较不可靠,且随着更多模型提交,排名随时可能变化。第二,94种语言的支持范围虽广,但模型在高资源语言(英语、中文、法语等)和低资源语言上的表现差距未在任何公开评测中详细披露——跨语言嵌入的实际质量需要在具体任务和语言对上逐一验证。第三,此次发布没有伴随技术论文,只有Hugging Face上的模型卡,训练细节的完整披露仍然缺失。
对于正在构建RAG系统、多语言搜索或向量数据库的开发者而言,Harrier的MIT许可证和自托管能力提供了一条脱离按token计费API定价的实际路径。但在替换现有管线前,至少需要在自己的任务和语言组合上跑一轮独立评测,而非仅依赖MTEB排行榜数字做决策。
 AI 速览