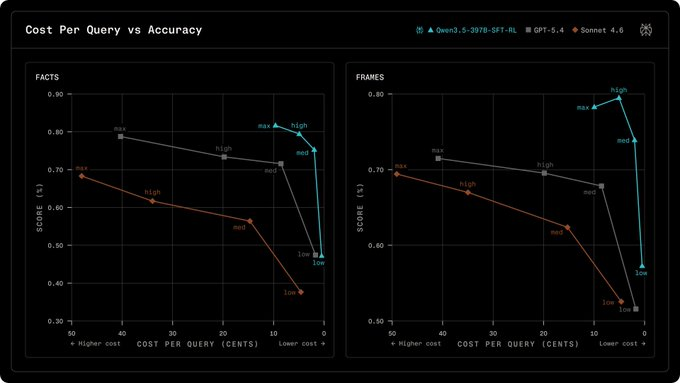
4月23日消息,Perplexity Research 发布研究博客《Advancing Search-Augmented Language Models》,公开其面向 Web 搜索代理的后训练(post-training)完整管道。团队基于开源 Qwen3.5-397B-A17B(MoE 架构,总参 397B、激活参 17B)训练的 SFT-RL 版本,在 FRAMES 事实推理基准上于 medium 预算档(最多 4 次工具调用)取得 73.9% 准确率、单次查询 2.0 美分 的成绩;同等条件下 gpt-5.4 为 67.8% / 8.5 美分,Claude Sonnet 4.6 为 62.4% / 15.3 美分——即比 gpt-5.4 高出 6 分、成本低 4 倍;比 Sonnet 4.6 高出 11.5 分、成本低 7.5 倍。 研究的核心主张是:搜索代理的训练需要"数据策划"和"奖励设计"协同进行——数据决定哪些行为可被观测和验证,奖励决定这些信号如何转化为优化信号。
两阶段管道:SFT 守护栏 + GRPO + 90/10 数据混合
Perplexity 采用 SFT → on-policy RL 的解耦设计。其判断是:在单一 RL 阶段内联合优化搜索质量与部署合规,几乎必然牺牲其中一项——仅 RL 会提升搜索表现但损伤护栏行为,仅 SFT 会改善合规但拉低搜索精度。
SFT 阶段 建立"不可妥协"的部署行为:适时拒答、指令遵循、语言一致性。训练数据为两部分组合——偏好导向样本(针对语气、格式、清晰度)和生产格式工具调用轨迹(覆盖单轮、双轮、多轮交互)。
RL 阶段 基于 GRPO(Group Relative Policy Optimization)算法,使用 token-level Importance Sampling 修正训练-推理不一致。团队对比了 sequence-level IS、routing replay、vLLM+TorchTitan 的 bitwise consistent training 等方案,结论是在 on-policy 设定下 token-level IS 已足以防止训练崩溃。
数据混合比例是工程关键:90% 可验证 QA(通过"实体链+名称替换"合成多跳问题,例如从"The Mom Test"出发链接到"Rob Fitzpatrick → Y Combinator → 2005 年 3 月成立",倒推出名称无关的嵌套问题)+ 10% rubric 通用对话数据(将合规要求转为原子化、可客观判定的 checklist)。这一比例是为解决方差失衡——rubric 任务早期更容易满足、梯度更大,若不加权会主导优化方向,压制更难的可验证 QA 信号。
门控聚合奖励:r_base=1 才给 preference credit,直击 reward hacking
奖励设计的核心创新是"门控聚合"(gated aggregation)。Perplexity 在早期实验中观察到典型的 reward hacking 现象——线性组合奖励时,强偏好信号会补偿事实或指令错误,模型学会输出"听起来好但答案错"的内容。
门控聚合将奖励结构化为三层:
- r_base ∈ {0, 1}:二值基线奖励,QA 正确或全部 rubric 满足;
- preference 分数:基于 Bradley-Terry 框架的学习型奖励模型(与策略模型共享 backbone,仅替换 LM head 为 value head),训练对每对样本双向对称优化消除位置偏差;
- efficiency penalty:组内锚定惩罚(group-relative, anchored)——基于该 GRPO group 内"有效解答"的工具调用次数和生成长度基线,而非固定阈值。
关键约束是:只有 r_base=1 时,preference 分数才被计入最终奖励。这让正确性成为必要条件,同时保留对冗余工具调用和啰嗦输出的抑制。对比之下,GPT-5.4 和 Sonnet 4.6 的闭源训练细节未公开,无法做同维度方法对比。
从 57.3% 到 73.9%:1 次调用已领先,budget=7 后普遍收益递减
在 budget-forced 评估(系统提示硬性限定最多工具调用次数)下,Qwen3.5-397B-SFT-RL 呈现出两个显著特征。
低预算即领先:仅允许 1 次工具调用时,FRAMES 上达到 57.3%,比 gpt-5.4 高 5.7 分、比 Sonnet 4.6 高 4.7 分。Perplexity 认为 budget=2–7 是实际生产部署的主要运行区间,也是 SFT-RL 版本优势最明显的区间。
天花板与成本曲线:所有模型在 budget=7 附近都出现收益递减,Perplexity 将其归因为事实查询任务本身的性质而非模型能力上限。换算到成本曲线,medium 档(b=4)下三方对比如下——
内部指标方面,pplx-sbs-search(与强基线的一对一偏好评估)从基础模型的 0.602 提升到 0.742;pplx-abstention(无证据时拒答)、pplx-language-mismatch(长尾和多轮下的语言一致性)、pplx-broken-tool-calls(工具 schema 合规率)均相对基础模型有明确改进。
局限:KL 漂移未解、单工具评估、成本对比未含工程优化
报告自身披露与评估设置层面存在若干需要关注的未竟之处,读者在引用数据时需要一并理解。
第一,训练-推理 KL 散度在长训练步数下呈现持续上行趋势(仍在 1e-3 量级内),当前 token-level IS 处理方案在文中的规模下足够稳定,但 Perplexity 自己承认更大规模是否成立尚不明确,并指出这需要"更原则化的理论处理",涵盖基础设施差异和 MoE routing 等架构特定因素。
第二,多目标 RL 的替代方案对比不完整,sequential training(配合 on-policy 蒸馏分阶段优化)和 model merging(解耦任务优化与能力聚合)等方向未给出实验。
第三,评估限定在单一工具(search_web),每次 rollout 最多 5 次调用、250 字符查询、每次返回 10 条结果,扩展到多工具长链路轨迹时的信用分配、部分 rollout 处理、评估设计仍是开放问题。
第四,成本对比基于公开 API 定价(Alibaba DashScope、OpenAI、Anthropic),未含 KV cache reuse、prefix caching、量化 MoE serving 等工程优化;Perplexity 明确承认实际部署成本可以进一步压低,但这也意味着对 gpt-5.4 和 Sonnet 4.6 的成本比较是"未经同等工程优化的定价基线",对闭源模型不完全公平。
第五,基础模型选择局限于 Qwen3.5 家族,该管道对 GLM、DeepSeek 等其他开源 MoE 模型的可迁移性未经验证。 对开源搜索代理生态的启示
这份研究指向一个更广的判断:在事实性搜索任务这一细分能力上,开源 MoE 基础模型(Qwen3.5 家族)+ 精心设计的两阶段后训练,已经可以在公开基准上匹配或超越闭源前沿模型,同时在 API 定价维度保持 4–7 倍成本优势。对想要自建搜索代理的团队而言,值得关注的不只是分数本身,而是方法层面的三个可复用组件——门控聚合奖励防止 reward hacking、组内锚定惩罚避免抑制必要探索、90/10 数据混合处理多目标 variance 失衡。这些组件的设计都来自具体工程踩坑,而非理论先行。
 AI 速览