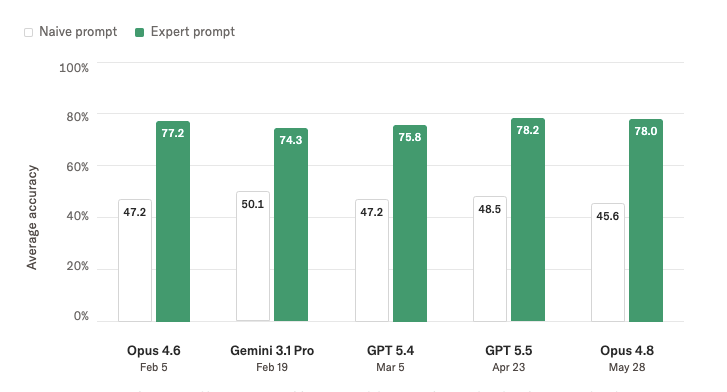
- 桥水基金在六项金融文档筛选任务上测试了Gemini、Claude和GPT系列,简单提示词准确率仅约50%,专家优化提示词提升至约78%,但未达到投资者要求的80%信任阈值
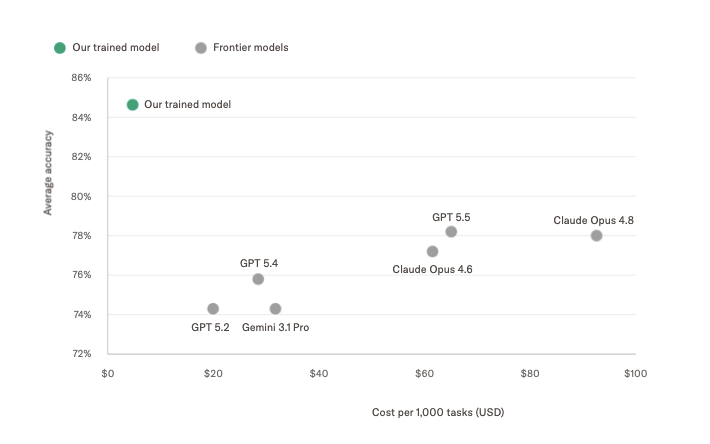
- 桥水在Tinker平台上对Qwen3-235B进行微调,最终准确率84.7%,错误率比最佳前沿模型(GPT-5.5)低29.8%,推理成本仅为后者的1/13.8
- GPT 5.4成本比GPT 5.2高出43%,但准确率几乎无提升,揭示前沿模型在窄领域专家任务上的边际收益递减
- 桥水创新性地利用模型自身的困惑检测训练数据错误标签:先训练模型,再让模型评审判定训练样本,争议样本自动送入专家复审
- 三项核心技术改进:交错批处理(Interleaved Batching)、CISPO非对称裁剪损失、基于最佳验证准确率的在线策略蒸馏
前沿模型为何在金融判断任务上止步78%
六项任务全部来自桥水投资分析师日常工作:金融文章相关性判定、央行文档是否暗示利率方向、研究文档能否回答投资者问题、内容标签分类、文档截断点和邮件截断点识别。这些任务对经验丰富的投资者而言几乎不假思索,但前沿大语言模型的表现令人失望。
测试涉及的模型包括Gemini 3.1 Pro、Claude Opus 4.6和4.8、GPT 5.2、5.4和5.5。当使用简单提示词时,六项任务的平均准确率仅47%—50%,接近抛硬币。桥水的专家撰写提示词,并根据任务特点重构问题——例如将文章分类拆分为"相关且有趣""相关但无趣""不相关"三个标签。这一调整将前沿模型准确率提升至74%—78%区间。 但78%就是天花板。自动提示优化方法也无法突破80%——这是投资者愿意将系统融入日常工作的最低信任阈值。
更深层的原因是结构性而非工程性的。"一条提示词只能捕捉专家能用语言表达的判断。"模型表现上限受限于专家能否将二十年积累的直觉经验转化为文字指令——而这本身是一个几乎不可能完成的任务。
80%信任阈值为何对金融机构如此重要
80%不是随意选择的数字。它对应着一个工作流信任临界点:当模型准确率低于80%时,分析师需要逐条复核模型输出,人力成本节省被抵消;超过80%后,分析师可以信任模型筛选结果,只关注模型标记为"不确定"的少数案例。
这解释了为什么桥水不接受78%。准确率从78%提升到84.7%看似仅6.7个百分点,但错误率从22%降至15.3%,意味着模型犯的错误减少了29.8%。在每日处理数千份文档的规模下,这个差距直接决定了工作流程能否实际落地。
数据策略的精妙设计:用模型自己的困惑清洗训练标签
训练AI复制专家判断的核心瓶颈是数据——不是数据量,而是数据质量。
桥水的第一轮尝试使用供应商标注的训练数据,但模型表现仍然糟糕。检查模型推理轨迹后发现,原因是供应商提供的标签经常出错。专家标注虽然准确,但成本太高,无法覆盖全部数据。
他们的解决方案是:先用含噪声的数据集训练一个模型,再让这个模型重新审视自己的训练样本。每当模型对某个样本的判断与原始标签不一致时,就将其提交给资深投资者重新评估。
这是利用了训练数据中的一个规律:如果模型在自己的训练数据上都与标签不一致,那么要么这个样本本身确实棘手(边界案例),要么标签本身就是错误的。模型的困惑反而成了检测错误标签的探测器。
这一机制的优雅之处在于,它把专家时间集中在最有价值的部分——那些边界模糊或标注错误的数据点上——而不是让专家在数百个标注正确的简单样本上浪费时间。
三项核心技术改进如何从78%推进到84.7%
桥水选择Qwen3-235B作为基座模型,在Thinking Machines Lab的Tinker平台上进行微调。训练从标准GRPO起步并取得显著提升(从44.8%到73.48%),但未达到80%目标。后续三项针对性改进将准确率推到了84.7%:
交错批处理(Interleaved Batching) — 桥水在多任务训练中对比了三种批处理策略:任务依次训练、批次内全混合、以及每个任务轮序交叉入批。交错方式效果最佳,比全混合批次准确率高12.1%。消融实验中,移除交错批处理后准确率从84.66%降至72.18%,说明它是三项改进中贡献最大的单一因素。
CISPO损失加非对称裁剪 — 桥水用CISPO损失(已被收录至arXiv)替代标准重要性采样损失。配合非对称裁剪方案,比基线提升10.1%。移除后准确率降至74.56%。
在线策略蒸馏与最佳验证准确率教师 — 使用在线策略蒸馏(On-Policy Distillation,Thinking Machines Lab合作研究),用奖励项惩罚学生模型偏离教师分布。每20步检查一次,只有当验证准确率达到历史新高时才将当前检查点提升为教师,确保从不向较弱模型蒸馏。该策略带来额外3.1%提升。当使用固定基座模型作为教师(不动态提升),准确率从81.55%降至72.39%,证明"只向更强的自己学习"是关键。
微调推理成本仅为前沿模型的1/13.8
桥水训练后模型的推理成本约为每千任务5美元,而GPT-5.5约为92美元、Claude Opus 4.8约20美元。14倍的差距源于两个原因:Qwen3-235B参数量远小于前沿闭源模型,且窄领域任务不需要通用模型的全部能力。
成本差异在规模化部署中产生质变。如果一家投资机构每天处理数万份文档,前沿模型接口的月度成本可达数十万美元,而微调模型的推理成本可以低至数千美元。
桥水还指出了一个容易被忽视的问题:模型升级的成本效益比在恶化。GPT 5.4比GPT 5.2成本高出43%,但准确率几乎原地踏步。这意味着在专家判断类任务上,等待下一个前沿模型发布未必是最优策略——自建微调模型可能是更确定性的路径。
对AI行业的三层启示
第一层:提示词工程的边界已现。 这篇论文最有力的结论之一是提示词的天花板是结构性而非技术性的。任何提示词都受限于"专家能否用语言表达其判断",而大量金融直觉——"哪份央行备忘录真正暗示了利率方向"——来自模式识别和经验沉淀,无法被压缩成文本指令。需要通过带标签的示例传递。
第二层:差异化智能(Differentiated Intelligence)的落地路径。 桥水在文中提出了一个概念框架:与其追求一个通用的超级模型,不如针对具体组织需求训练专属模型。他们的结果证明,在特定任务上,中小参数的微调模型可以超越参数量大数倍的前沿模型。这并非前沿模型"不聪明",而是专家数据中的领域直觉无法被通用训练覆盖。
第三层:每一家坐拥专家决策数据的机构都可能复现这一路径。 如果一家对冲基金可以用内部标注数据微调出超越前沿模型的金融判断模型,那么律师事务所可以用判例数据训练法律分析模型,医院可以用诊断记录训练临床预筛模型,审计事务所可以用过往审计报告训练财务异常检测模型。那个阿尔法收益,一直藏在文件柜里。
 AI 速览