4 月 24 日消息,DeepSeek 今日上午发布 V4 系列模型预览版 Pro 与 Flash 并同步开源权重。两款模型统一支持 1M token 上下文,在 1M 上下文场景下,V4-Pro 单 token 推理 FLOPs 仅为 V3.2 的 27%、KV cache 仅为 10%,这是此次发布在工程上最硬的数字——把"百万上下文"从规格表里的营销概念拉到了真的能开启的默认档。 Hybrid Attention + DSA:1M 上下文的代价被压掉 73% 到 90%
核心架构变动集中在三条:
第一,Hybrid Attention 架构:混合 Compressed Sparse Attention(CSA)和 Heavily Compressed Attention(HCA),在 token 维度进行压缩,结合此前已经发布的 DSA 稀疏注意力。官方表述是这一组合"实现了全球领先的长上下文能力",但更值得看的是图表隐含的事实——V4 和 V3.2 的计算量与显存曲线分叉非常明显,长度越长,V4 越占优势。这解释了为什么 DeepSeek 敢把 1M 定为所有官方服务的标配而不是可选档。
第二,mHC(Manifold-Constrained Hyper-Connections):强化传统的残差连接,在不损失模型表达能力的前提下提升信号跨层传播的稳定性。这条之前在论文阶段就存在,这次从研究成果正式落进生产模型。
第三,采用 Muon 优化器换掉常规路径,带来更快的收敛速度和更好的训练稳定性。预训练语料超过 32T token,后训练链路完整。
量化策略上也有关键细节:MoE 专家参数用 FP4 精度,其余大部分参数用 FP8——这是 TileKernels 昨天开源时就已经准备好的那套 FP8/FP4 混合精度路径的直接应用。昨天的底层算子和今天的模型发布严丝合缝,说明这是按完整工程节奏推的,不是临时拼凑。
Agent 能力开源领先,但追 Opus 4.6 思考模式仍有差距
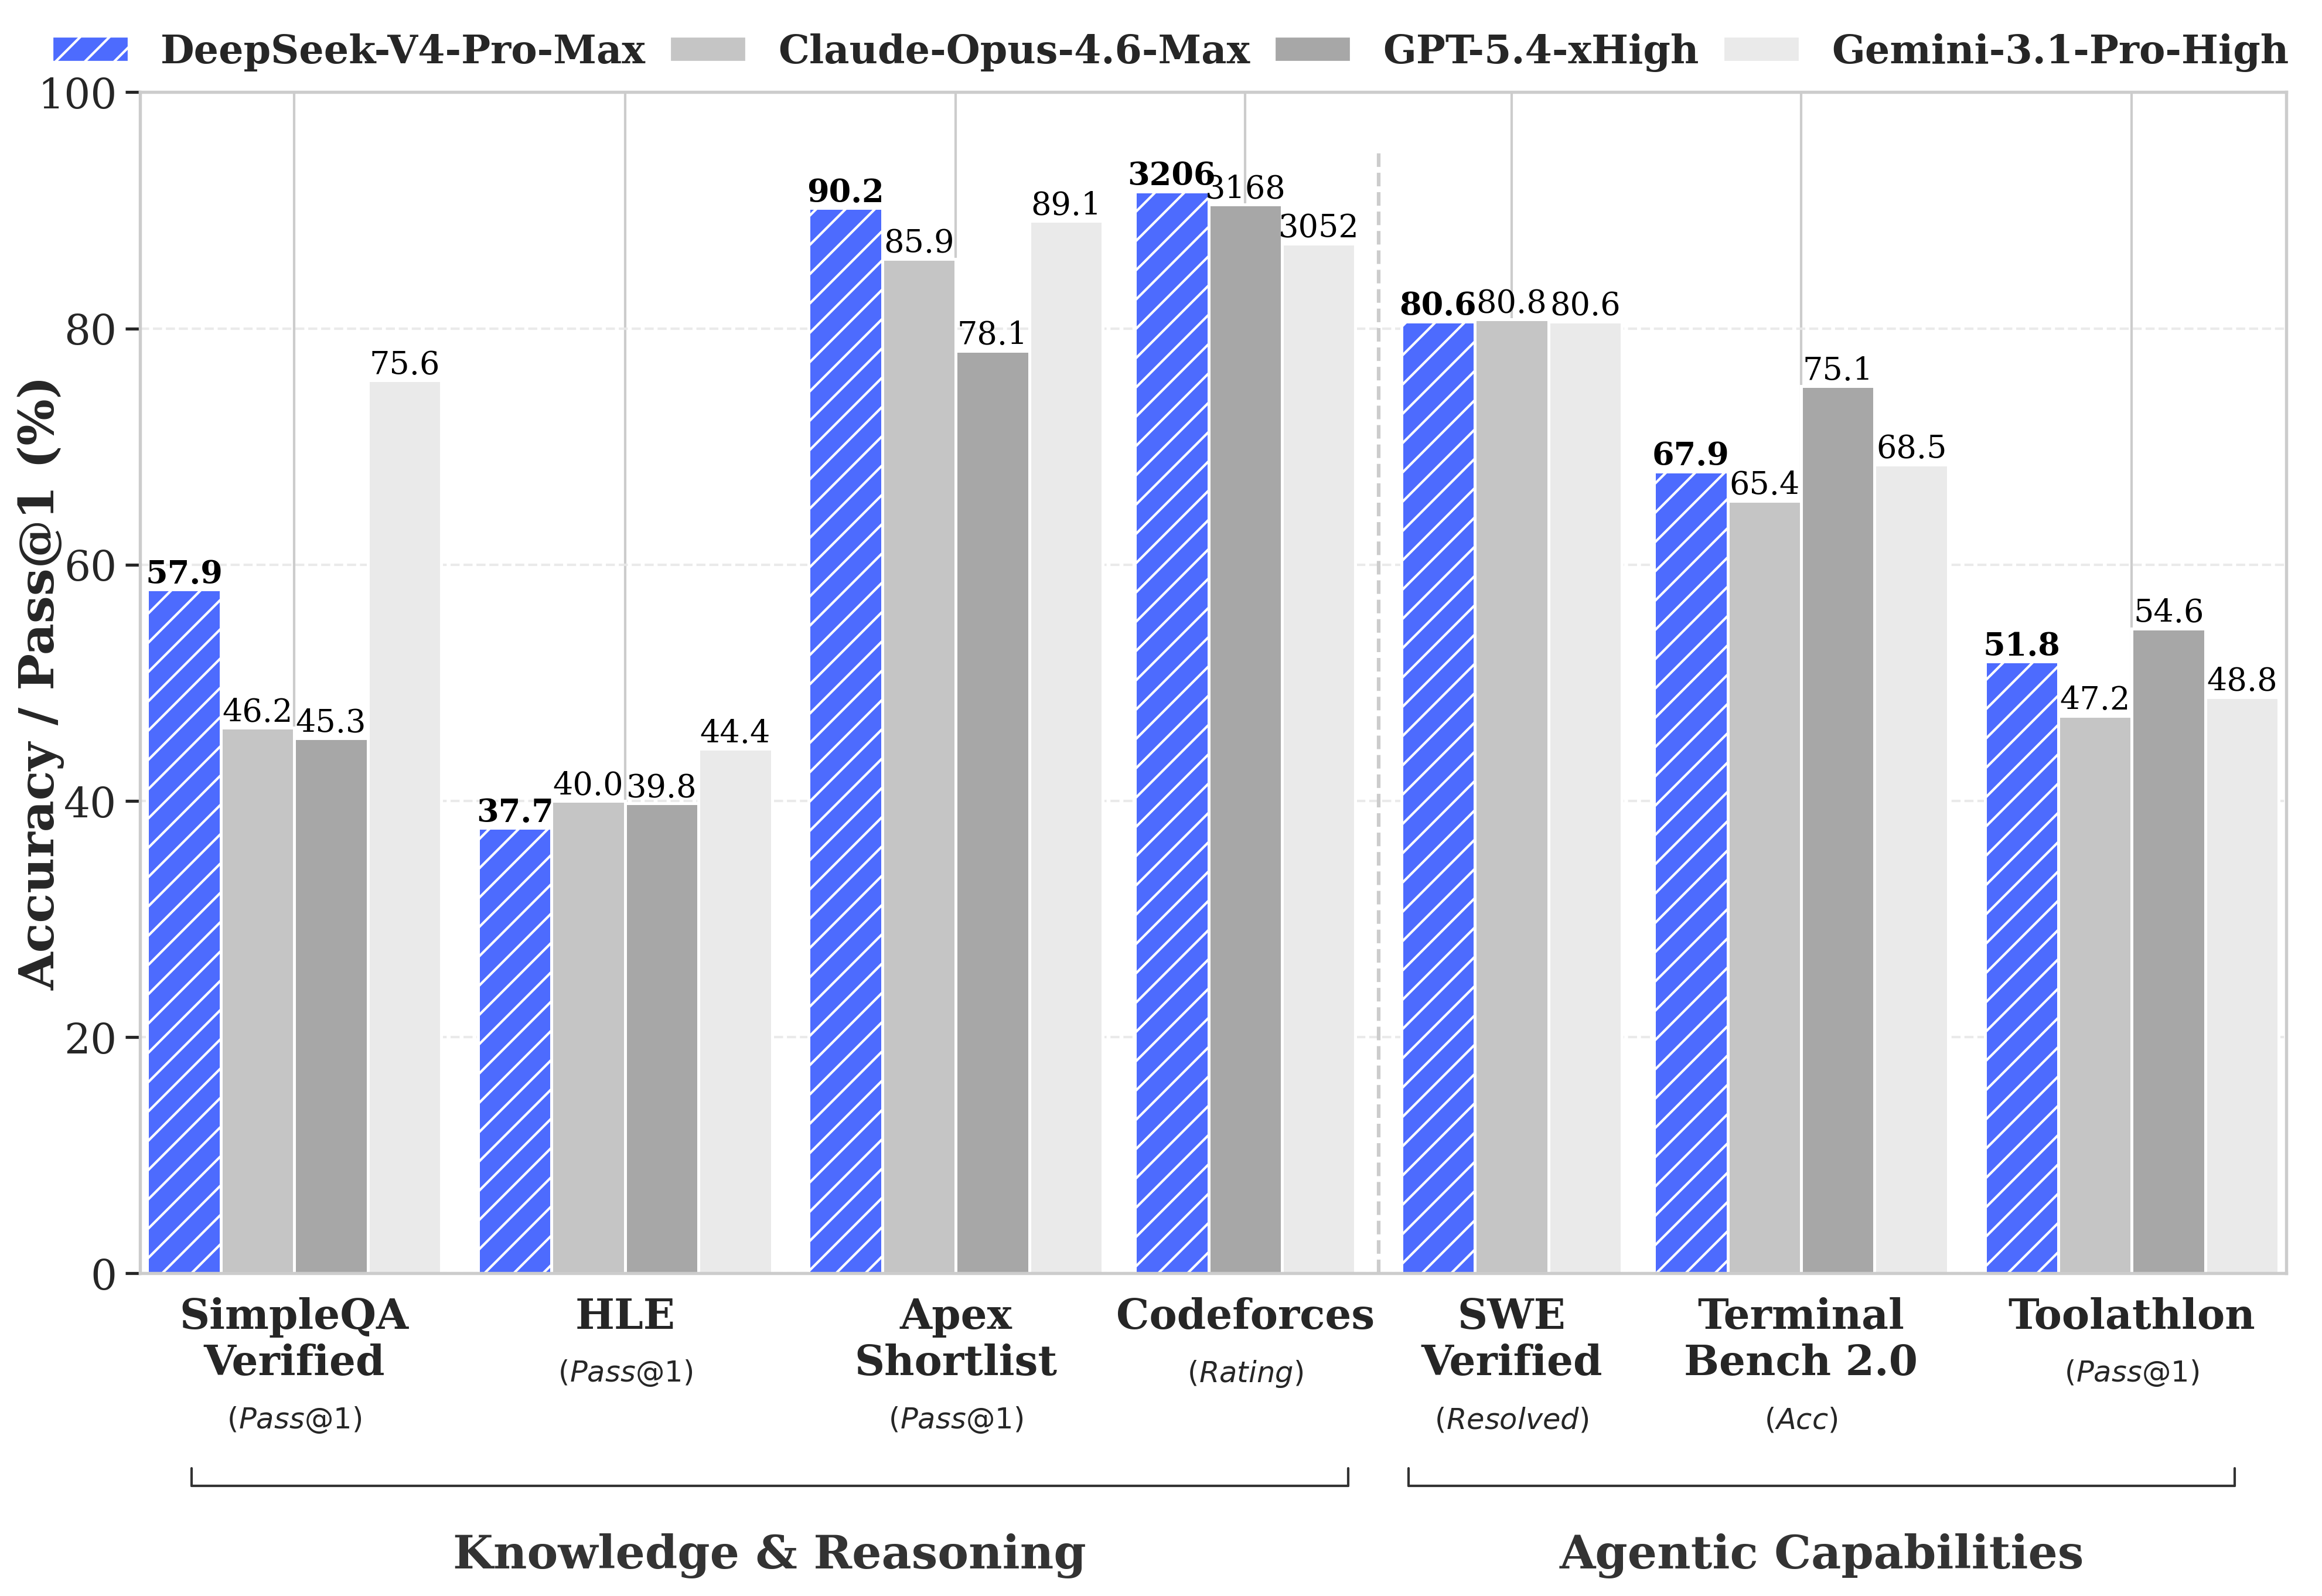
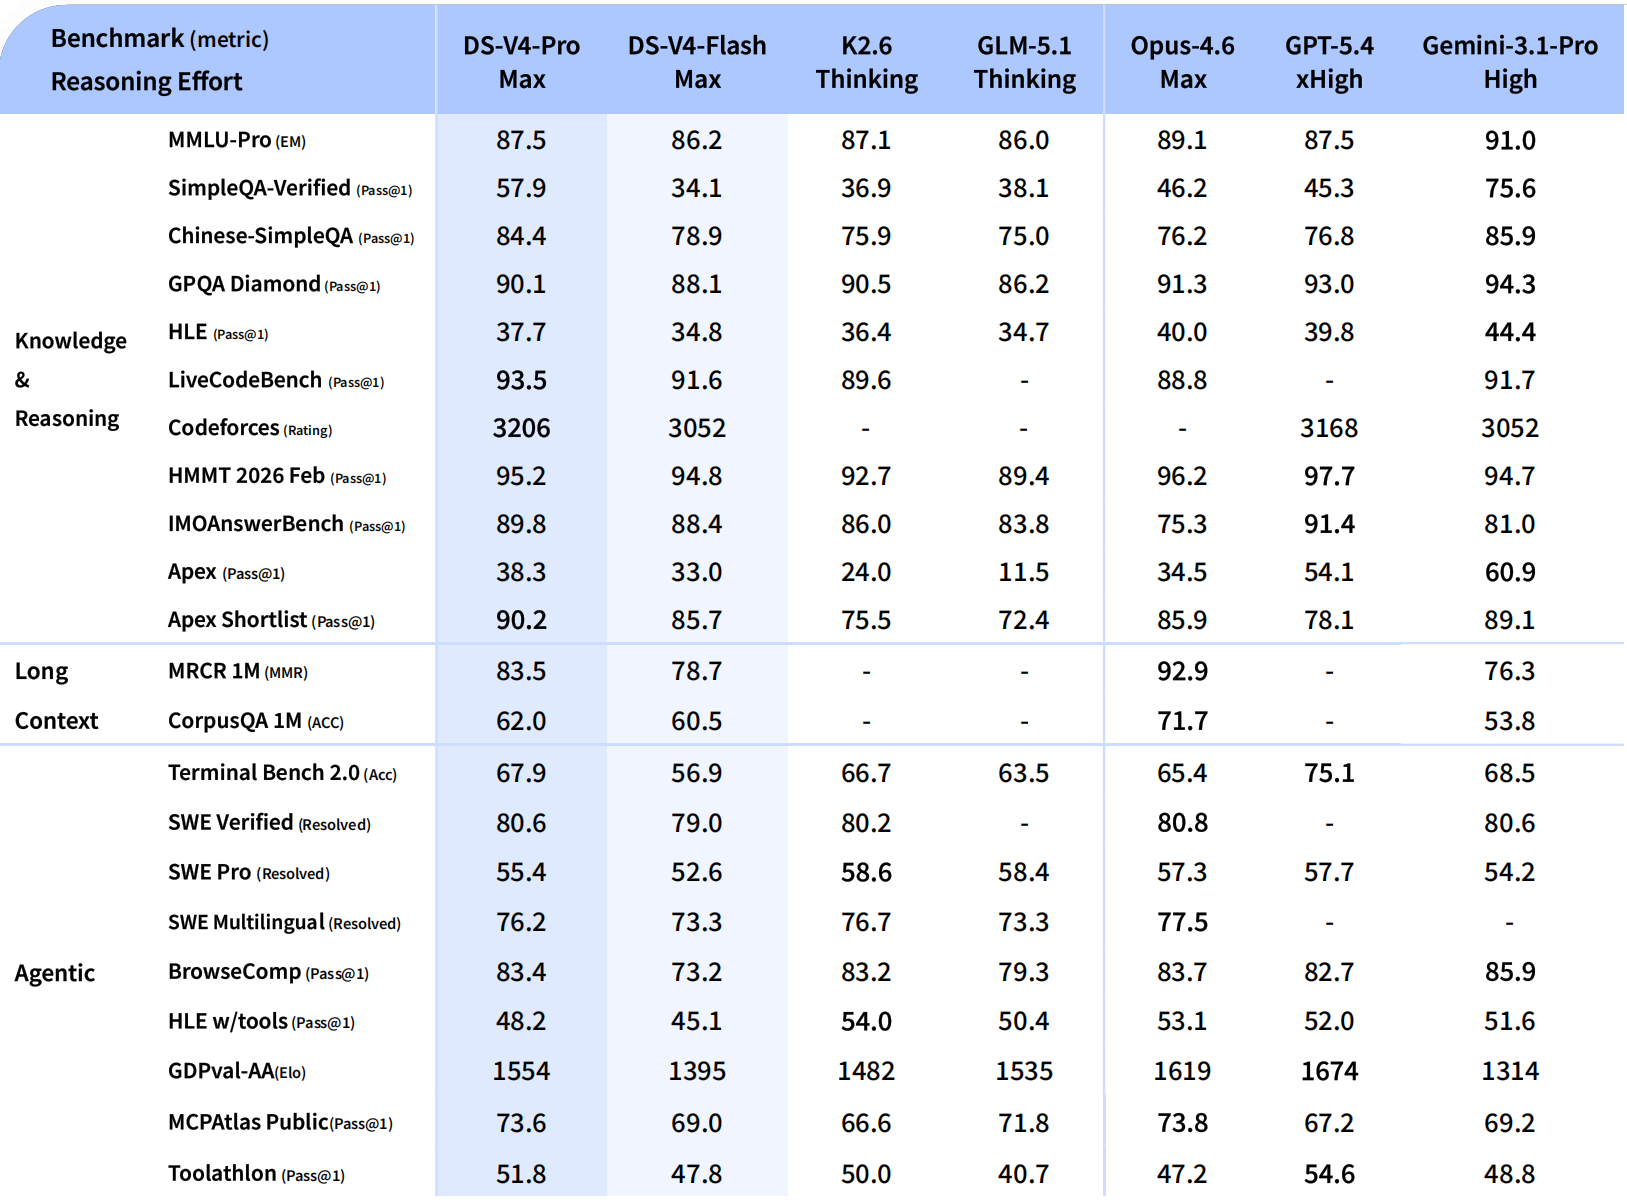
这是官方文稿里难得坦诚的一段,也是这篇新闻稿必须挑出来讲的。DeepSeek 自己的说法是:V4-Pro 在 Agentic Coding 上达到当前开源模型最佳,已被公司内部员工作为日常 Agent 代码模型使用,据评测反馈"使用体验优于 Sonnet 4.5,交付质量接近 Opus 4.6 非思考模式,但仍与 Opus 4.6 思考模式存在一定差距"。
拆开看:
- 对比闭源:能打 Sonnet 4.5,接近 Opus 4.6 非思考模式,但打不过 Opus 4.6 思考模式
- V4-Flash 简单 Agent 任务与 Pro 持平,高难度任务仍有差距
也就是说,如果你的 Agent 工作流里最难的那批任务现在跑在 Opus 4.6 思考模式上,V4-Pro 暂时还不是直接替代品;但如果之前用的是 Sonnet 4.5,或者 Opus 4.6 非思考模式已经够用,那 V4-Pro + 开源权重 + 更低推理成本的组合就很难拒绝。
V4-Pro 还额外提供 V4-Pro-Max 模式(最高推理强度),官方称其"进一步推进开源模型的知识能力,显著缩小与领先闭源模型在推理与 Agent 任务上的差距"——这意味着上面那个对比是默认档下的数字,Max 模式会更接近但代价是推理成本。
Agent 产品适配面也值得列一下:V4 针对 Claude Code、OpenClaw、OpenCode、CodeBuddy 等主流 Agent 产品做了专项适配与优化。OpenClaw 的中文开发者社区大概率会很快出现 V4 的接入教程。 两个版本、三档思考强度:deepseek-chat / deepseek-reasoner 7 月 24 日停用
使用侧改动:
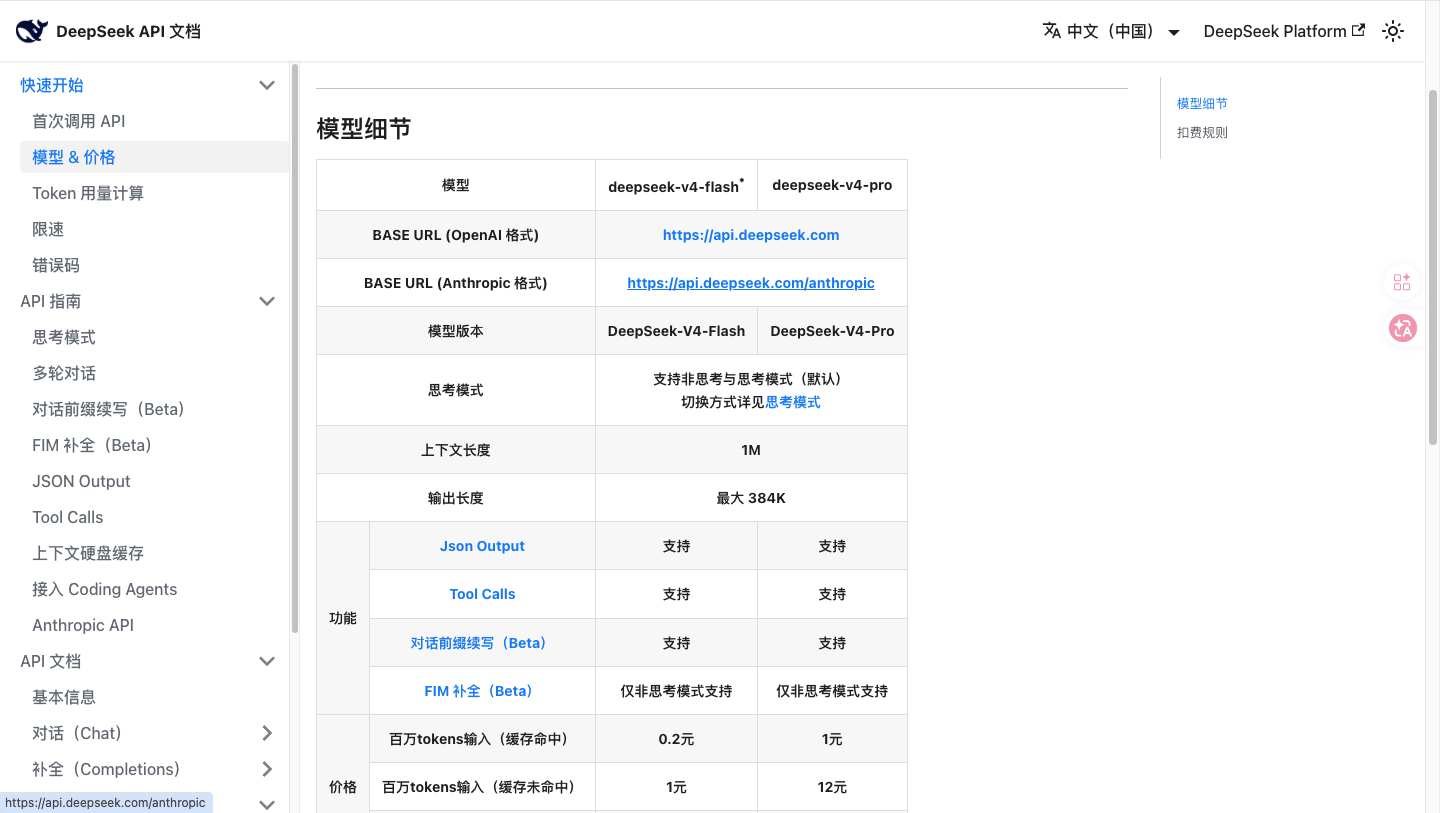
API 调用:base_url 不变,model 参数改为 deepseek-v4-pro 或 deepseek-v4-flash。支持 OpenAI ChatCompletions 接口和 Anthropic 接口——对现有 Claude Code、Cline、Continue 这类 Anthropic 接口的工具链直接可用。 思考模式:两款模型都支持非思考模式和思考模式,思考模式支持 reasoning_effort 参数设置 high 或 max 两档。复杂 Agent 场景官方建议用 max。
关键迁移节点:旧的 deepseek-chat 与 deepseek-reasoner 两个模型名将于 2026 年 7 月 24 日停用。在此之前,这两个名字分别指向 deepseek-v4-flash 的非思考模式和思考模式。也就是说,如果你的代码里还在写 deepseek-chat,从今天起实际上已经在调用 V4-Flash 非思考模式了,但 3 个月后必须换名。
开源权重:在 HuggingFace 和 ModelScope 同步开源。本地部署建议 temperature=1.0、top_p=1.0;Think Max 模式建议至少 384K 上下文窗口。
前瞻:开源阵营第一次把"模型 + 推理栈 + 国产芯片"做成工程闭环
把 V4 发布放回 4 月 23-24 日的这个两天窗口里看,节奏非常清晰:昨天 TileKernels 和 DeepEP V2 开源放出 FP8/FP4、Engram 门控、MoE 路由的底层算子,今天上午 V4 预览版带着 FP4+FP8 混合精度正式上线——这是把底座和模型同步开源的组合拳,而不是"先放模型再配工具"的传统路径。
外部背景同样值得一句:Reuters 4 月 3 日报道称 DeepSeek V4 将跑在华为昇腾 950PR 上,且 DeepSeek 刻意未给 NVIDIA 早期访问,只开放给国产芯片厂商。V4-Lite 在 API 节点灰度测试阶段,开发者反馈 128K 上下文召回率从 V3 的 45% 跳到 94%,推理延迟下降 30%。这让 V4 不只是"又一个开源 SOTA"——它是开源阵营第一次把"模型 + 推理栈 + 国产芯片"在同一个时间窗口里做完闭环。
对中文独立开发者和内容团队来说,实操上有两件事现在就可以算账:1M 上下文稳定可用后,哪些 RAG 流水线可以回到朴素 prompt? 整个代码仓库、整套新闻素材、整月的会议记录一把塞进去,不再需要向量检索这一层;推理成本的账怎么重算? V4-Flash 非思考模式已经是现在 deepseek-chat 的替身,价格梯度刷新后对 SEO 文章流水线、批量内容生产这类重 token 消耗场景会是直接的账单优化。
唯一的不确定性:这是预览版。真正能不能拉到 Opus 4.6 思考模式的水平、1M 召回率在压力测试里能不能稳住、开源社区独立评测的结果出来后是不是和官方自评一致——要等接下来两三周。但今天发出来的这一版,已经足以让"等 V4"变成"用 V4"。
 AI 速览