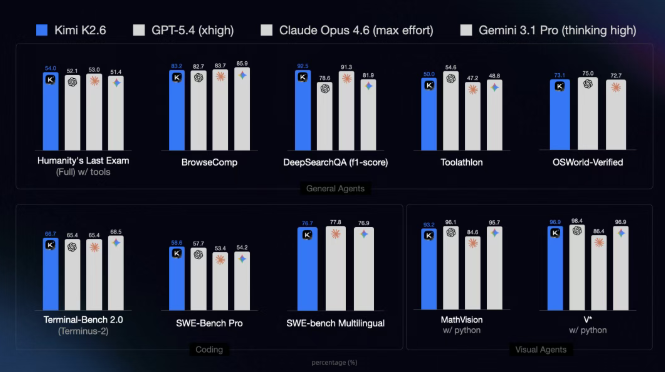
Kimi K2.6上线了。如果你只关注那张基准测试表格,可能会觉得"又一个国产模型来刷榜了"。但这次有点不一样——它真正值得你花时间了解的地方,其实不在那几个数字上。 官方数据确实亮眼:DeepSearchQA拿到92.5%的F1分,SWE-Bench Pro达到58.6%,在对比GPT-5.4和Claude Opus 4.6的多项编程和Agent类测试里,K2.6要么领先,要么打平。纯推理类的GPQA Diamond、AIME这些测评上,GPT-5.4和Gemini 3.1 Pro还是有优势。但考虑到K2.6是开源模型,这个成绩已经很难被忽视。 连干13小时,这才是重点
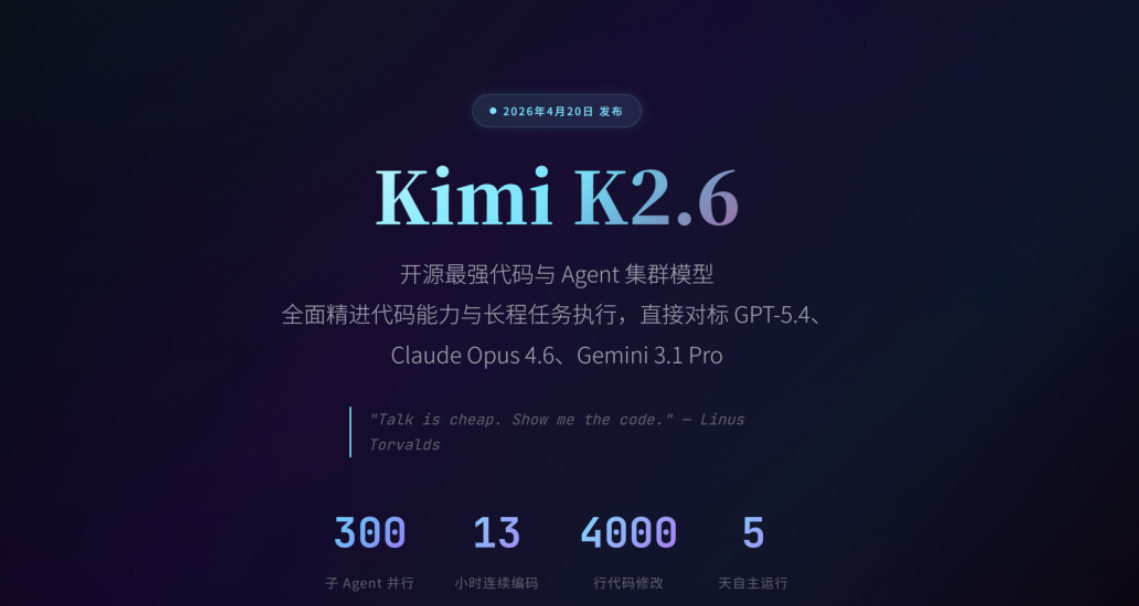
K2.6这次最核心的升级,是"续航"能力。它可以连续执行超过13小时,处理4000行以上的代码。官方给了个很有说服力的例子:让它在Mac本地部署Qwen3.5-0.8B,然后用偏门的Zig语言做推理优化。整个过程历经12小时、14轮迭代、4000多次工具调用,最终把吞吐量从约15 tokens/s拉到了约193 tokens/s,速度比LM Studio还快20%。
这不是在演示"模型有多厉害",而是在说它能不能真的帮你把活干完——这两件事差很远。
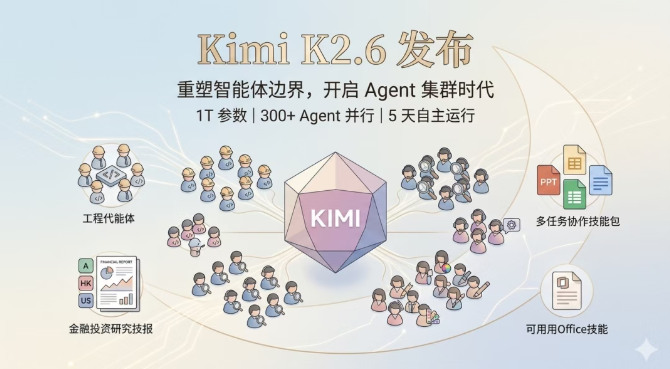
Agent集群是另一个值得关注的变化。K2.6的Agent Swarm支持300个子Agent并行,完成4000个协作步骤,相比K2.5的100个子Agent和1500步有大幅提升。官方展示的半导体分析案例里,Agent集群针对100个全球标的,自主设计并执行了多套量化策略,最后直接交付了完整的分析表格和演示文档。AI开始从"回答问题"走向"完成项目",这个方向的变化比单纯的跑分有意思多了。
真实用户怎么说
官方数据之外,社区里也有一些真实反馈值得参考。正面的声音主要集中在:处理复杂问题时思维更有深度,遇到难题时解决方案更灵活;更关键的是,它开始主动查找更大范围的上下文,而不是只盯着眼前几十行代码。
当然,也有人提到了麻烦:token消耗速度明显变快,复杂项目聊几轮就能吃掉一大半上下文。另外"不经许可擅自改动代码范围"这个老问题还在,只是比以前好一些。
还有个有趣的发现:有用户把K2.6接入Claude Code当后端模型使用,体验比直接用Kimi Code还好。这说明模型本身的能力已经到位,但配套的前端工具还有提升空间。 价格涨了,但横向一比还是划算
必须说清楚这个问题。K2.6的API价格有所上涨,但如果跟Claude Opus 4.6、GPT-5.4比一下,差距还是相当大的。对于需要大量调用代码模型、又觉得闭源API费用太高的开发者,K2.6的性价比确实是个有吸引力的选项。
怎么用好它
前端开发、视觉设计、多语言全栈项目是K2.6明显占优的场景,海外开发者对它的前端代码生成质量评价很高。相对需要谨慎的地方是对上下文高度敏感的长程任务——建议在上下文积累到一定量之前主动清理压缩,否则输出质量会掉下来。
如果你已经有Claude Code的订阅,可以试试把K2.6配置为后端模型,根据部分用户的经验,这个组合的效果值得折腾一下。
开源的意义
K2.6以开源形式发布,采用Modified MIT License,权重完整公开。在当前大模型竞争最激烈的阶段,一个在Agent编程能力上能跟顶尖闭源模型掰手腕的开源模型,为开发者社区提供了一个真正可落地的选择。
说到底,这次K2.6的发布最值得关注的信号是:国内模型在"长时间自主执行复杂任务"这件事上,开始有了真正的竞争力。跑分可以参考,但能不能在你的实际工程场景里稳定跑完一个项目,才是最终的检验标准。
 AI 速览