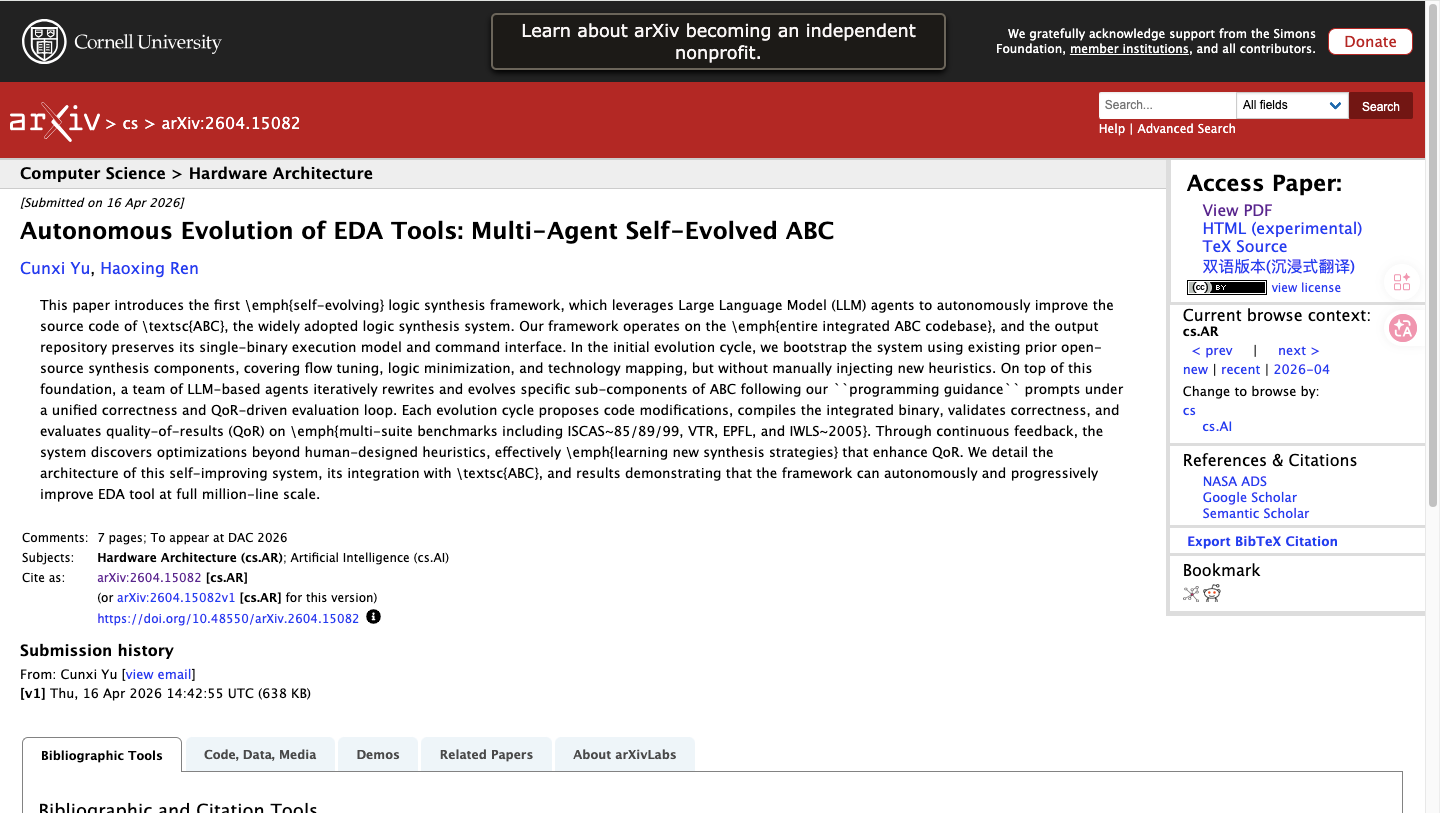
NVIDIA Research 与马里兰大学的 Cunxi Yu、Haoxing Ren 在 arXiv 上挂出一篇即将在 DAC '26(7月26–29日,加州长滩)正式发表的论文 Autonomous Evolution of EDA Tools: Multi-Agent Self-Evolved ABC(arXiv:2604.15082v1),把"让 LLM 智能体自主进化整个 EDA 工具"这件事第一次推到了百万行代码量级。
具体做法是用 Claude Sonnet 4.5 的多智能体在 ABC 这套全球最常用的逻辑综合系统上跑自我演化——ABC 主线代码约 85 万行 C 语言,团队整合相关研究后扩展到 120 万行 C 代码、4000+ 源文件、四层抽象,智能体在不破坏正确性、不更换二进制接口的前提下,反复修改源码、编译、形式化等价校验、跑 benchmark,最终把整体综合 QoR 从 baseline 1.00 推到 0.917,约 8.3% 的提升。 整篇论文对 EDA 工程界、AI Agent 圈、以及 LLM 编程能力研究都有直接信息量,下面分别拆开看。
这次工作把 LLM 自我进化代码的量级从万行推到百万行
把这篇论文放回到 LLM 自主进化代码的时间线上更容易看出它的位置。Google DeepMind 的 AlphaEvolve(2025)只动几百行级别的孤立内核或函数,把一段段算法当成被微调的对象;NVIDIA 自家 2025 年的 SATLUTION 把规模拉到完整 SAT 求解器,几万行 C/C++,靠 DRAT 证明做正确性兜底,最终进化出超越 SAT Competition 冠军的求解器。
Self-Evolved ABC 这篇直接把目标换成了一整套 EDA 工具。ABC 有几个属性使得这件事比 SAT 难得多:代码量是 SATLUTION 目标的几十倍;模块互相耦合,cut 选择、refactor 阈值、choice 节点扩张、cost 估算这些启发式都共享底层数据结构,改一处往往牵动多处;目标是多维的,要同时考虑 area、delay、depth、node count、mapping cost 而不是单一 runtime;NP-hard 决策处处都是。论文核心动作是把这种规模和耦合度通过"多智能体 + 子系统拆分 + 形式化等价检查"这套组合拳拿下来。
多智能体分工:一个 Planning Agent 统调度,三个 Coding Agent 各占一块代码区
架构核心是不让单一智能体面对整个 120 万行代码库,而是按 ABC 的子系统切成三块,每块由一个 Coding Agent 独占。第一个是 Flow Agent,负责 src/opt/flowtune/,对 pass 选择、停止条件、条件流程做演化,初始用 FlowTune 的 C 实现作为起点;第二个是 Mapper Agent,负责 src/map/mapper/,专攻 cut 枚举、剪枝、cost scoring 的启发式参数;第三个是 Logic Minimization Agent,负责 src/base/abci/,专攻 AIG rewriting、resub、refactor、orchestration 这些 technology-independent 优化。
三个 Coding Agent 之上是一个 Planning Agent,吸收上一轮 QoR 反馈,决定下一轮该让哪个子系统演化、要做什么修改。所有 Agent 都用 Claude Sonnet 4.5 实例化。这种分工的关键不是"多智能体"本身,而是每个智能体的修改严格限制在自己的目录里,不允许跨边界改 build 系统也由 Planning Agent 在 cycle 0 通过仓库 profiling 学到 module.make 规范,新模块自动符合现有 Makefile 层级。这样的隔离把跨模块崩坏的可能性压到最低。
人类介入只有 cycle 0:研究者提供仓库 profiling、Markdown 形式的"教程"(如何加新函数、注册新命令、用 ABC API),以及三阶段进化规则与禁忌规则。论文里特别提到一个细节——他们把所有引导材料从自然语言改写成结构化 Markdown 后,Agent 的可靠性显著提升、幻觉减少;这个对所有做 LLM Coding Agent 的人是个直接可复用的工程经验。从 cycle 1 开始,系统全自动跑,只有连续 10 次以上编译失败或等价检查失败才触发安全干预。
形式化等价检查:把 90% 以上的 Token 花在有效代码状态上
ABC 的核心问题之一是"一个错误的 rewrite 规则可能悄悄破坏 netlist,让评估器读到一个看起来更好其实是错的 QoR"——SATLUTION 已经踩过这种坑,会引发大规模 LLM 周期浪费、反复回滚。论文的解决方案是把组合等价检查(CEC)作为每一次代码修改后、QoR 评估前的硬卡点。
具体用 ABC 自带的 cec 和 dsat 命令,对优化前后的电路做组合等价证明;因为这套系统不动 retiming 也不动时序逻辑,时序电路通过 BMC depth=1 验证寄存器输入端的组合逻辑等价就够了。任何 mismatch 或 SAT 反例直接终止当前 iteration,并把反例反馈给 Planning Agent。这一招带来的最直接收益是 token 经济性:超过 90% 的 token 都花在了语义合法的代码状态上,避免了 SATLUTION 中常见的"反复修补错代码"循环。论文给出一个具体数字——总 token 成本约 $2,400 跑出全部实验,初始 profiling 阶段约 $1,400,每个进化 cycle 约 $60–80,剩余在 cycle 间分摊。
QoR 数据逐项拆:单系统进化 ~3% 增益,三系统协同进化 8.3%
论文的核心 ablation 表(Table 2)值得逐项看。Baseline 设为 vanilla FlowTune + vanilla AIG 优化 + vanilla Map = 1.00(normalized QoR,越低越好);vanilla 原版 ABC(不带 FlowTune 等扩展)是 1.21,已经差了 21% 的距离。单子系统进化结果:Evo FlowTune 单独把 QoR 拉到 0.962,Evo AIG Syn(rewrite + resub + refactor + orchestrate 演化版)单独是 0.957,Evo Map 单独 0.988。两两组合:FlowTune + AIG Syn = 0.924,FlowTune + Map = 0.939,AIG Syn + Map = 0.942。三个全开:0.917,整体相对集成基线提升约 8.3%。
把这些数字翻译到 EDA 工程师能直接读懂的指标上:在 ASAP7 7 nm PDK 跑全流程(逻辑优化 → 映射 → buffering → gate sizing → STA),全进化版本相对 vanilla 集成基线,worst negative slack 平均改进 8–9%,EPFL 几个算术电路改进 12–15%;area-delay product 减少约 8.3%,与 Table 2 normalized QoR 0.917 对得上;中间结构指标也跟着改善,AIG 节点数在算术密集设计上减少 3–8%,post-mapping 深度减少 4–6%。
论文给出的解释是三个子系统在功能上互补:FlowTune Agent 负责上游结构化简化,Orchestrate Agent 减少中段的逻辑冗余与深度,Mapping Agent 引入了"depth-sensitive tie-breaking"减少 mapped delay;这种互补性在单系统进化时拿不到,必须三系统共演化才能完整体现。
计算成本与速度:87 节点并行,每轮 2–3 小时跑完八套 flow 加 CEC
论文给出的工程数据对想复现或借鉴这套方法的团队最有价值。集群配置是 87 个 AMD EPYC CPU 节点,每轮 iteration 把所有 benchmark(ISCAS '85/'89、ITC '99、EPFL、VTR DSP、IWLS 2005、一批算术单元)在 8 种 synthesis flow 下并行评估,外加 CEC,全程 2–3 小时;这种节奏让 Planning Agent 每 2–3 小时就能拿到一份高分辨率反馈。
Token 消耗的分布很反直觉但合理:68% 花在 ABC 代码库 profiling,11% 花在外部相关代码库 profiling,只有 21% 花在真正的进化 cycle 上。换句话说,"读懂这个代码库"远比"改这个代码库"更费 token——一旦 Agent 理解了 ABC 的架构,后续每轮的边际成本很低。智能体生成的产物里 45% 是 C 源码(共 87,749 行),其余是 Markdown、bash、Python、log,这个比例侧面证明了 LLM 在做"代码 + 工程文档"这类协同产出时的真实分工。
智能体擅长什么、不擅长什么:放大已有结构 vs 提出全新范式
论文里最有信息量的反思在 4.3 节。一个出人意料的现象是,尽管 Agent 在 cycle 0 接触了大量异构外部研究仓库,但生成的 C 代码会向 ABC 原生编码风格收敛——格式、命名、注释结构、宏组织、Abc_Print 用法、参数 help string、缩进、宏驱动默认值,几乎与人手写的 ABC 模块无法区分。论文展示的 abcFlowTune7.c(cycle 7 自动生成)头文件布局完全照抄 ABC 风格。
更值得 EDA 圈和做 Agentic Coding 的人共同关注的是另一个观察:Agent 在"细化已有方向"上表现极强——调整被忽视的阈值、加深度感知的 scoring、补条件启发式都做得很好;但一旦尝试引入完全新的算法范式(在 ABC 现有不变量里没有锚点的那种),失败率显著上升,常见错法是编译错误、segfault、或细微的正确性破坏,且这些往往无法靠 self-debug 解决。这意味着当下这一代 LLM Agent 在 EDA 领域的真实角色是"放大器 + 重组器",把人类积累的启发式做更细致的组合与微调;要它从零想出一套新的逻辑综合理论,目前还做不到。
与 AlphaEvolve、SATLUTION 的位置关系,以及对 EDA Agent 这个新赛道的意义
把这三项工作放在同一坐标系下能更清楚看出 Self-Evolved ABC 的价值:AlphaEvolve 解决"小内核能否被 LLM 优化",SATLUTION 解决"完整求解器仓库能否被 LLM 演化",Self-Evolved ABC 解决"百万行级、多目标、强耦合的工业级工具能否被 LLM 演化"。三者的正确性兜底机制也对应了三层难度:AlphaEvolve 靠 evaluator 函数返回标量分数;SATLUTION 用 DRAT 证明 UNSAT 实例;Self-Evolved ABC 用 CEC 验证组合等价加 BMC 处理时序。这条递进路径已经把 LLM 自主进化代码的可行边界拉到了主流 EDA 工具规模。论文最后也明确表态——这次成果离不开几十年来 ABC 社区与逻辑综合学界的算法积累,Agent 起到的是"在已有知识基础上做高频小步迭代"的角色。
横向看 EDA Agent 这个新赛道,2026 年同期的相关工作还有 Yao 等人的 EvoPlace(用 LLM 演化全局布局算法),以及 Ghose、Kahng 等人对 Agentic AI 在物理设计 R&D 中前景的综述。Self-Evolved ABC 的差异化在于,它不是"用 Agent 解决一个具体 EDA 优化问题",而是"让 Agent 直接进化解决问题的工具本身",这个层级差距决定了它的复用面更广——同一套多智能体 + 子系统切分 + 形式化等价反馈的框架,理论上可以套用到 OpenROAD、Yosys、其他物理设计 / 综合 / 验证工具的演化上。
局限与待解决问题
论文自己点出了几条硬限制,外加从工程角度看还有几条值得提:
其一,Agent 不擅长引入完全新的算法范式,这意味着 8.3% 的 QoR 提升大部分来自对已有启发式的精细化重组,要想突破到下一个数量级,需要在 Agent 的"知识引入"层做更深的工作(比如让 Agent 主动消费学术论文 PDF、自动复现新算法);
其二,68% 的 token 花在初始 profiling 上,这部分成本对每个新工具仓库都要重新支付,跨工具复用的"通用 EDA 仓库知识"目前不存在;
其三,正确性兜底依赖 CEC,对纯组合或可拆解为组合的电路有效,对真正的时序综合(retiming、scan chain 插入、复杂时序优化)这套范式还没覆盖;
其四,多目标 reward 的设计仍然是手工的,论文没有探讨"让 Planning Agent 自主调整 reward 权重"会不会带来进一步提升或失稳;
其五,所有 Agent 都用同一个 Claude Sonnet 4.5,没探讨不同模型组合(比如 Planning 用更强模型、Coding 用更便宜模型)的成本-效果权衡;
其六,CEC 对 SAT-based 检查在大型工业电路上仍可能 timeout,论文没给具体的失败率数据;
其七,整套实验都跑在 ASAP7 7 nm 上,没在更老节点(如 28 nm)或 FPGA-only 流程上做交叉验证,跨节点泛化性是开放问题。
对 EDA 工程师与做 LLM Coding Agent 的人各自的实操启示
对 EDA 工程师和综合工具用户:短期内你不太可能直接拿到 Self-Evolved ABC 的二进制——论文没说会开源进化后的代码,且作者明确表示这是研究框架。但这件事说明一个趋势:综合工具的"启发式参数空间"过去靠手工调节、近几年靠 RL,现在又多了一条"让 LLM Agent 自动迭代 C 源码"的路;如果你所在团队维护内部 EDA 工具,这套方法论是可借鉴的,关键是把 CEC 这类形式化验证设施做扎实,剩下的事 Agent 才能跑得动。
对做 LLM Coding Agent 的人:四个直接可借鉴的工程经验——Markdown 引导比自然语言可靠;按子系统拆分专门 Agent,比单一巨型 Agent 更稳;正确性硬卡点(CEC、形式化证明、单元测试)是降低 token 浪费的最大杠杆;初始 profiling 阶段的 token 消耗远高于演化阶段,做"代码库知识缓存"是值得投资的方向。预算粗算:复刻类似规模的实验,Claude Sonnet 4.5 这个体量的模型大概 $2,000–3,000 的 token 成本加上几十节点的 CPU 资源,是一个独立研究团队可以承受的级别。
对关注 AI for EDA 这条赛道的研究者:这篇论文已经把"百万行工业工具能不能被 Agent 演化"这个问题从开放变成了"可行但要解决一系列工程挑战"。下一个值得跟踪的节点是:(1) Agent 能否在没有人手 Markdown 教程的情况下完成同等任务;(2) 演化能否扩展到时序综合、物理设计、甚至 RTL 生成;(3) 同一套方法能否复用到 OpenROAD、Yosys 等其他工具,从而出现"Agent 跨工具知识迁移"这种二阶效应。
整体看,Self-Evolved ABC 在 EDA × LLM 这两个交叉地带留下了第一个明确可参考的工程坐标——8.3% 的 QoR 提升数字本身固然漂亮,但更值得记的是"如何把 LLM Agent 安全推进百万行代码"的这套工程范式:子系统切分、Markdown 引导、CEC 硬验证、Self-Evolving Rulebase、87 节点并行评估。这套组合拳大概率会在未来一两年成为 EDA Agent 类工作的标配模板。
 AI 速览