4 月 28 日,商汤科技正式发布全新多模态大模型SenseNova‑U1,以 “不堆参数、重构架构” 为核心思路,在仅 8B 参数的轻量规格下,实现图像理解与生成的原生统一,多项能力逼近 GPT‑Image‑2,登顶开源模型榜首,且已全网开源。
一、核心定位:轻量架构打破多模态壁垒
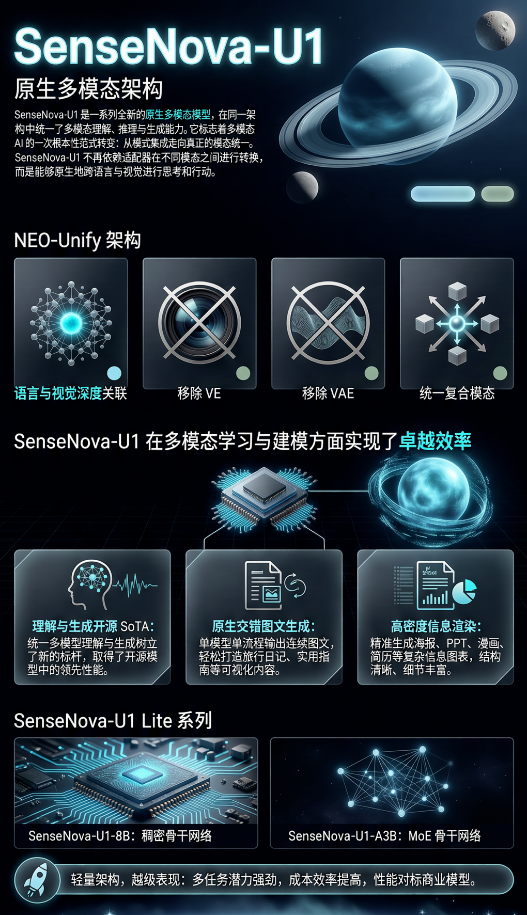
SenseNova‑U1 放弃传统 “大参数堆料” 路线,采用自研NEO‑unify统一架构,用一个模型同时完成 “看懂图像” 与 “生成图像”,无需独立视觉编码器与图像解码器,直接处理像素输入输出。模型提供双版本:轻量版8B可端侧运行;增强版38B MoE面向高强度任务。
搭配自研 LightLLM 与 LightX2V 推理栈,2048×2048 图像生成仅需约 9 秒,速度接近商用闭源模型。凭借架构创新,8B 版本即可高质量完成图文排版、信息图、教程插画、产品爆炸图等 AI 生图传统难点任务,与头部闭源模型同台竞争。
二、原生能力:图文交错创作与物理级推理
U1 最突出的是原生连续性图文创作,文字与图像共享上下文、自然穿插,解决传统模型语义与像素难以兼顾的问题:
- 连贯主体生成:煎牛排、漫画分镜、咖啡制作等教程,主体形象全程一致,无需多模型接力。
- 高密度信息图:支持简历海报、科普图解、试卷版式、连环画等复杂排版,文字层级与布局规整。
- 图像迁移重构:可将警示牌、海报等重新排版,生成风格统一的科普卡片。
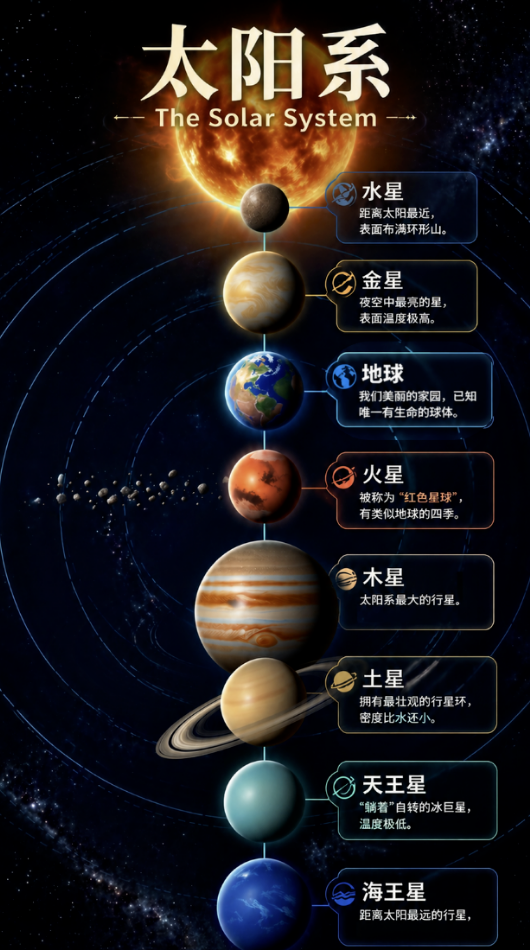
- 精细结构表达:相机爆炸图、太阳系图解等带标注线的专业图示,精准还原组件关系。同时,U1 首创图文交错思维链,具备物理常识推理:能根据 “热茶放置一小时” 推导茶汤变色、叶片沉降、光影变化等细节,生成结果更符合现实逻辑。
三、技术底座:NEO‑unify 架构实现统一表征
U1 的能力源于 NEO‑unify 架构,核心突破三点:
- 统一视觉接口:图像输入输出采用近似无损表征,语义与像素保真同时保留。
- 共享 Transformer 主干:理解与生成共用底层网络,消除模块拼接损耗。
- 双路径协同:文本自回归、视觉像素流匹配在同一框架优化,原生支持图文混排。相比传统多模态模型需要外挂工具或后处理拼接,U1 单次调用即可输出完整图文内容,流程更简洁、效果更稳定。
四、开放生态:全网开源 + 技能包,快速落地
SenseNova‑U1 已在 GitHub、Hugging Face 全面开源,开发者可直接下载权重与代码。商汤同步发布SenseNova‑Skills技能包,内置 87 种版式、66 种风格,支持一键生成信息图,并可作为工具集成到 AI Agent,通过简单指令调用。模型也披露当前局限:32K 上下文限制、复杂人物细节偶现不稳定、长文字排版存在优化空间,官方表示将持续迭代。
五、行业价值:轻量开源重构多模态应用
SenseNova‑U1 以小参数、强架构、开源开放,降低高质量图文生成门槛,为设计、教育、办公、工业可视化等场景提供高效方案:个人与小团队可免费使用,摆脱商用模型额度限制;开发者可快速二次开发,搭建图文创作、智能教学、可视化分析等应用。
整体来看,商汤 SenseNova‑U1 证明轻量模型可通过架构创新实现顶级能力,推动多模态 AI 从 “参数竞赛” 走向 “效率与实用优先”,为开源生态注入新动力。
 AI 速览