字节跳动联合北京交通大学、南洋理工大学发布的 GenLIP(Generative Language-Image Pre-training)正在改写视觉编码器的训练范式。这套方法用一个 Transformer、一个自回归损失函数,让 ViT 直接从视觉 token 预测语言 token,仅用 8B 训练样本就在 MLLM 视觉编码器评测上全面超越用 40B 样本训练的 SigLIP2。在 Qwen2.5-7B 冻结视觉表示评测中,GenLIP-g/16 拿到 73.6 的全任务平均分,比 SigLIP2-g/16 的 68.9 高出 4.7 分。论文挂上 arXiv 编号 2605.00809,代码与三个规格的预训练模型已在 GitHub 与 Hugging Face 同步开源。
核心架构:抛弃对比学习,只保留语言建模目标
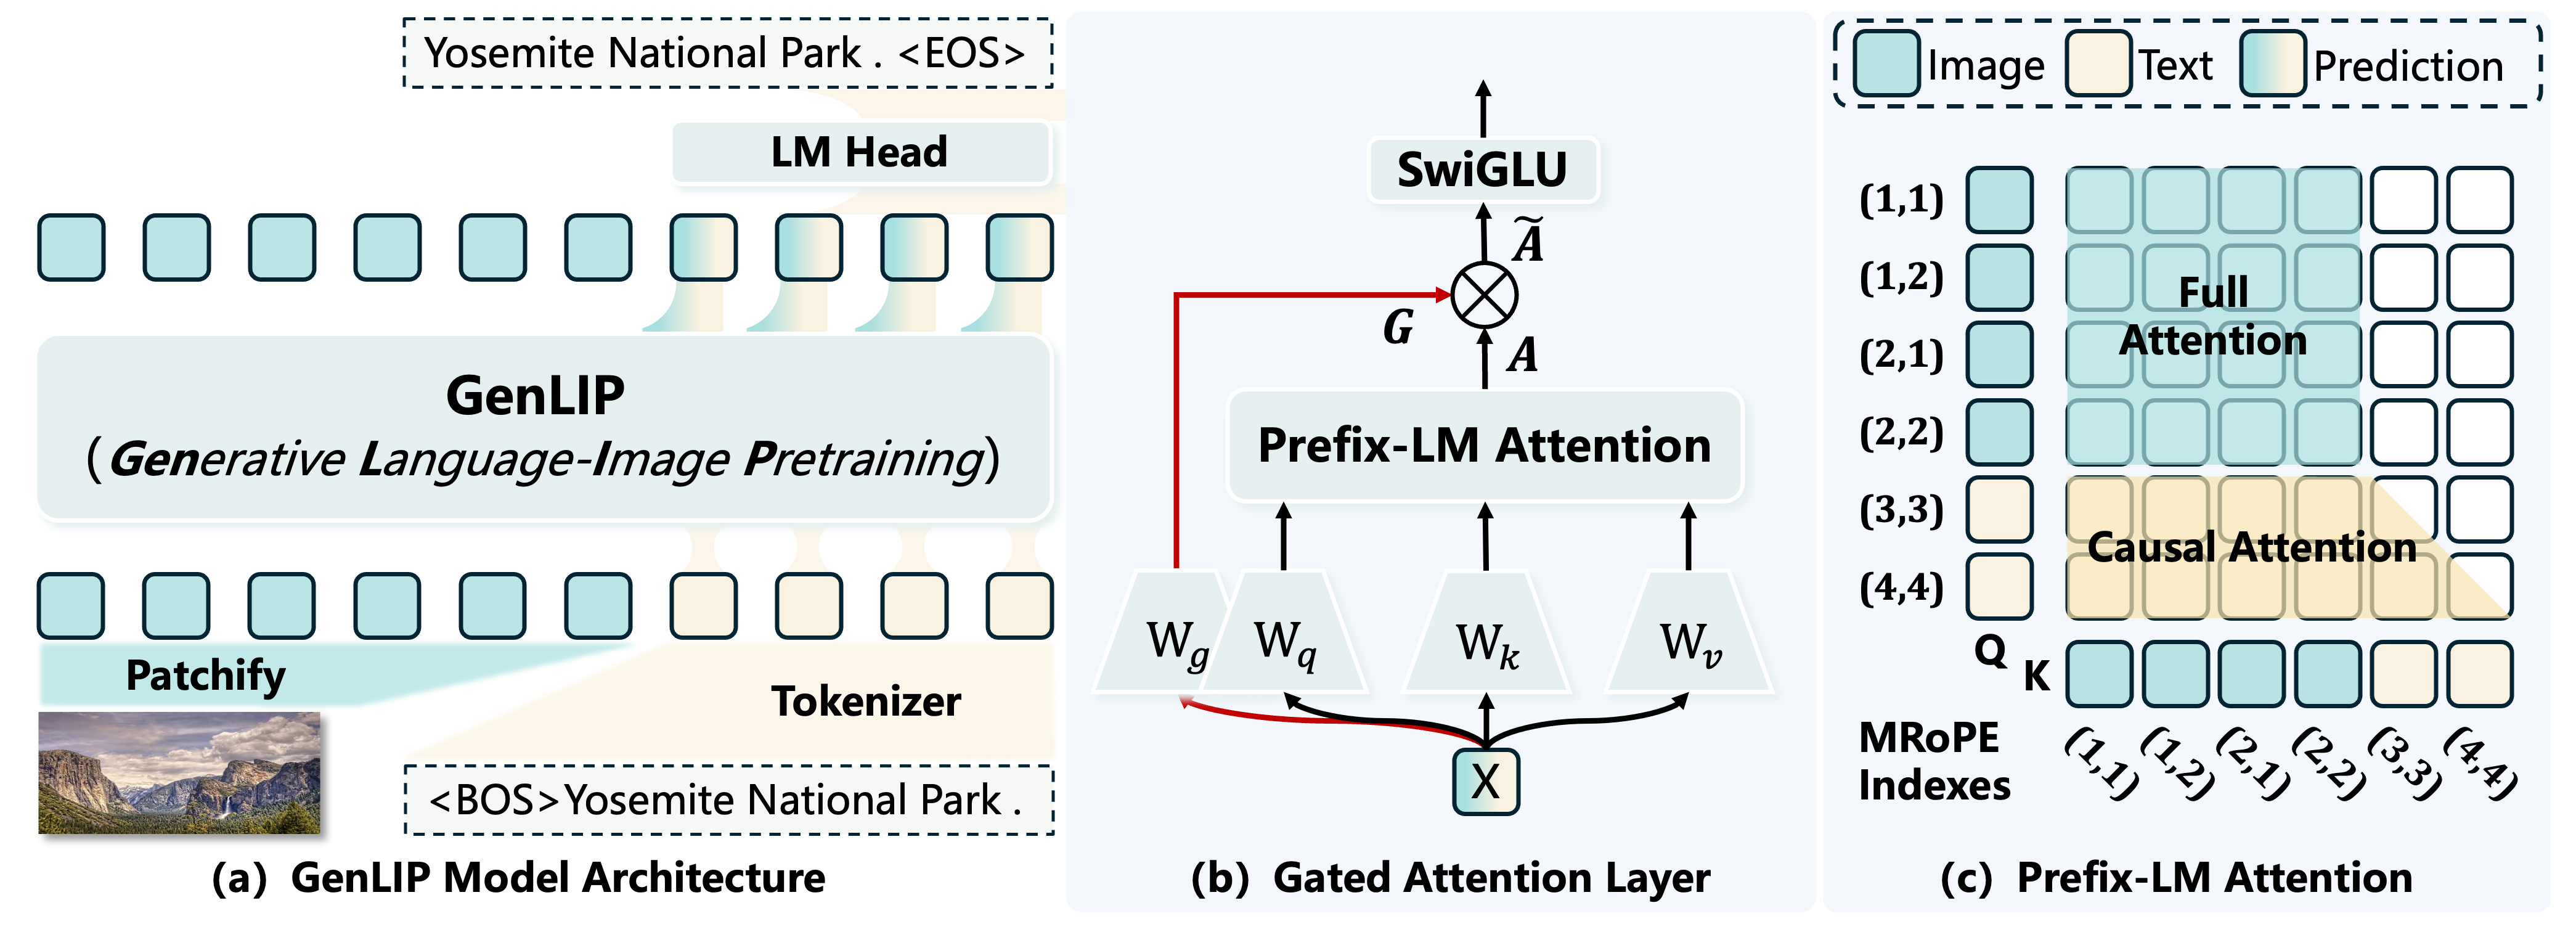
GenLIP 的设计哲学是把 ViT 当成 LLM 的"前端编码器"来训练,而不是把视觉模型与文本模型对齐。具体做法是把图像 patch 与文本 token 拼成一条序列,送进同一个 Transformer 联合建模。视觉 token 之间是双向注意力(bidirectional),文本 token 之间是因果注意力(causal),这就是所谓的 Prefix-LM 目标——损失函数只施加在文本 token 上,要求模型基于全部视觉信息预测下一个文本 token。
这种设计与 SigLIP 系列的关键区别在于完全去掉了对比学习。SigLIP/SigLIP2 走的是"图文对齐 + decoder 辅助预训练 + DINO 自蒸馏 + 掩码预测"的多目标组合,需要构建大批次的对比样本,工程上对显存和分布式训练的要求很高;GenLIP 只有一个 next-token-prediction loss,没有对比批次构建,没有独立的文本 decoder,部署时直接砍掉语言头,把 Transformer 当 ViT 用。Apple 的 AIMv2 也走自回归路线,但 AIMv2 同时回归图像 patch 和文本 token,用的是双任务因果解码器;GenLIP 则把图像侧改为双向注意力,只让文本侧自回归,在数据效率和稳定性上拉开差距。
为了解决纯生成式预训练长期存在的 attention sink 问题,GenLIP 引入轻量级 Gated Attention,在注意力输出处加一个门控,稳定视觉表示的学习曲线。论文展示的 1B 到 8B 数据扩展曲线显示,加了门控后 OCR、VQA、Caption 三类探针任务都呈稳定上升,而非典型生成式预训练在小尺度上表现疲软的曲线形态。
Benchmark 逐项拆解:超越主流编码器的具体位置
把 GenLIP 与三个主流视觉编码器(SigLIP、SigLIP2、OpenVision2)放在 Qwen2.5-1.5B 与 Qwen2.5-7B 两套冻结视觉表示评测上对比,数据效率优势体现得相当具体。
在 Qwen2.5-1.5B 配置下,GenLIP-L/16 用 8B 数据拿到 49.3 的 Doc/OCR 七项平均分、MME-P 1258、ALL AVG 61.5;同规格的 SigLIP2-L/16 用 40B 数据是 45.0 / 1165 / 58.7,OpenVision2-L/16 用 12.8B 数据是 44.3 / 1230 / 58.7。GenLIP 在 Doc/OCR 上比 SigLIP2 提升 4.3 分、ALL AVG 提升 2.8 分,数据用量却只有后者的 1/5。换到 So/16 规格,GenLIP 的 Doc/OCR 50.1 / ALL AVG 62.6 同样压过 SigLIP2 的 46.8 / 60.6;到了 g/16 这一最大规格,GenLIP 的 53.2 / 65.2 进一步把 SigLIP2 的 47.3 / 61.5 甩开 3.7-5.9 分的差距。
放到更强的 Qwen2.5-7B 底座上,差距继续放大。GenLIP-So/16 拿到 Doc/OCR 62 / MME-P 1424 / Textcaps 142.1 / ALL AVG 71.8,SigLIP2-So/16 同位置是 56.7 / 1422 / 139.3 / 69.4。GenLIP-g/16 进一步推到 63.5 / 1483 / 144.8 / 73.6,而 SigLIP2-g/16 停留在 56.6 / 1422 / 142.7 / 68.9。Doc/OCR 任务上 GenLIP 平均比 SigLIP2 多出 6.9-7 分,MME-P 多出 60+ 分,Textcaps 多出 2-3 分。
最值得关注的是 OCR 与 Document 类任务的提升幅度系统性高于通用 VQA 与 Caption。这个分布与 Stage 2 训练设计直接相关——GenLIP 在初始 8B 样本预训练后,在原生纵横比的多分辨率图像上继续预训练,显著强化了高分辨率细节识别能力,这正是 MLLM 处理票据、表格、长截图、图表时最依赖的能力。从消融实验看,Stage 2 在评估分辨率上越高,OCR 与 VQA 的分数提升越明显,说明编码器学会了利用更多空间证据,而不是只在低分辨率全局特征上发力。
数据效率背后的方法论意义
5 倍的数据效率不是工程优化能解释的。SigLIP2 用 40B 样本训出 ALL AVG 61.5(g/16, Qwen2.5-1.5B 配置),GenLIP 用 8B 样本做到 65.2,意味着每个样本对模型的边际信息贡献显著更高。这背后的原因可以拆成三层:
第一,语言建模目标提供了密集监督信号。对比学习每个样本只输出一个对齐分数,生成目标对每个文本 token 都有梯度,Apple AIMv2 论文里也提出过同一观察。第二,Prefix-LM 把"视觉理解"压力放在双向注意力的视觉部分,模型必须学习全局图像结构才能预测文本,而不是把信息分散到对比学习的 anchor-positive 关系里。第三,Recap-DataComp-1B 这套数据本身是 LLM 重新生成的图像描述,语义密度比原始 alt-text 高出数倍,与生成目标天然适配。
横向对比下,这意味着开源社区训练高质量 MLLM 视觉编码器的算力门槛被显著降低。SigLIP2-g/16 复现需要 40B 图文对的算力预算,GenLIP-g/16 用 8B 样本做到更好的下游表现,对预算有限的研究团队和中型企业是非常实际的利好。
局限与待解决问题
GenLIP 目前的开源资源仍处于早期阶段。Hugging Face 上 GenLIP-L16-NaViT、GenLIP-So16-NaViT、GenLIP-g16-NaViT 三个模型已公开,但配套的下游 MLLM 微调示例、与 LLaVA / Cambrian / InternVL 等流行 MLLM 框架的集成代码尚未完整释出,demo 页面仍标注 coming soon。第三方独立复现验证还没有开展,论文给出的 73.6 ALL AVG 这一类数字仍属厂商自评,需要社区在更多 MLLM 配置(LLaVA-Next、Mini-CPM、Cambrian-1)和更广 Benchmark(MMVet、SEEDBench、MMMU)上交叉验证才能下定论。
技术层面也有几个开放问题。一是与 SigLIP2 引入的多语言能力对比,GenLIP 论文未公开非英语 OCR、跨语言图文检索等多语种评测数据,Recap-DataComp-1B 本身英文为主,这一点在 SigLIP2 的多语言强项面前可能形成劣势。二是定位与 Dense Prediction 任务,SigLIP2 强调了 open-vocabulary detection 与 dense feature 能力的提升,GenLIP 当前 Benchmark 集中在 MLLM 下游任务,在分割、检测等 Dense Prediction 场景的表现尚未公开。三是 Stage 2 多分辨率训练的算力开销,论文没有详细公开 Stage 2 占总训练成本的比例,实际复现成本仍需进一步澄清。
选型建议:谁应该考虑 GenLIP
如果你正在为以下场景挑选 ViT 视觉编码器,GenLIP 值得直接放进候选名单:第一,文档理解、OCR、表格图表解析为主的 MLLM 应用,GenLIP-g/16 在 Doc/OCR 上的 6-7 分领先优势直接转化为产品体验;第二,算力预算受限但希望追平 SigLIP2 性能的中小型团队,8B 样本的训练成本意味着复现路径更友好;第三,希望保持架构简洁、便于工程落地的应用方,单 Transformer 单 loss 的设计去除了对比学习相关的工程复杂度。
如果你的场景是多语言图文检索、零样本图像分类、Dense Prediction 这三类,SigLIP2 仍是更稳的选择,其多语言数据覆盖与 dense feature 优化是 GenLIP 当前未覆盖的空白区。如果你做的是图像生成而非 MLLM 编码,字节同期的 BitDance(二进制视觉 token)或 VAR(next-scale prediction)是更对口的方向。如果你希望尽可能减少训练复杂度并直接拿现成模型用,GenLIP 当前的三个开源 checkpoint(L/16、So/16、g/16)已经覆盖从 300M 到 1.1B 参数的常用区间,可以直接挂到 Qwen2.5、LLaMA、Mistral 等开源 LLM 后做下游训练。整体来看,GenLIP 不是要取代 SigLIP2 的全场景王者地位,而是在 MLLM 视觉编码器这一垂直方向上,把"用更少数据训出更强编码器"这条路径推进了一大步,生成式预训练范式与多模态 LLM 的天然适配性,可能会让这条路线在 2026 年继续吸引更多复现工作。
 AI 速览