Quant VideoGen 是什么?
Quant VideoGen 是 SVG Project 团队推出的开源 KV 缓存量化工具包,专门解决自回归视频扩散模型在推理阶段的显存爆炸问题。
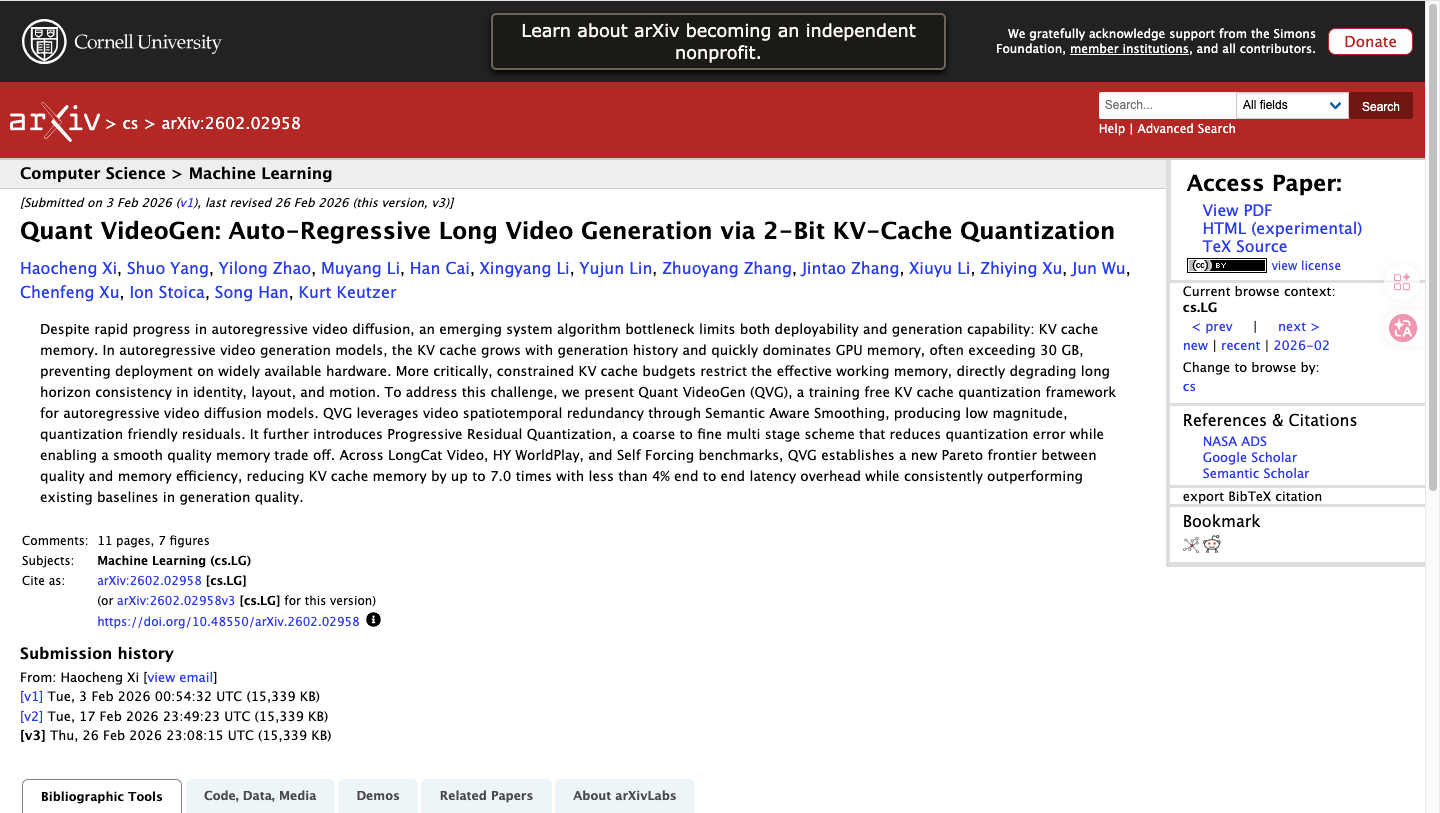
由 Haocheng Xi、Shuo Yang 等 16 位研究者共同完成(含 MIT 的 Song Han、UC Berkeley 的 Ion Stoica),论文于 2026 年 2 月 3 日提交 arXiv,最新修订版 v3 发布于 2 月 26 日。QVG 的核心定位是「无需训练、即插即用」——它不修改原始模型权重,仅在推理过程中对 KV 缓存做 2-bit INT2 量化压缩,从而将原本需要 A100/H100 级别显存的长视频生成任务,下放到 24GB 显存的消费级显卡上。
与 LLM 领域的 KV 缓存压缩(如 H2O、SnapKV)不同,QVG 是首个专门针对视频生成时空特性设计的量化方案。视频帧与帧之间存在大量空间和时序冗余(如静止背景、缓慢运动),QVG 利用这种冗余性,在几乎不损失生成质量的前提下,将 KV 缓存内存压缩至原来的 1/7。
核心技术与工作机制
QVG 的技术架构围绕两个核心模块展开:
语义感知平滑(Semantic-Aware Smoothing)。 视频帧中背景区域、静止物体的 KV 表示在时序上高度相似。QVG 通过轻量化的语义分析识别这些「低变化区域」,将其 KV 缓存直接复用或平滑处理,避免重复存储。这一步的关键产出是「低幅度、量化友好的残差」——为后续压缩创造理想条件。
渐进式残差量化(Progressive Residual Quantization)。 对于无法平滑处理的动态区域,QVG 采用粗到细(coarse-to-fine)的多阶段量化策略:先存储一个低精度近似值,再分层补充残差细节。这种方式比统一降精度更能保留关键信息,同时实现质量与内存的平滑权衡。
实现层面,QVG 基于 Triton 编写了 k-means / staged product quantization 内核,默认配置为 block size 64、256 个 K/V centroids。量化仅在推理阶段的 KV 缓存上执行,原始模型权重保持 BF16 不变。
实测效果与性能数据
QVG 在三个主流自回归视频模型上实现了 6.89x–7.01x 的 KV 缓存压缩,内存占用平均减少 85%。
GitHub README 提供的精确数据如下:
这意味着:
- 原本需要 46GB KV 缓存的 Self-Forcing 模型,量化后仅需 6.6GB
- 原本需要 29.7GB 的 HY-WorldPlay,量化后仅需 4.2GB
- 24GB 显存的 RTX 5090 可以同时容纳模型权重 + 量化后的 KV 缓存,完成长视频生成
论文提到端到端延迟开销低于 4%,GitHub 仓库未单独重复此数字,但提供了 BF16 与 INT2 的完整对比脚本,用户可自行验证。
使用场景与适合人群
QVG 最适合两类用户:显存受限的本地部署者,以及需要长视频生成的研究者。
| | |
|---|
| 22GB–46GB KV 缓存超出 24GB 显存上限 | 压缩至 3.2GB–6.6GB,RTX 5090 可运行 |
| | |
| | |
| | |
如果你正在使用 LongCat-Video、CogVideo、HY-WorldPlay 或其他自回归视频模型,且受限于显存无法生成超过 64 帧的视频,QVG 是目前最直接的解决方案。
同类方案对比
视频生成与 LLM 领域的 KV 缓存优化目前有几条路线:
QVG 与 H2O、SnapKV 属于同一技术家族(KV 缓存优化),但 QVG 是首个针对视频时空冗余做专门设计的方案。H2O 和 SnapKV 理论上可迁移到视频模型,但未做帧间语义分析,压缩率远低于 QVG。
4-bit 权重量化压缩的是模型权重而非 KV 缓存,两者可以叠加使用——先用 4-bit 量化减小模型体积,再用 QVG 压缩 KV 缓存,实现双重减负。
优缺点分析
✅ 优点
- 无需训练,即插即用:不修改原始模型权重,部署成本极低,有 BF16 基准脚本和量化脚本直接对比
- 压缩率极高且稳定:三个模型上均达到 6.89x 以上,最高 7.01x,是视频生成领域目前公开的最高水平
- 消费级显卡可部署:RTX 5090 24GB 显存即可运行 HY-WorldPlay 长视频生成
- 长视频质量有保障:论文在 LongCat Video、HY-WorldPlay、Self-Forcing 三个基准上验证,质量持续优于现有基线
- 开源完整:提供安装脚本、模型下载脚本、对比实验脚本,可复现
❌ 缺点
- 仅限自回归模型:QVG 利用的是逐帧生成的时序冗余,对非自回归模型(如一次性生成多帧的 Stable Video Diffusion)不适用
- 压缩率受内容影响:论文未给出动态场景 vs 静态场景的详细对比,实际压缩率可能在极限值附近波动
- 硬件门槛仍存:需要 CUDA 12 + PyTorch 2.8 + Flash Attention 2.8.3,老旧显卡或不支持 Triton 的环境无法运行
- 生态尚早期:仓库 2026-04-29 刚创建,目前 9 stars,尚未提供 Diffusers 或 ComfyUI 的一键插件,需要手动集成
- 精度边界待验证:7x 是极限压缩,日常推荐使用的压缩率与极限值之间的质量差异尚未有大规模用户测试数据
如何部署使用
部署 QVG 需要三步:环境准备、模型下载、运行对比脚本。
1. 环境准备(要求 Python 3.12.9、CUDA 12):
2. 下载模型:
3. 运行对比:
输出写入 results/ 目录,量化参数可在 run_qvg.sh 中调整。
常见问题解答
Quant VideoGen 支持哪些视频生成模型?
目前官方集成三个自回归模型:LongCat-Video、Self-Forcing、HY-WorldPlay。 理论上可迁移到 CogVideo、VideoPoet 等同类架构,但需自行适配。非自回归模型(如 Stable Video Diffusion 的一次性多帧生成)不适用。
7 倍压缩是固定值吗?
不是固定值,是上限。 三个模型的实际压缩率分别为 6.89x、6.97x、7.01x,差异源于模型架构和 KV 缓存层数不同。论文未给出动态场景 vs 静态场景的细分数据,建议根据具体用例测试后确定最佳配置。
量化后视频质量会下降吗?
在论文验证的三个基准上,QVG 持续优于现有基线。 但「优于基线」不等于「无损」——2-bit 量化必然引入信息损失,在高动态区域可能出现轻微模糊。论文提到延迟开销 < 4%,质量损失在可接受范围内。
消费级显卡真的能用吗?
可以,但有条件。 团队在 RTX 5090(24GB 显存)上验证通过。对于 12GB 显存的显卡,即使 KV 缓存压缩到 3–4GB,模型权重本身仍可能占用 10GB+,需要配合 4-bit 权重量化才能运行。官方尚未提供 12GB 显卡的验证数据。
QVG 与 LLM 的 KV 缓存压缩有什么区别?
核心区别在于时空冗余分析。 LLM 的 KV 压缩(如 H2O、SnapKV)基于注意力头的稀疏性——某些 token 的 KV 可以被驱逐或压缩。QVG 在此基础上增加了视频帧间的时序冗余分析和语义感知平滑,识别跨帧重复区域,因此压缩率更高(7x vs 2–5x)。
总结
Quant VideoGen 是视频生成领域 KV 缓存压缩的重要突破,2-bit INT2 量化实现 85% 内存缩减,让消费级显卡运行长视频生成成为可能。
对于受显存限制无法部署视频模型的开发者,QVG 是目前最直接的解决方案。无需训练、提供完整复现脚本的特性大幅降低了采用门槛。主要局限在于目前仅支持自回归模型,且与主流推理框架(Diffusers、ComfyUI)的集成尚待社区推进。
 AI 速览