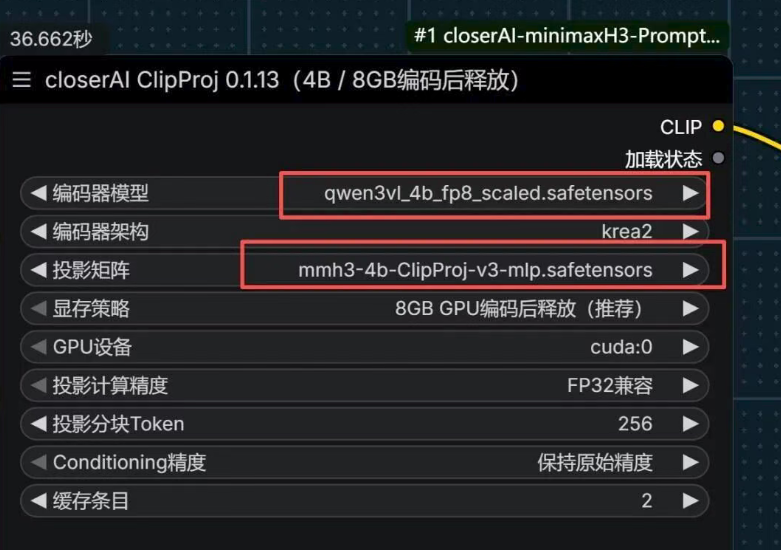
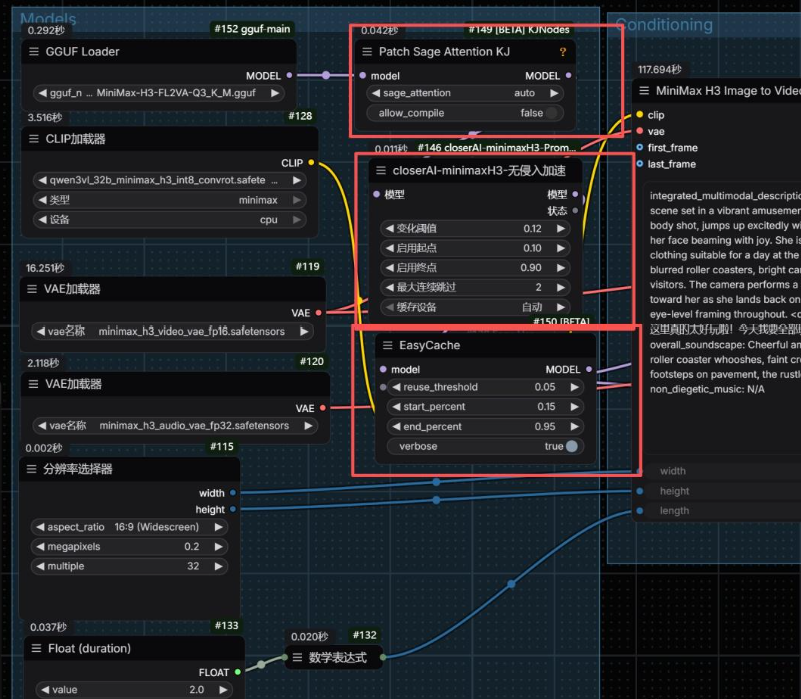
你要是用8GB、12GB显卡跑MiniMax H3,多半被那个动辄15GB多的文本编码器逼疯过——今天说的这个插件ComfyUI-ClipProj,能把这块显存占用从15.7GB压到5GB左右,最狠能压到4.5GB,安装过程亲自跑通了,提示词直接甩你。
先说痛点:H3什么都好,就是吃显存
MiniMax H3火起来这段时间,你在ComfyUI里大概也没少折腾它。出片质量确实顶,视频声音一起生成,社区口碑一片。但只要手里是一块8GB、12GB的显卡,都绕不过一个坎:H3自带的文本编码器,光它一个就要吃掉15.7GB显存。这里先解释两个词,不然下面没法聊。ComfyUI,就是把AI生成过程拼成积木的免费工具,节点是积木块,工作流是拼好的方案,现在玩本地生图生视频基本绕不开它。文本编码器,是视频模型雇的"翻译官",你的提示词是一句话,模型只听得懂数字,翻译官负责把话翻译成模型懂的数字信号。H3这个翻译官是个大牌,Qwen3-VL-32B,翻译得准,但身价高得离谱,15.7GB显存,很多显卡请不起。所以之前的建议一直很简单:想本地跑H3,先攒一块16GB以上的显卡。直到ComfyUI-ClipProj出来,事情才有点不一样。
这个插件干了件什么事
一句话:把大翻译官换成小翻译官,外加一张对照表。参数里的B是十亿,约等于模型的脑容量。原来H3用32B的脑子当翻译官,这个插件换上4B或8B的脑子,再补一张学好的投影矩阵,把小模型翻出来的东西换算成32B的格式。这张矩阵只有几十到几百MB,跟你想象中那种几十GB的"大模型"完全不是一个量级(官方给出的矩阵文件大约53.6MB)。最省心的是,这种换法不用动其他任何东西,生成画面的扩散模型、画面解码、采样器全都原样保留,只把翻译官换掉。实测的几个档位大概是这样:原始32B占15.7GB;换成4B加ClipProj(bf16精度)能到8.3GB;4B加ClipProj(fp8精度)能到5.2GB;4B加ClipProj(int8精度)能压到4.5GB。默认推荐档位大约5GB左右,最省的一档4.5GB,相当于把最占地方那块砍掉三分之二还多。
为什么能这么干?因为4B和32B用的是同一个分词器,也就是同一套"识字系统"。同一个提示词拆出来的字块一模一样,只是脑容量不同,输入对得上就能学出一张对照表。而且这张表不是训练出来的,是拿几千条提示词分别过两个模型算出来的(官方说法是用岭回归拟合,没有梯度下降那套流程),作者把整个测量过程写成文档公开放在项目里,不怕你查。
装上跑了一遍
照着项目说明,把节点装进ComfyUI,矩阵放进指定文件夹,重启,拖进它自带的示例工作流跑起来。最直观的差别在加载那一瞬间——之前32B翻译官一载入,显存蹭地涨满,风扇直接起飞;换完之后,编码阶段占用一直晃在5GB上下,电脑还能顺手干点别的。出片质量方面重点跑了常见玩法,简单提示词、结构化多镜头提示词,都能正常出片,不是说和32B一点差距都没有,但用这点差距换10GB显存,这笔账挺划算。对小显存玩家来说,这是目前最实在的一条路。有一说一,作者自己标了这是proof of concept,翻译过来就是"实验品",能用、效果不错,但别当官方插件供着。更新也勤,装的时候认准节点0.1.4以上版本。
复制这段提示词,让AI帮你装
帮我给本机的ComfyUI安装ComfyUI-ClipProj节点,目的是给MiniMax H3换一个更省显存的文本编码器。请按顺序完成:第一,找到本机ComfyUI安装目录下的custom_nodes文件夹;第二,把GitHub上的项目克隆进去,地址是github.com/nicolab28/ComfyUI-ClipProj;第三,重启ComfyUI;第四,去Hugging Face下载投影矩阵文件,地址是huggingface.co/NicoLab28/ClipProj-MiniMax-H3,显卡显存不足16GB的话请下载4B版本mmh3-4b-ClipProj-celeb-mlp.safetensors,显存在24GB以上请下载8B版本mmh3-8b-ClipProj-celeb-mlp.safetensors;第五,把下载好的文件放进ComfyUI/models/clip_projections/文件夹;第六,再次重启ComfyUI,把项目examples目录里的minimax_h3_clipproj.json工作流拖进画布,确认ClipProj节点能识别到矩阵文件;第七,每完成一步都告诉我结果,遇到报错就停下来,把报错原文发我,并给我下一步建议。
项目地址记一下,动手前可以自己看一眼:插件仓库github.com/nicolab28/ComfyUI-ClipProj,投影矩阵huggingface.co/NicoLab28/ClipProj-MiniMax-H3。两个挑选小建议:8GB、12GB显卡选4B版;24GB以上选8B版,质量更接近原版。如果连5GB都嫌多,还有更省的int8那一档,代价是启动会慢一点。
本地跑H3的门槛,被一张几十MB的矩阵撬开了一道口。省下的10GB显存,换回的是本地跑H3的可能,对8GB、12GB显卡的玩家来说,今晚就能试试这笔买卖划不划算。
 AI 速览