当前大模型在代码、数学等标准化基准评测中分数持续走高,但在真实职场、生活场景的全流程任务完成率却远低于预期。标准化跑分与实际工作能力的脱节,已成为 AI Agent 落地的核心痛点。本文结合电商、互联网产品、生活服务三大领域的专业真实评测集,拆解当前 Agent 的实际表现、核心短板与行业优化方向。
一、标准化评测与真实工作脱节 场景化评测成稀缺品
目前行业主流的大模型榜单,如 LiveBench、DeepSWE 等,大多聚焦单维度能力测试,可直观反映模型的代码、推理、数学水平,但无法匹配真实工作的复杂属性。
真实工作任务往往具备三大特征:信息零散分布在多份文档、邮件中,存在干扰项与错误信息;需要跨多个工具、多步骤连续执行,任一环节出错即全盘失败;没有标准化题干与答案,需结合业务规则自主判断。
这类贴近实际工作的垂直评测集数量极少,且更新迭代远滞后于模型发布速度,用户很难通过现有榜单判断模型在自身岗位的真实可用性。
二、电商场景实测:头部模型刚及格 半数任务完全失败
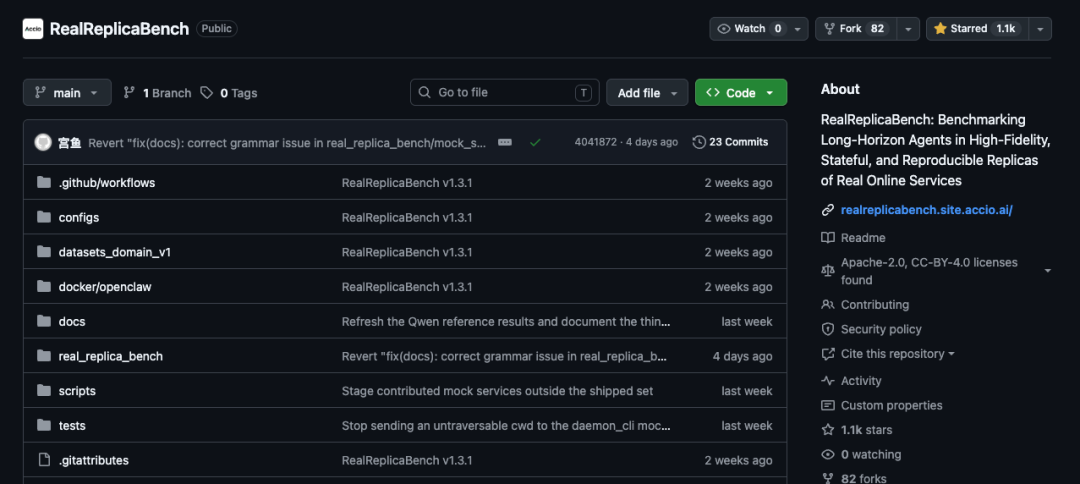
阿里国际站 Accio 团队推出的RealReplicaBench,是目前最具代表性的真实工作评测集之一。
团队从 160 万条真实电商工作对话中提炼 20 万条工作流,最终筛选出 107 个可复现、可判定的全流程任务,覆盖商品上架、物流规划、售后争议处理、跨平台对账等核心电商场景。
评测采用严苛的零容错规则:所有操作步骤、输出结果全部正确才算得分,任一环节出错即 0 分,完全贴合商业场景的真实要求。实测结果显示,当前顶级模型的表现并不理想:
- Claude Opus 5 以 60.75% 的通过率排名第一,刚好触及及格线;
- Qwen 3.8 Max 与 DeepSeek V4 Pro 并列第三,通过率仅 49.53%,超半数任务完全失败。 以采购经理邮件处理任务为例,模型需从 300 封零散邮件中拼凑项目需求、从 20 家供应商中筛选出合规且成本最低的选项、识别钓鱼诈骗邮件、生成回复草稿与会议安排,全程信息碎片化、干扰项多,对信息整合与多步执行能力要求极高。
三、多领域验证:生活办公场景表现更差 稳定性成普遍短板
不止电商赛道,其他领域的真实任务评测同样暴露了 Agent 的能力短板。
腾讯联合高校推出的E-Bench,覆盖王者荣耀、QQ 音乐、腾讯会议共 323 个 APP 操作任务。测试显示,Kimi K3 的平均通过率为 73.79%,但同一任务三次独立运行全部成功的稳定率仅 58.82%,单次跑通不代表可稳定复用。 小红书推出的生活类评测VibeLifeBench,包含 200 个长周期生活任务,覆盖求职、租房、健身、差旅等 10 个领域,表现最好的 Claude Opus 5 平均通过率仅 32.5%。 对比代码领域 70% 以上的任务通过率可以发现:标准化程度越高的场景,模型表现越好;流程越灵活、信息越零散的非标准化场景,Agent 的能力落差越大。
四、行业启示:从 “会解题” 到 “会工作” 需全链路协同
造成真实场景与基准评测巨大差距的核心原因,在于真实工作不存在 “标准题干”:信息零散、规则模糊、干扰众多、结果零容错。
单一提升模型推理能力不足以完全解决问题,垂直领域的专属 Agent 框架、行业知识沉淀、工具链路优化,都能显著提升任务成功率 —— 例如搭配电商专用 Accio 框架后,通过率突破 50% 的模型数量从 2 个增加到 6 个。
目前行业正逐步完善真实场景评测体系,后续更多垂直领域的实测数据将纳入主流榜单,帮助用户匹配适配自身工作的模型。整体而言,大模型 “会解题” 不代表 “会工作”,Agent 的规模化商业化落地,仍需模型厂商、垂直服务商与行业客户共同推进,在真实业务中持续迭代优化。
 AI 速览