Cursor 在 4 月 30 日发布了一篇 11 分钟长读,首次系统披露其 agent harness 的持续优化方法论——从 context window 演化、Keep Rate 评估、tool call 错误分类,到针对不同模型定制 harness、mid-chat 切换的代价处理。这篇文章是 coding agent 工程实践里少见的"内部档案级"披露,对所有自建 Agent 系统的团队都有直接参考价值。本文按 Cursor 给出的六个核心环节做拆解,并对照其他主流 coding agent 的处理方式给出对比。
Context window 演化:从堆静态上下文到让 agent 自己拉
Cursor 在 2024 年底做第一版 coding agent 时,模型选择上下文的能力还很弱,工程团队只能靠堆护栏:每次 edit 之后主动 surface lint 和类型错误、当 agent 请求的文件读取行数过少时改写、单轮内限制 tool call 次数,并在每个会话开始时塞入 codebase 的 folder layout、语义匹配的代码片段、用户附加文件的压缩版本。
这些"灌喂式"做法现在大部分已经退场。
当前的 harness 仅保留少量必要静态上下文:操作系统、git status、当前文件、最近查看的文件;其余全部交给 dynamic context——由 agent 在工作过程中按需拉取。这一转变的前提是模型自身的 context selection 能力到达了某个临界值,Cursor 的判断是"知道边界在哪儿,然后果断拆掉护栏"。
横向对比:Claude Code、Aider 这类工具同样走 dynamic context 路线,但 Cursor 比它们更激进的地方在于,它把"拉取动作"本身做成了一类工具,允许 agent 在跑动中召出过往对话、活跃终端会话、相关工具——而不是等到某个固定节点才注入。 两种评估方法:CursorBench + 在线 A/B 实验,看 Keep Rate 和满意度
公开 benchmark 加上自家 eval 套件 CursorBench,只解决"快速、标准化"的问题。Cursor 明确指出 benchmark 只是真实使用的近似,完全依赖会丢掉关键信号。
真正决定迭代方向的是在线 A/B 实验,把两个或多个 harness 变体并排部署到真实流量上对比。指标分两层:
直接指标(directionally useful):延迟、token 效率、tool call 数量、cache hit rate。这些容易测,但回答不了"agent 到底有没有把活做好"。
质量指标(这是 Cursor 这次披露里最值得借鉴的部分):
- Keep Rate:agent 提议的代码改动,在固定时间间隔后仍留在用户 codebase 里的比例。Keep Rate 低意味着用户做了大量手工修正、或者反复迭代让 agent 来修——都是初次输出质量差的信号。
- LLM 语义满意度判定:用一个语言模型去读用户对 agent 初次输出的后续回复。如果用户直接进入下一个 feature,大概率满意;如果用户粘贴一段 stack trace,大概率没满意。
这种"用 LLM 判 LLM"的方法把"用户体验"变成了一个可大规模评估的量化指标。Cursor 也分享了一个反向案例:他们曾尝试用更贵的模型做 context summarization,在线实验显示对 agent 质量的提升微乎其微,直接砍掉。
错误分类系统:把未知 tool call 错误一次冲刺降低一个数量级
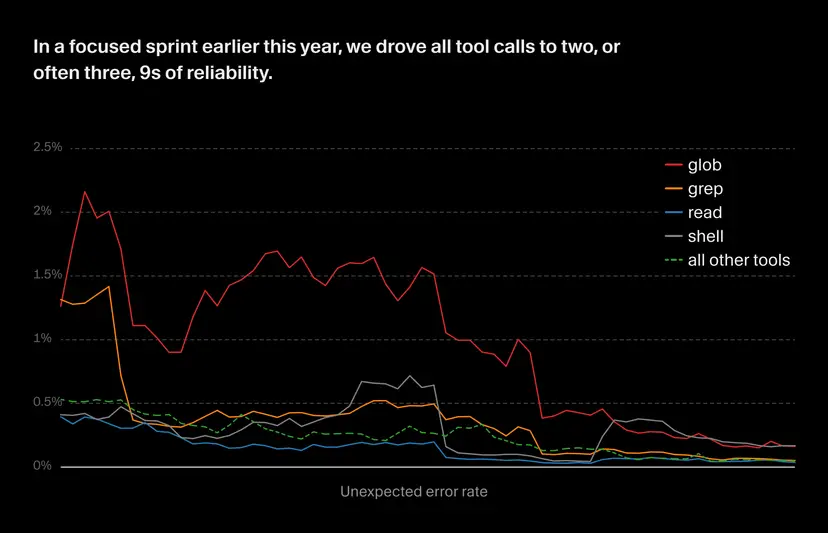
Tool call 出错是 agent harness 最大的故障面之一。即使 agent 能 self-correct,错误也会留在 context 里,造成 Cursor 称之为 context rot 的累积污染——后续决策质量会随之退化。极端情况下,agent 会被一次失败的 tool call 直接卡死或带偏。
Cursor 的处理方式是把错误分桶,只对真正异常的部分告警:
InvalidArguments / UnexpectedEnvironment:模型自身错误或 context 矛盾
ProviderError:外部依赖不可用(如 GenerateImage、WebSearch)
UserAborted / Timeout:用户主动取消或超时
这些是"预期错误",阈值设宽。任何未知错误一律视为 bug,触发硬告警。
光靠分类还不够,还需要异常检测:每个 tool、每个模型分别计算错误基线,因为不同模型搞错 tool call 的概率分布不一样。当某项预期错误显著超过基线时再触发告警。
最关键的是后续修复链路。Cursor 跑了一个每周 Automation,带一个 skill 让模型自己翻日志、把新出现或激增的问题登记成工单,再用 Cloud Agents 批量发起修复——可以直接从 Linear 触发。一次专项冲刺过后,Cursor 把所有 tool call 推到了"至少 2 个 9、多数 3 个 9"的可靠性,未知错误率降低了一个数量级。
这是一个把 agent 系统当作大规模分布式系统来运维的样板,而不是当作 demo。
针对每个模型定制 harness:OpenAI 用 patch、Anthropic 用 string replacement
Cursor 披露的另一个细节,是不同 AI 实验室训练数据带来的"工具偏好":
- OpenAI 模型训练时用的是 patch-based 编辑格式,instruction following 更字面、更精确;
- Anthropic 模型训练时用 string replacement,直觉性更强,对不精确的指令更宽容。
任何一个模型理论上都能用任何一种工具,但给错工具会让模型多花 reasoning tokens、出更多错。所以 Cursor 在 harness 里给每个模型配上它训练时见过的工具格式。这种定制深入到 prompt 层级——不仅按 provider 分,还按 model version 分。
拿到新模型的早期访问权限时,Cursor 会从"最接近的现有 harness"作为起点开始迭代:跑离线 evals 找模型困惑的点、让团队成员实际使用反馈问题、调 harness、再跑。直到 model-harness 组合达到可发布水平为止。
这次披露里有个被命名的模型缺陷叫 context anxiety:某个模型在 context window 快填满时会开始拒绝工作,用"任务太大了"来 hedge。Cursor 通过 prompt 调整把这个行为压下去了。这是一个公开记录的、可被其他 agent 团队参考的"模型怪癖处理"案例。
横向对比:Aider 也做不同模型的 prompt 适配,但深度远不及 Cursor;Claude Code 是 Anthropic 自家产品,只需要为一个模型家族优化。Cursor 在"覆盖所有 frontier 模型"这一战场上的工程量级,几乎是独此一家。 Mid-chat 模型切换:cache miss + out-of-distribution 双重代价
支持用户在对话中途切换模型,看起来是个产品功能,实际是 harness 上最难的工程之一:
- 切换后 harness 自动换成新模型对应的 prompts 和 tools;
- 但模型仍要对一段由另一个模型生成的对话历史做出反应——这段历史对它来说是 out-of-distribution。
Cursor 的处理方式有三层:
- 加 custom instructions 明确告诉模型"你是中途接手的",并引导它别去调历史里出现过但不在自己工具集里的 tool;
- Cache 是 provider/model 特定的,切换必然 cache miss——首轮更慢更贵。Cursor 在切换时对对话做一次 summary 来缓解 cache 惩罚,但深度复杂任务下 summary 会丢细节;
- 官方建议:单次对话尽量不切换模型,除非有明确理由。
如果确实要换,推荐方式不是切换,而是用 subagent——直接起一个 fresh context window,Cursor 最近也加了让用户指定模型跑 subagent 的能力。这是把"模型切换"问题转化为"任务派发"问题的工程妙手。
Coding agent 的下一步:多 agent orchestration 是 harness 战场
Cursor 在文末给出了清晰的方向判断:AI 辅助软件工程的未来是多 agent。一个负责 planning、一个负责 fast edits、一个负责 debugging,每个 agent 只做最擅长的事。
让多 agent 协作产生价值的,不是任何单个 agent,而是 harness——它要决定 dispatch 给谁、如何为目标 agent 重新 frame 任务、如何把多 agent 输出 stitch 成连贯工作流。Orchestration 能力住在 harness 里,这一判断会重新定义 coding agent 的工程重心。
这与 Cursor 之前披露的 long-running agents 研究、self-driving codebases 实验、SDK 开放是同一条线索:把 harness 从"幕后基础设施"逐步抬到"产品核心"。
对自建 agent 团队的可借鉴点
把 Cursor 这次披露压成可执行清单:
- 指标层:除了 latency、token 效率,加 Keep Rate 和"用 LLM 判用户满意度"两条质量指标——后者特别值得自建团队抄作业。
- 错误层:对 tool call 错误分类、用未知错误触发硬告警、用基线偏离触发软告警,基线按 tool×model 切分。
- 运维层:让 agent 帮你运维 agent——每周 Automation 翻日志、自动建工单、Cloud Agents 批量修。
- 模型适配层:不要只做一份 prompt 给所有模型,工具格式按训练数据偏好分配,prompt 按模型版本分。
- 切换层:能不切换就不切换,要切换就上 summary,更优解是直接起 subagent。
- 未来层:把 orchestration 当作下一个产品核心,而不是当作 prompt 编排小工程。
这篇文章的真正价值不在某个具体技巧,而在于 Cursor 把"agent 工程"和"传统软件工程"的边界重新画清楚了:harness 是软件,需要 SLO、需要告警、需要事后复盘、需要 A/B 实验、需要自动化运维。把 agent 当 demo 做,会一直停在 demo;把 agent 当软件做,才有持续优化的空间。这是 Cursor 这次披露最值得带走的一句话。
 AI 速览