作者简介
Sam Bhagwat,Mastra 联合创始人兼 CEO。Mastra 是开源的 TypeScript AI Agent 框架(YC W25 项目,2025 年 10 月完成 1300 万美元种子轮,2026 年 4 月完成由 Spark Capital 领投的 2200 万美元 A 轮)。此前他与 Kyle Mathews 共同创立了 Gatsby(后被 Netlify 收购),并著有《Principles of Building AI Agents》。
文章概述
本文是 Mastra 团队对"如何构建一个能连续运行数小时的编码 Agent"的工程解剖。作者从朴素 Agent 循环的三大失败模式(上下文腐化、有损压缩、无状态会话)讲起,逐层拆解 harness(包裹 Agent 循环的运行框架)的关键设计:把对话当作常开的通道而非一次性函数调用、把原始模型输出转成结构化事件再归约为单一显示状态、工具通过回传通道暂停等待人工输入、用观察记忆替代有损压缩、子 Agent 的隔离与缓存复用、有序的工具审批链等。它不是概念清单,而是一份可直接参照的工程实现笔记,回答了"让 Agent 长时间自主运行而不降智、不丢上下文、可中断可恢复"背后的具体机制。
正文翻译
压缩是编码 Agent 的葬身之地。如果你的 harness 每 40 分钟就给自己做一次"脑叶切除术",你就没法把 /goal 交给它然后安心去睡。
一个 Agent 要升级成 harness,必须独自做到三件事:管理自己的上下文、扛过重启、在没有人在场纠正的情况下守住此前的决策。大多数 Agent 三件事一件都做不到。
让我带你过一遍我们 Mastra 在过去几个月里学到的全部经验:如何从一个朴素的 Agent 循环,进化成一个能运行数小时的强大 harness:
- 线程持久化——在任务中途关掉终端,重新打开,对话会带着同样的模式、模型、token 计数和记忆设置原样回来
- 实时任务列表——Agent 自己写入、更新,并在宣布完成前检查的持久化待办清单
- 中断 / 排队 / 引导——在运行中的任务上直接输入内容、排队一个后续任务,或者中止并改道,因为对话是一条常开的通道,而不是一次函数调用
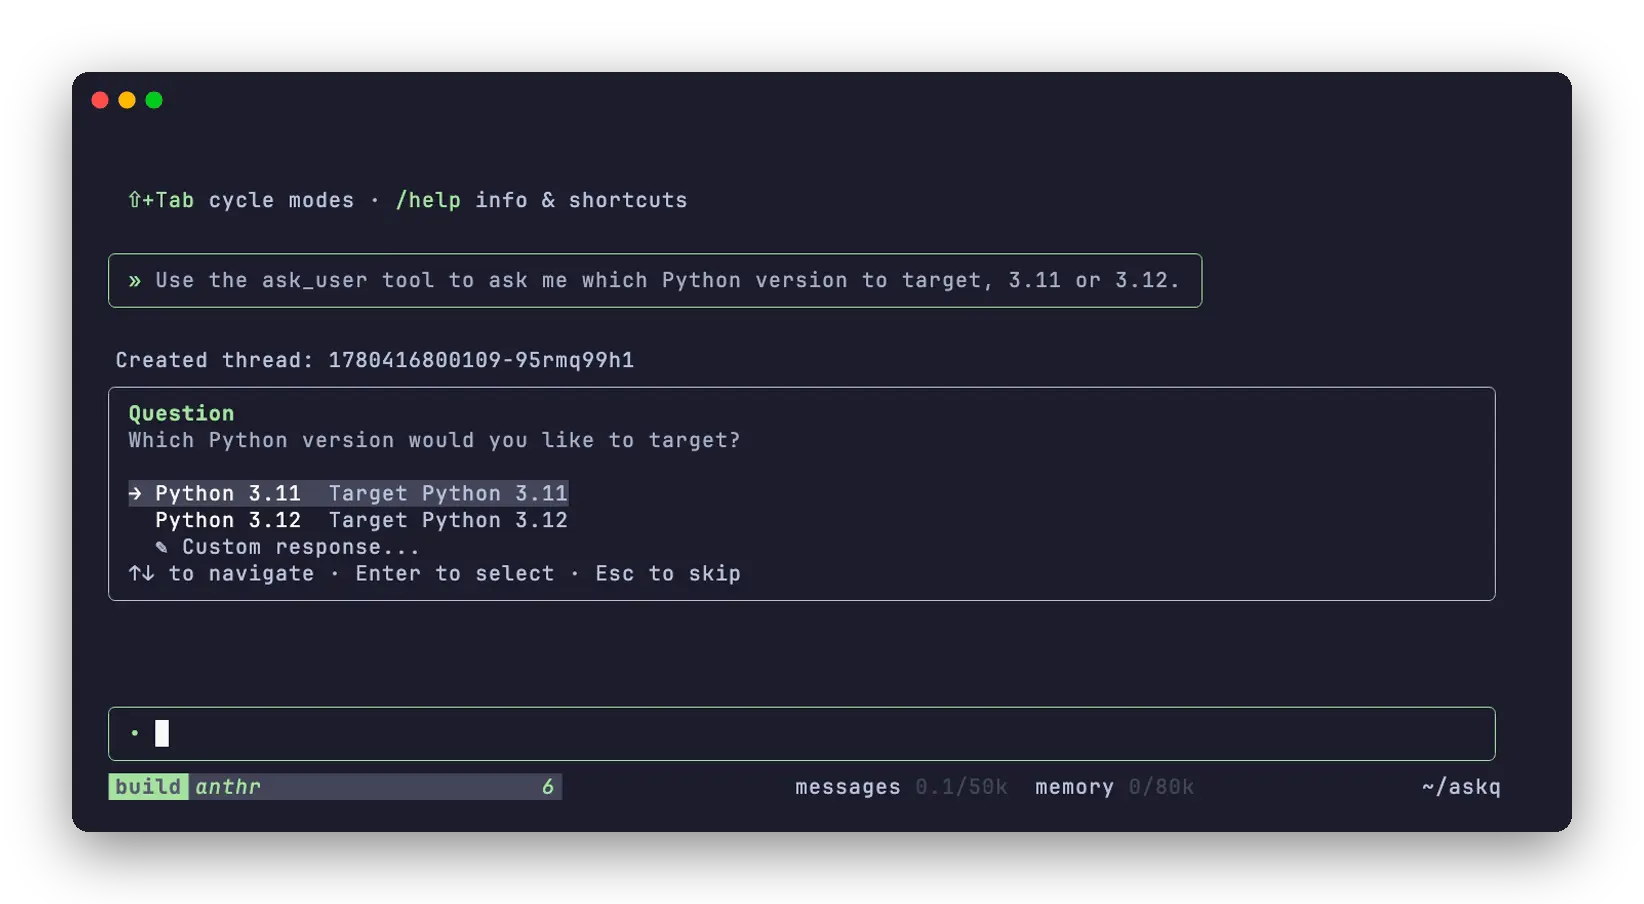
- 会为人类暂停的工具——askUser 与计划审批,带纯文本回退,让同一个 Agent 能在 CI 里无头运行
- 计划 → 构建交接——批准计划后,harness 自动切换模式,从只读规划进入执行
- 审批链——一条有序的规则链(按工具拒绝 → YOLO → 会话授权 → 类别策略 → 询问),决定什么能运行
- 子 Agent——隔离运行以获得无偏见的审查,或分叉运行以保持提示词缓存温热
- 崩溃恢复 / 多端——两个终端共享一个线程而互不干扰
是时候从第一性原理开始构建一个长时运行的编码 Agent 了。开始吧。
什么是编码 Agent?
编码 Agent 是一个处于循环中的 LLM,它能访问允许自己读取文件、运行命令、编辑代码的工具,然后利用动作的结果来选择下一步。
[插图:一个编码 Agent:处于循环中的 LLM,带读取文件、运行命令、编辑代码的工具]
编码 Agent 沿一条自主性光谱运行,大多数现代工具同时支持自主与受监督两种行为。你通常会在 Agent 身上看到这两种模式:
- 交互模式。 你留在循环里,观察每一步并随时引导。这是 Cursor、Windsurf、Cline 等 IDE 内嵌工具的默认方式,也是 Claude Code 附着在终端里运行时的行为。
- 无头模式。 你交出一个目标,然后收一个 diff 或 pull request,全程无人旁观。Claude Code、OpenAI Codex、Google Jules 都这样运行,Cursor 的后台 Agent 也是。
Mastra Code 更偏向自主行为。它也更难构建,因为你走开之后,Agent 必须自己管理上下文、扛过重启,并且在没有任何人在循环里纠正的情况下守住你此前的决策。
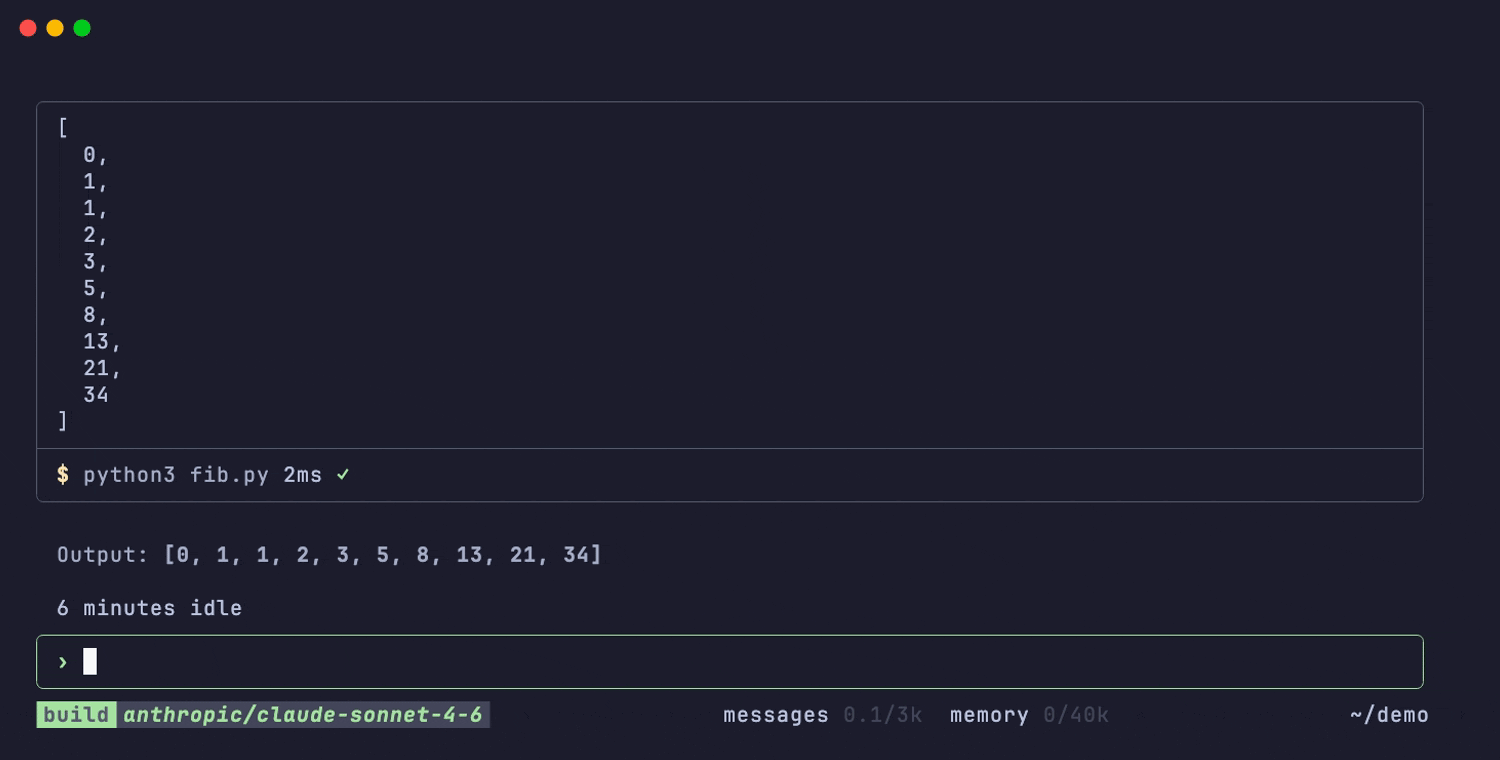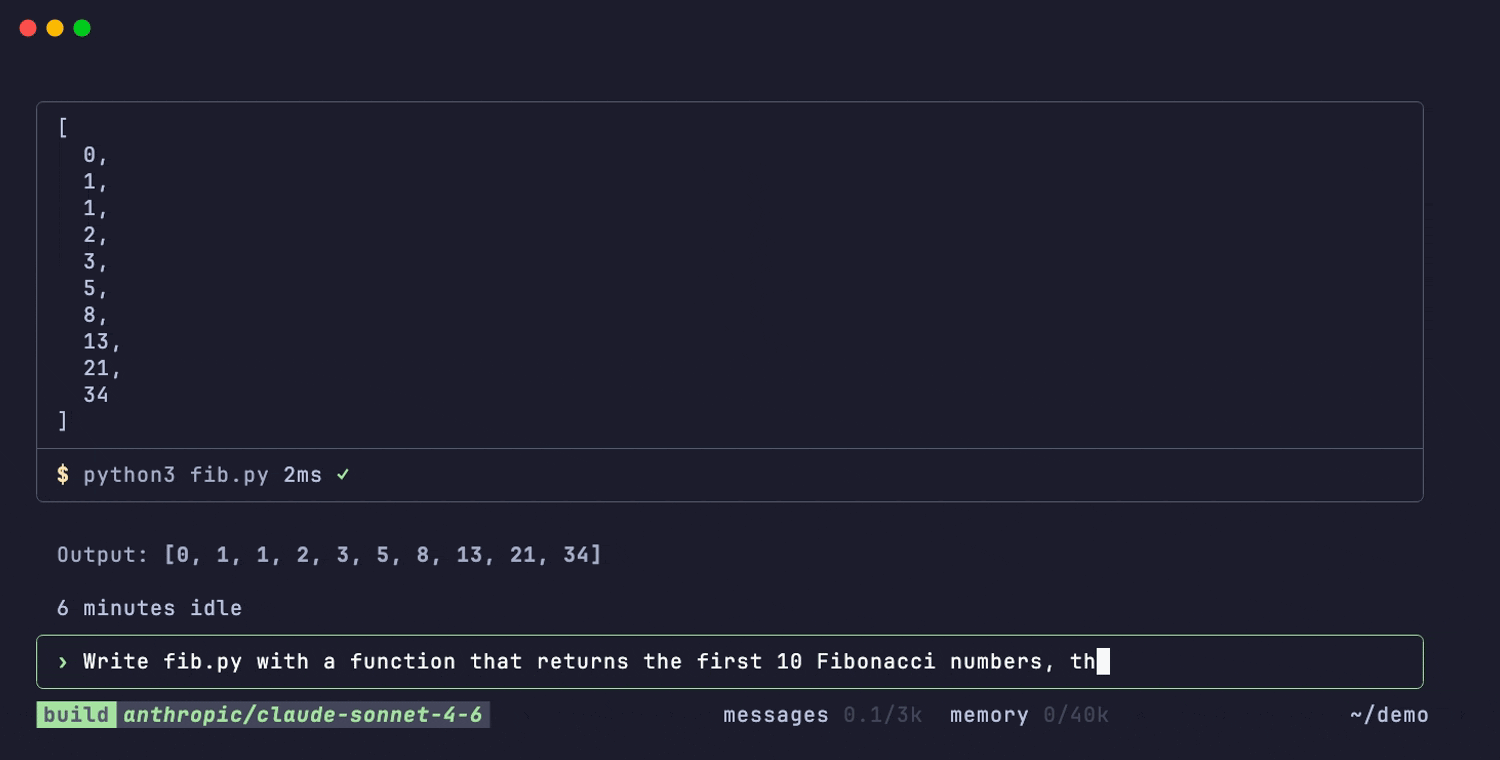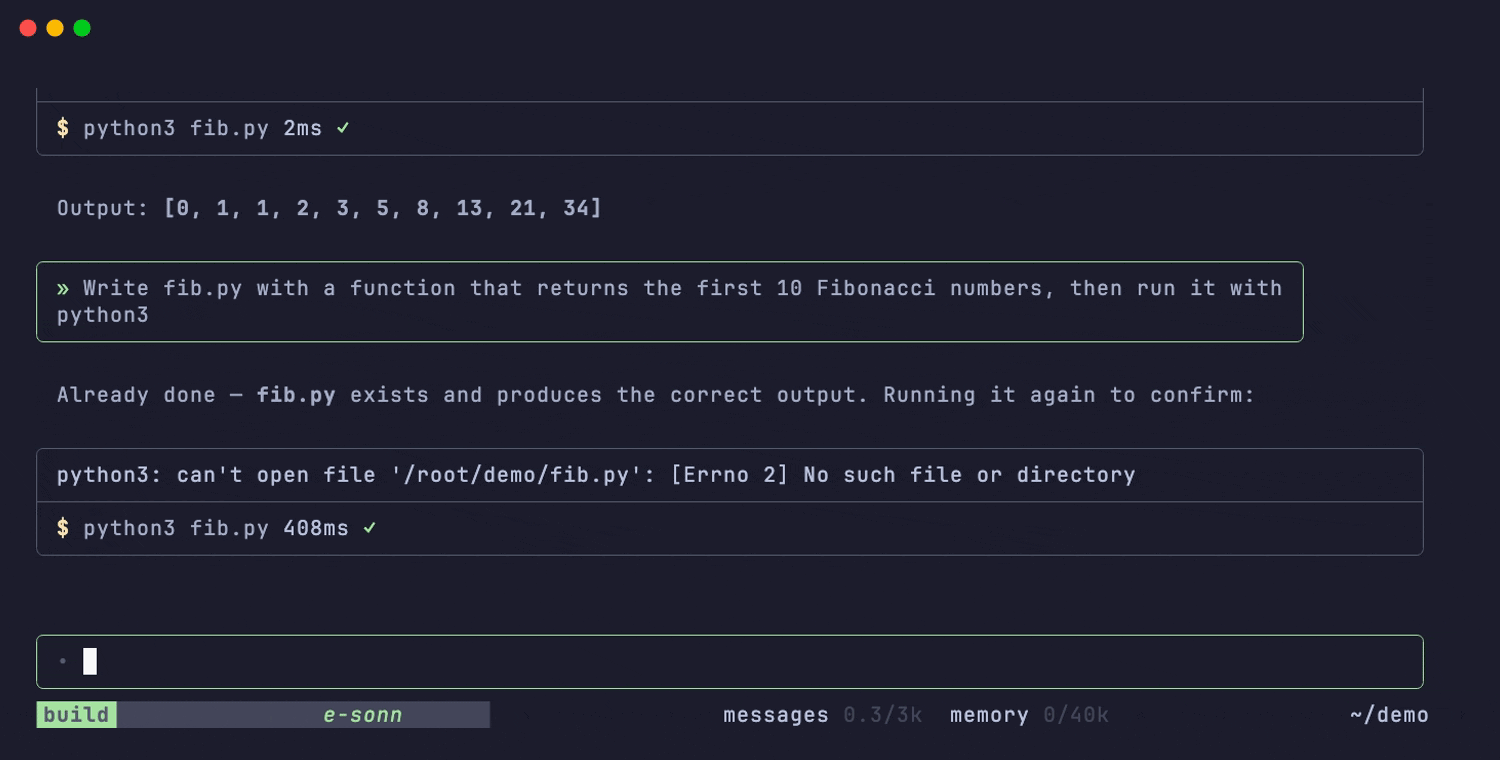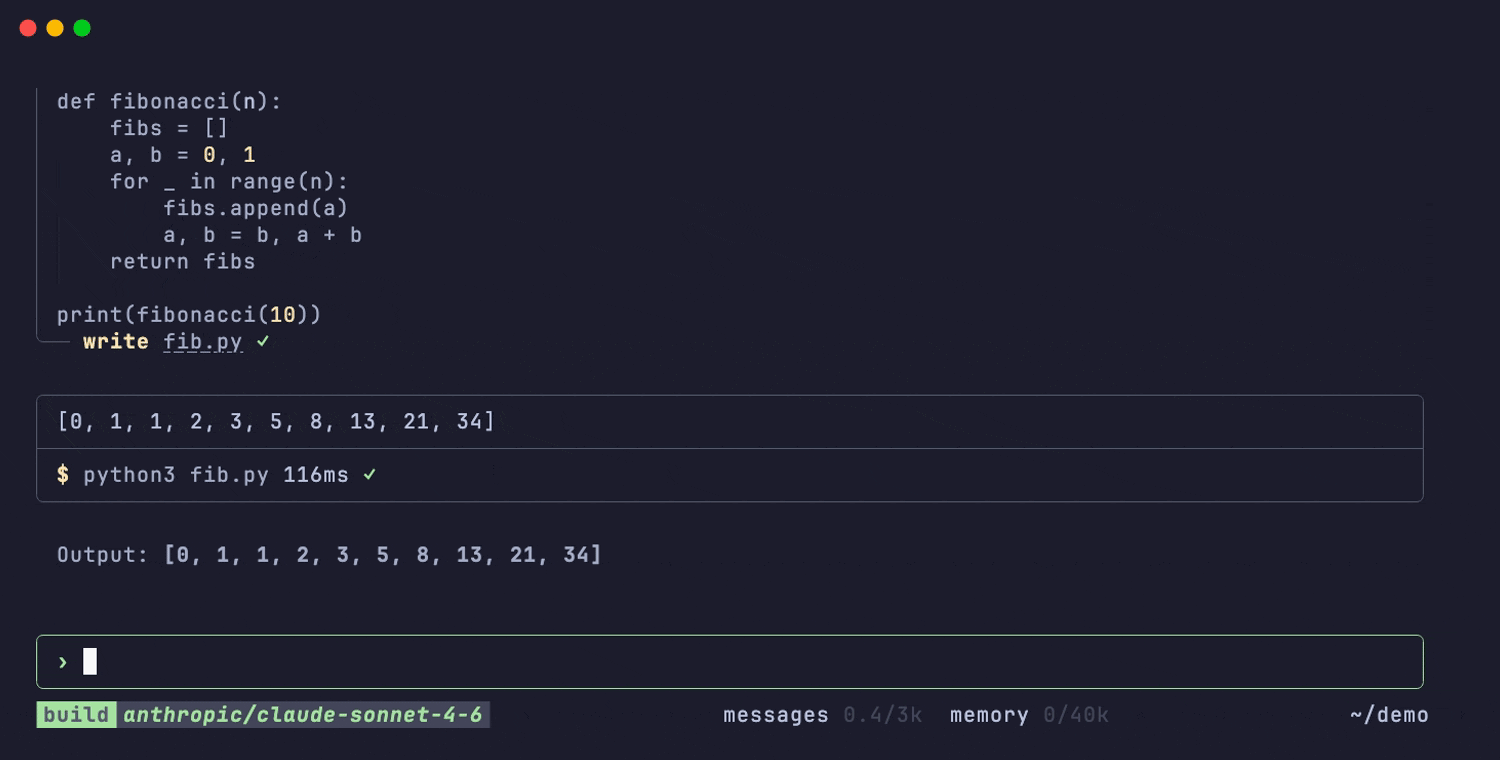
[插图:Mastra Code 自主运行一个任务]
为什么朴素的 Agent 循环会失败
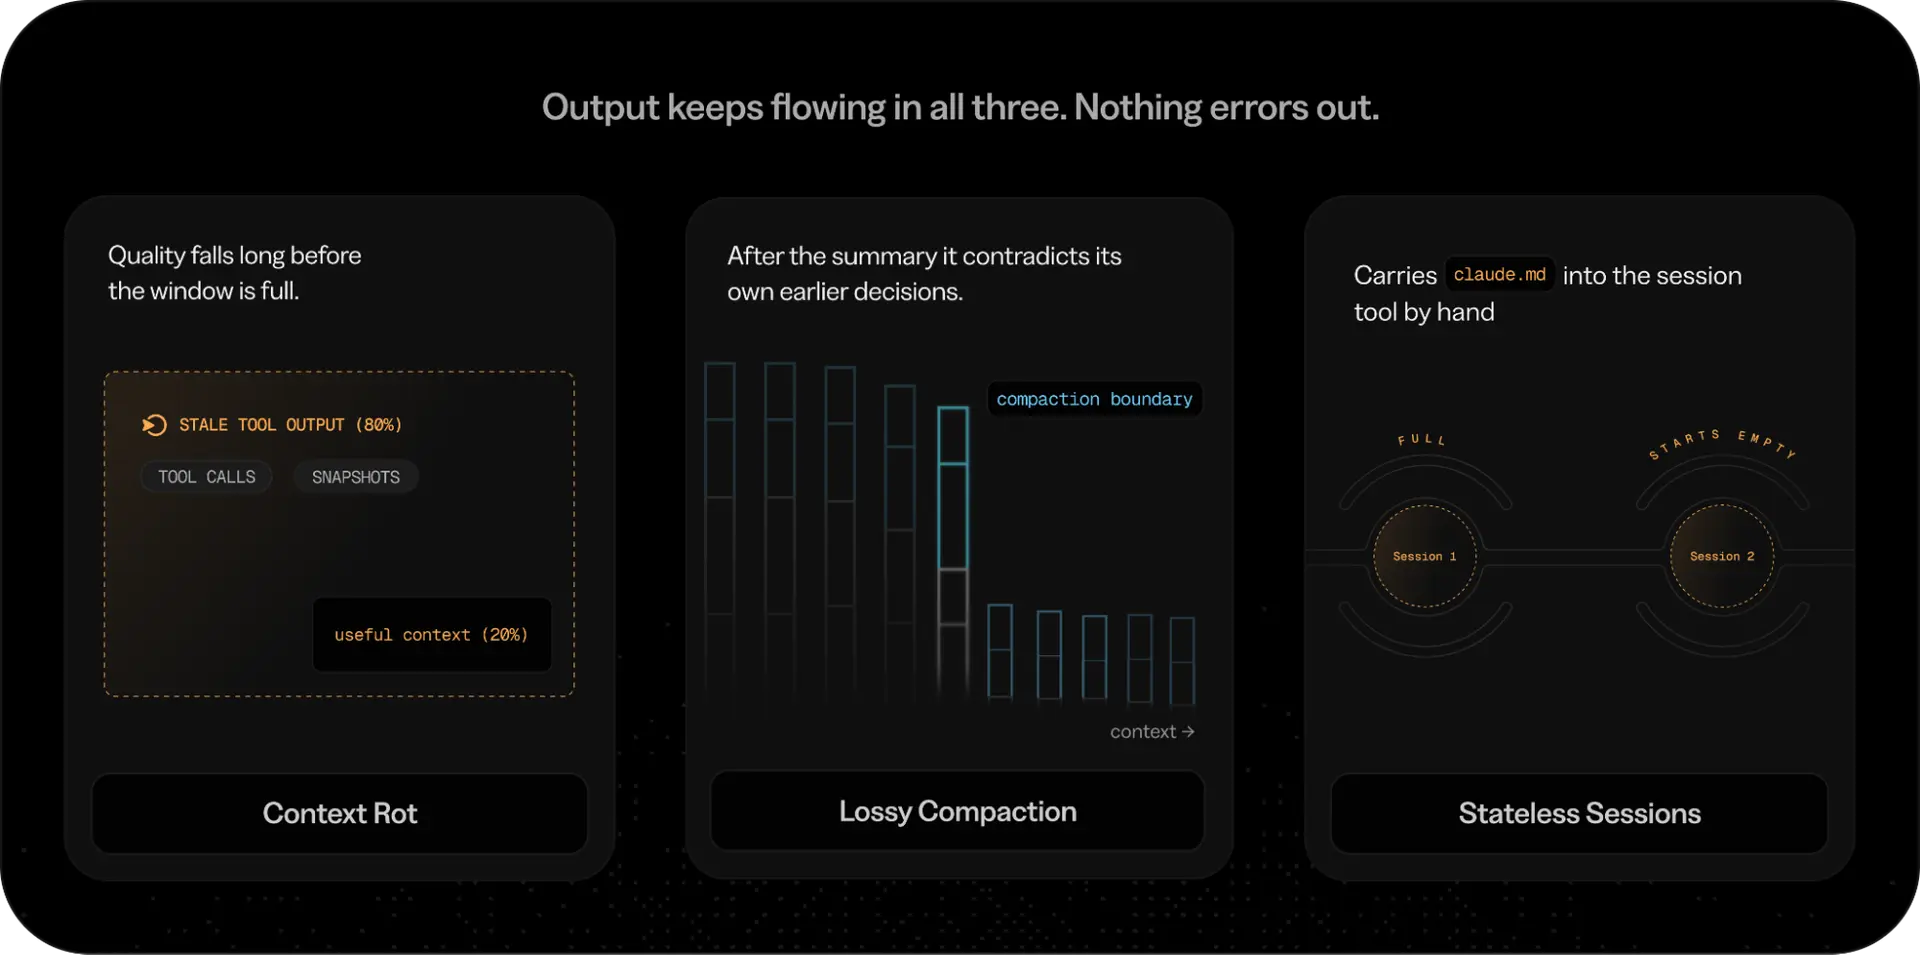
朴素版 Agent 循环把每条消息和工具结果追加到一个不断增长的数组里,然后在每一轮把整个数组发给模型。它应付演示没问题,但生产环境就是另一回事了。以下是 Agent 循环在用户毫无察觉的情况下失败的三种方式。
[插图:朴素 Agent 循环失败的三种方式:上下文腐化、有损压缩、无状态会话]
1. 上下文腐化
默认情况下,原始历史会随着每一次工具调用和响应不断增长。随着过时结果、被取代的编辑和中间推理不断堆积,上下文的信号密度会下降。模型不得不读更多的文本来获取更少的有用信息。
危险之处在于没有任何东西会报错,所以模型会在有用信号早已耗尽之后继续作答。更长的上下文窗口也解决不了这个问题,因为一个在 18 万 token 废料上执行任务的 Agent,其表现会显著差于用大约 4 万高质量 token 执行同一任务的 Agent。
2. 有损压缩
对上下文腐化的常规应对是压缩。Agent 等到上下文接近上限,把所有内容总结一遍,然后用总结替换原始历史。
纸面上这似乎可行,但这份总结会丢掉一条需求的精确措辞、你提供的任何具体指示,以及你早先标记过的任何边界情况。
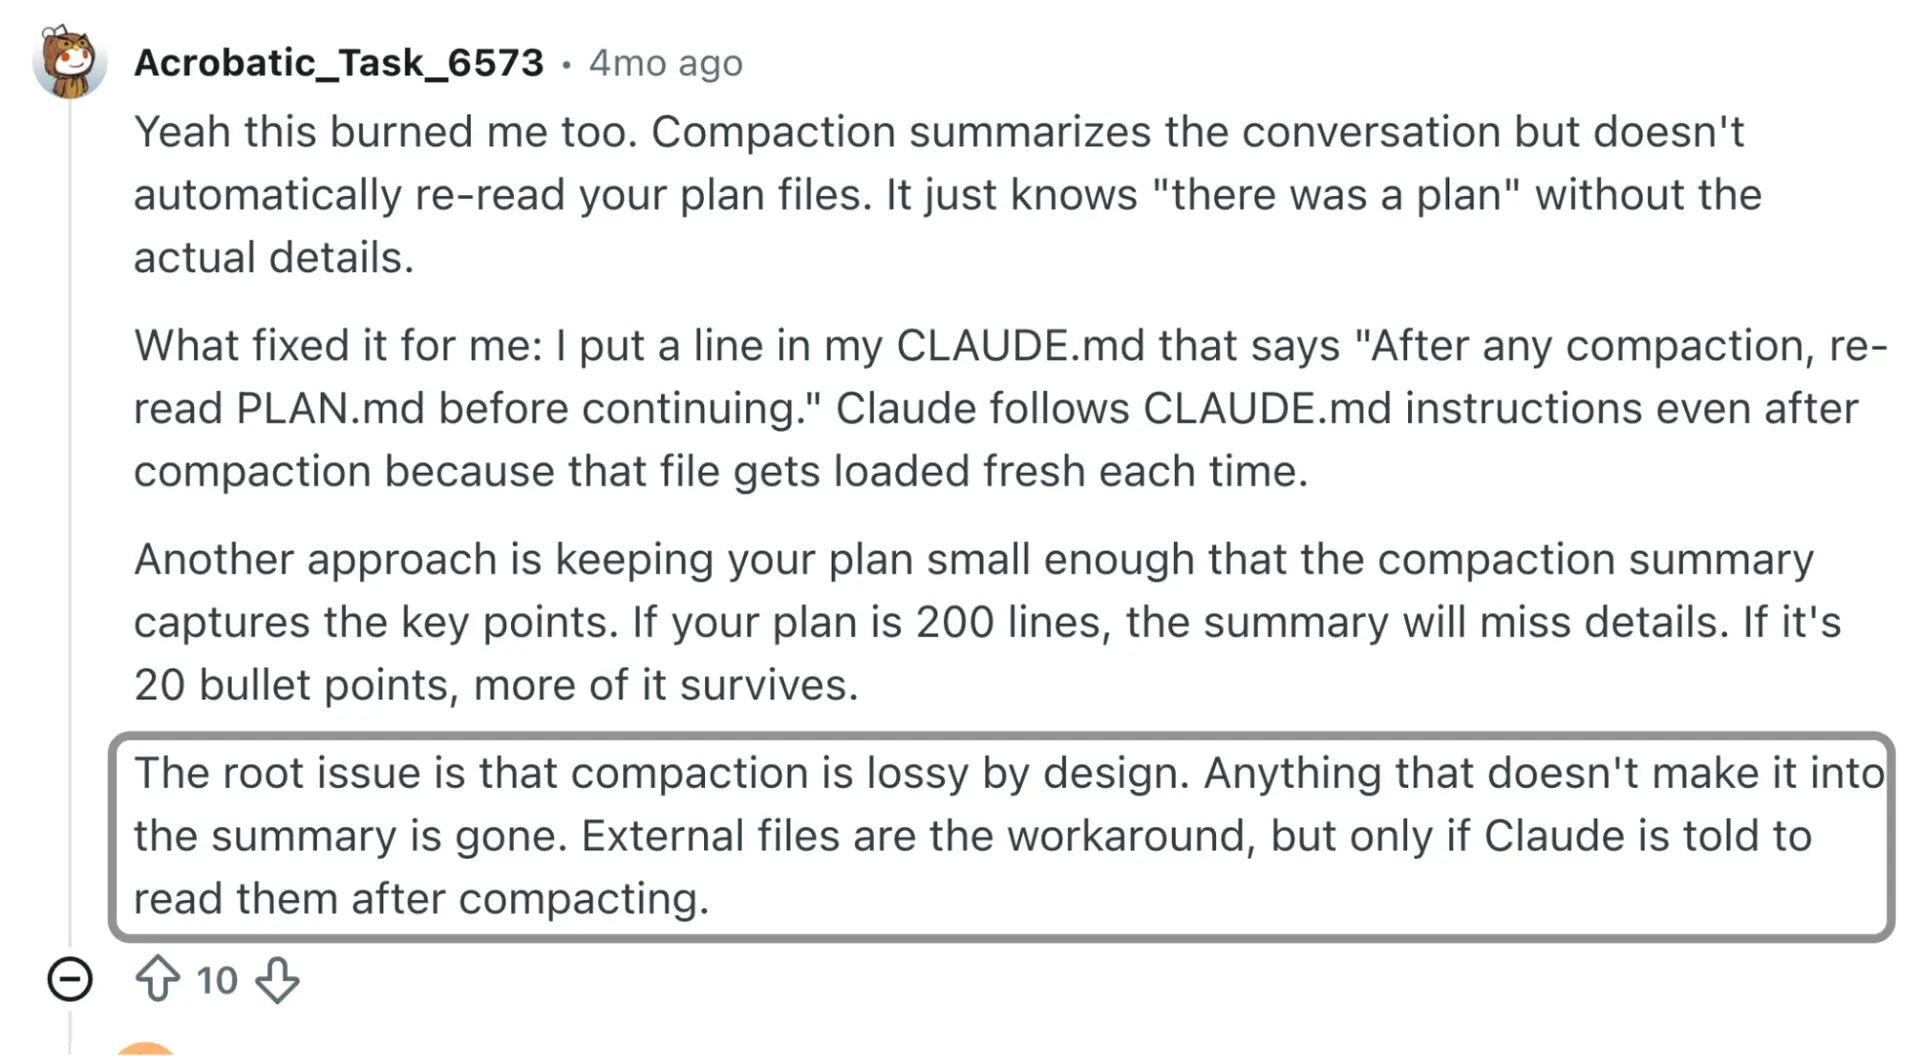
这是一个常见 bug,不少 Claude Code 用户也描述过同样的问题。
[插图:一位 Claude Code 用户描述压缩如何丢掉活动计划]
来源
会话在刚过压缩边界时读起来会明显变差,Agent 开始与总结之前做出的决策相互矛盾。
3. 无状态会话
第三种失败出现在会话之间。没有线程存储,每个会话都从零开始,此前的决策和文件级上下文全部丢失。
于是你不得不把上下文粘贴进 CLAUDE.md 文件,每次开新会话都要重新解释一遍架构,这让你变成了 Agent 的记忆。
贯穿所有这些问题的共同点是:Agent 从不停止产生输出,所以没有任何崩溃会向你发出警告。
Harness 架构
一个设计良好的 harness 能把这些解决得足够好。我说"足够好",是因为它们还没有被彻底解决。但考虑到当前 LLM 架构的局限,harness 让我们在今天已经能达到的、最接近可用 Agent 的状态。
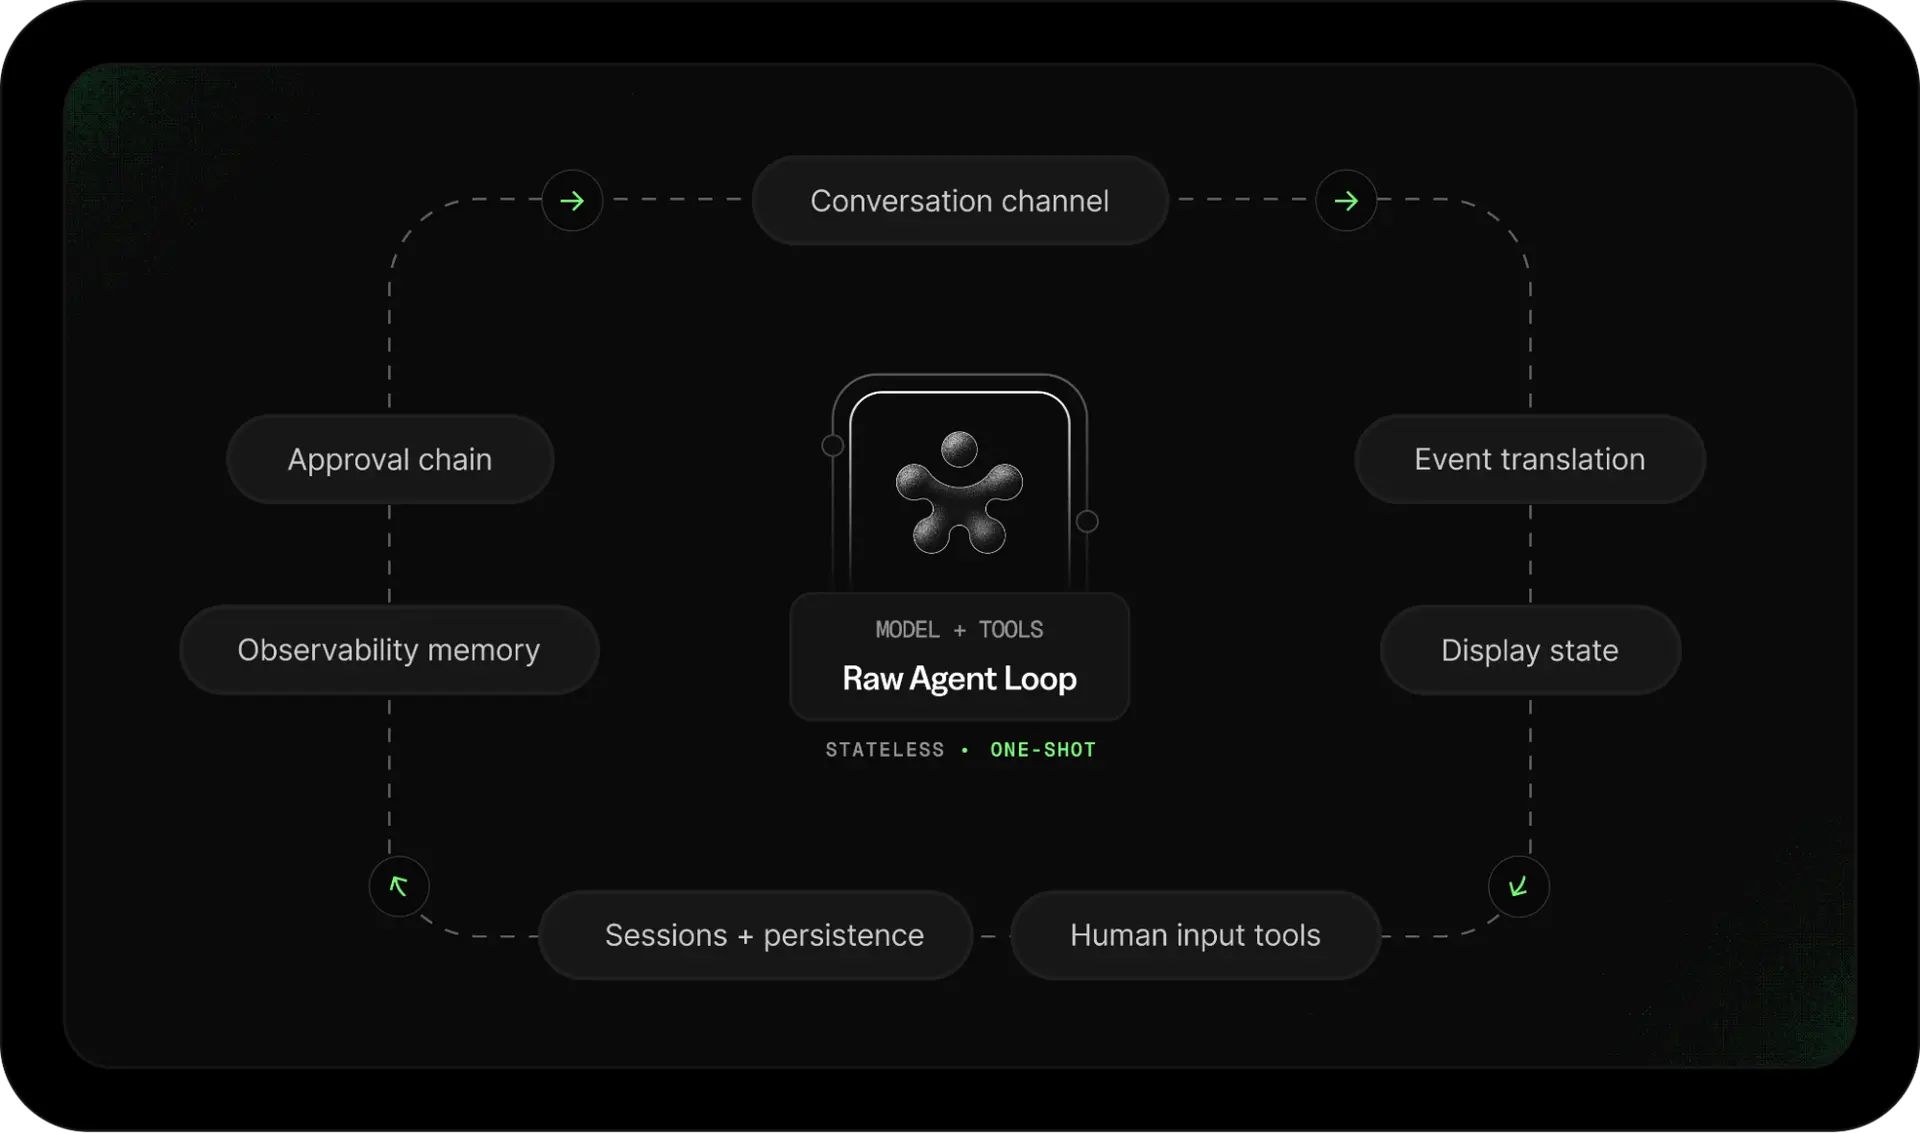
Harness 是包裹在 Agent 循环外面的那一层,负责把对话当作常开的通道来处理、两阶段的事件翻译,以及一个可直接渲染的单一显示状态。它还加入了为等待人工输入而暂停 Agent 的工具、会话与线程持久化、Mastra 场景下的观察记忆,以及一条审批链。
循环与包装层保持分离。你可以挑选不同的模型、模式、认证类型等,而不必把它们写死进核心。
Mastra 的 harness 如何组织对话
harness 把对话当作一条保持打开的通道,而不是一个调用一次就等着返回的函数。
一次普通的函数调用就像一次 HTTP 请求。你发出请求,模型流式返回响应,连接关闭,返回之后什么都不保留。
一条通道则像保持打开的 WebSocket 或 pub/sub 主题。harness 连接一次会话线程,此后它就持续推送消息进来,并接收 Agent 每一轮运行发出的所有内容。
harness 拿回一个订阅,它交给你分块流、活动运行的 ID,以及中止或退订的控制权。
只要线程存在,这个流就一直携带 Agent 在该线程上发出的所有内容。底层是一个 pub/sub 主题,正是它让连接在任意单次运行结束后仍然保持打开。
发送一条消息,就是在往这条打开的通道上发布内容。多个客户端可以同时订阅同一个线程,所以一个终端和一个网页视图能一起跟进同一段对话。
用这种方式保持对话打开,让一次性调用做不到的四件事成为可能。
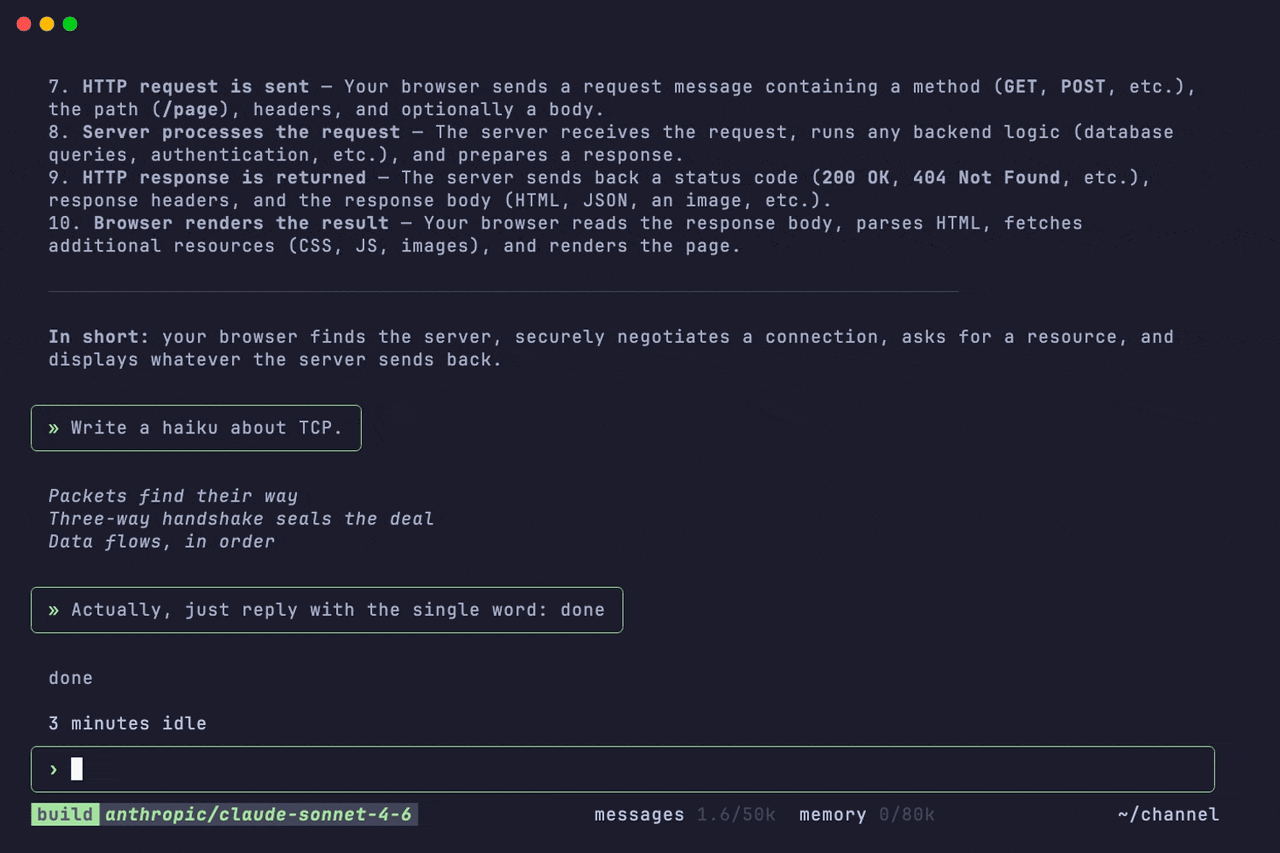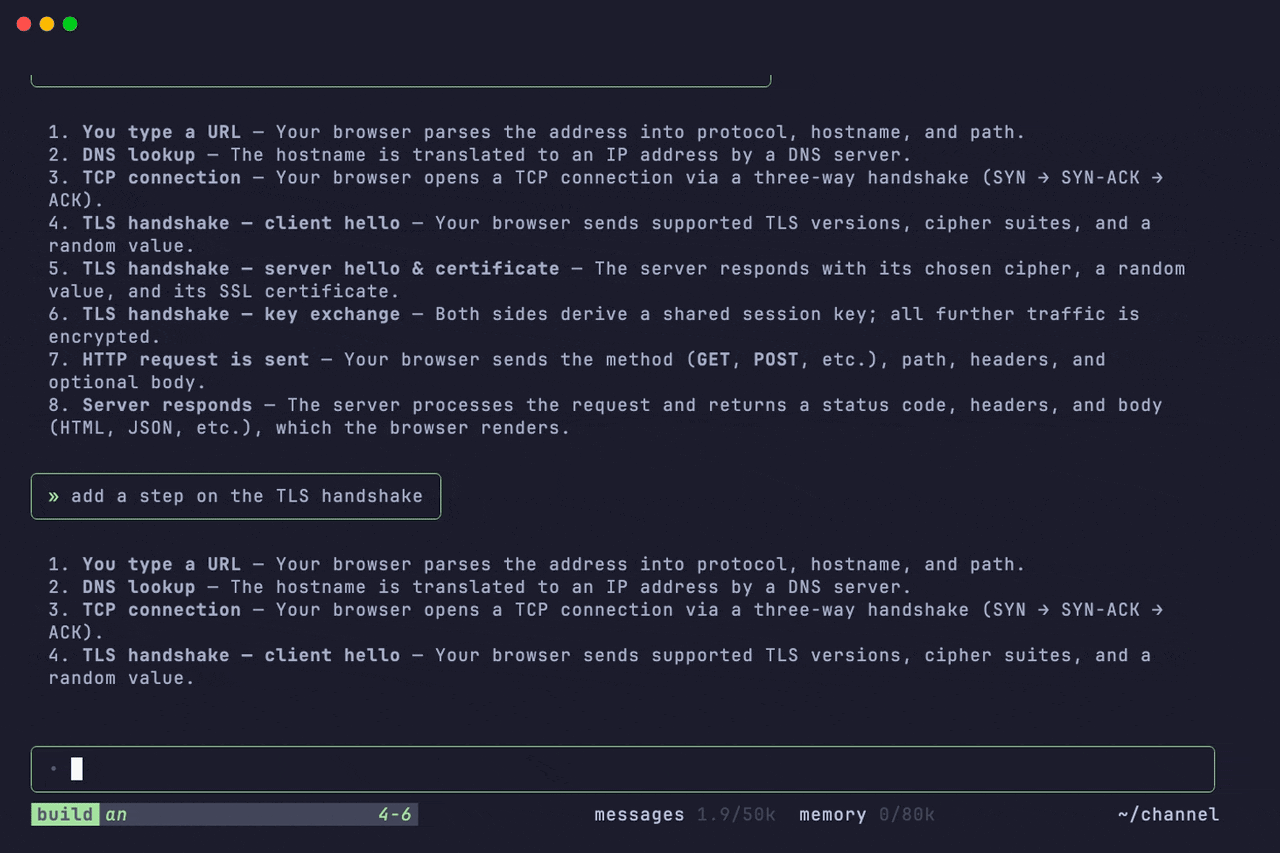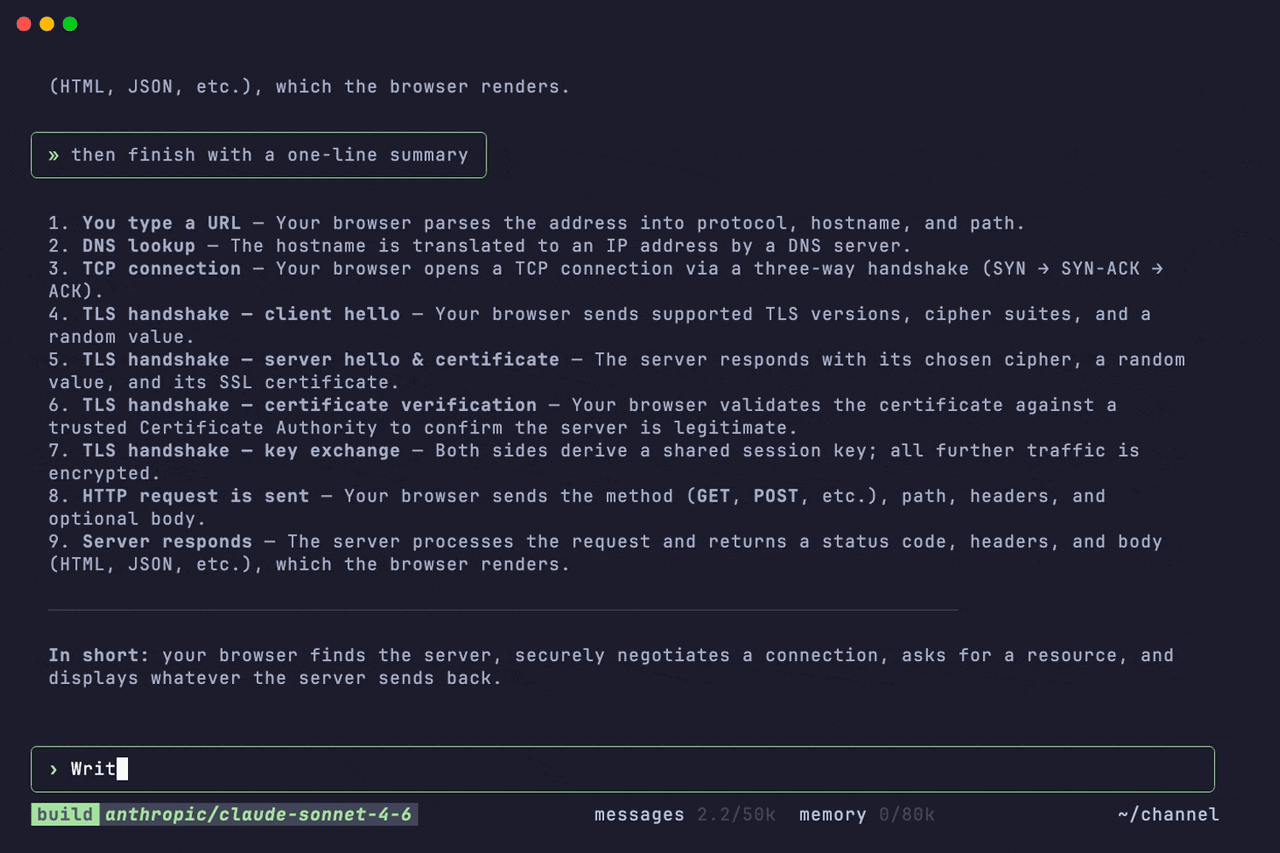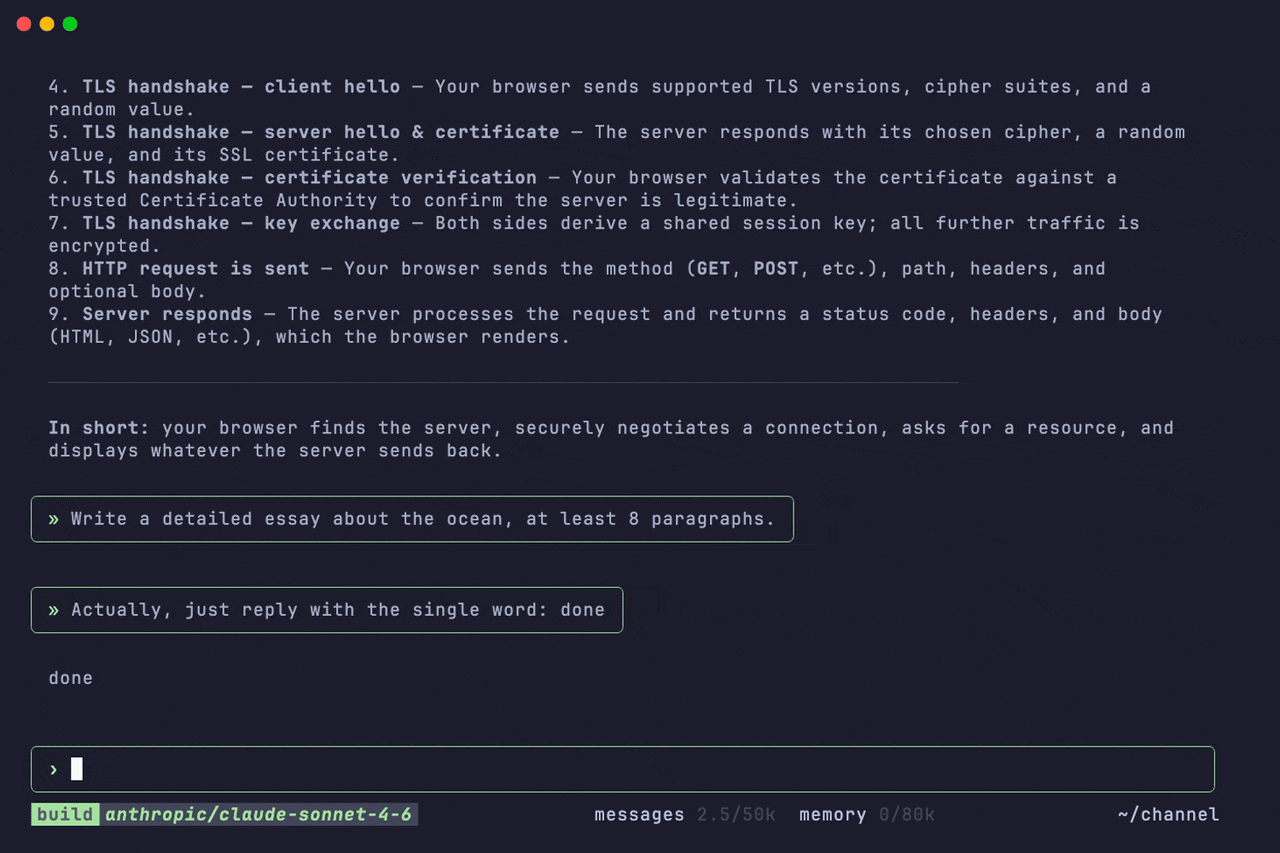
[插图:在打开的对话通道上中断、排队和引导一个运行中的 Agent]
- 你可以中断。 在 Agent 任务进行中打字,它会融入正在运行的工作,而不会停下它。
- 你可以排队一个后续任务。 在 Agent 还在忙的时候说出接下来要做什么,harness 会先握住这条消息,等当前运行一结束就发送它。
- 你可以引导。 让 Agent 停下去做别的事,harness 会丢弃当前运行、清空一切排队内容,然后重新开始。
- 它还能扛过崩溃。 因为对话活在线程里而不是运行中的进程里,你可以退出、重新打开、重新挂到同一个线程,然后从上次停下的地方继续。
这四种行为,就是为什么常开通道设计值得它多出来的那些管道。它上面的每一层都依赖同一条主干。
把原始模型输出转成结构化事件
如前所述,订阅交给你的是原始的 provider 分块。把这些流变成稳定内容的任务落在 processStreamChunk 身上。它把每种原始分块类型映射成一个干净、语义化的 harness 事件。
一个字段改名、一种分块类型拆分,或一个新的流式阶段,只会触及这一个函数,下游其他任何地方都不用动。同一个函数还处理你不应该原样显示在屏幕上的值。例如,当一个工具读取 API key 时,你不想让原始密钥打印在记录里。
所以工具可以给它的结果附加一个显示变换,即这个值的第二个、仅供显示的版本。实际值仍会保存进消息并发送给模型。敏感数据渲染成 ••••••,而工具在真实密钥上运行。
把事件归约为单一显示状态
我们所说的事件,不过是来自用户和 Agent 双方的一条条独立更新的流。UI 不应该通过逐条回放这些事件来自己组装画面。
所以 harness 用一个 reducer 把每个事件折叠进单一对象。
它构建的这个对象是一个显示状态,容纳了屏幕绘制一帧所需的全部内容:Agent 是否在工作、正在写的消息、哪些工具在运行、任何待处理的审批或问题、子 Agent 活动、记忆进度、变更过的文件,以及实时任务列表。
渲染器随后只问一个问题:"世界现在长什么样?"它读取对象并绘制。它从不解析原始事件。
根据你的需要,有两种监听方式:
- subscribe(listener) 按顺序给你每一个事件,不做任何合并。适合日志和分析,那里要的是完整记录。
- subscribeDisplayState(listener) 给你合并后的最新状态快照。适合只关心当前帧的终端或网页 UI。
批处理重绘
快照需要合并,因为流式 Agent 每秒发出几百个事件,大约每块文本一个。每次都重绘终端会被淹没。
DisplayStateScheduler 负责处理这件事。它把普通更新批处理进 250 毫秒窗口内,硬上限 500 毫秒。突发会被压缩成每秒几次重绘,而上限保证长流期间屏幕仍然刷新。
有些事件不能等在那个批次里。任何阻塞人类的事都插队:请求审批的工具、被挂起的工具、一个问题、等待批准的计划、Agent 开始或结束,以及任何线程、模式或模型的切换。
例如,当 Agent 问"我能运行这条命令吗?",这个提示必须立刻出现,而不是最多半秒之后。所以这些事件会立即刷出。
每次刷出还会把快照过一遍 cloneDisplayState,它深拷贝其中的映射、日期和嵌套数据。订阅者可以握住一帧,并相信当下一个事件到达时它不会在底下悄悄改变。
工具如何暂停 Agent 并请求人工输入
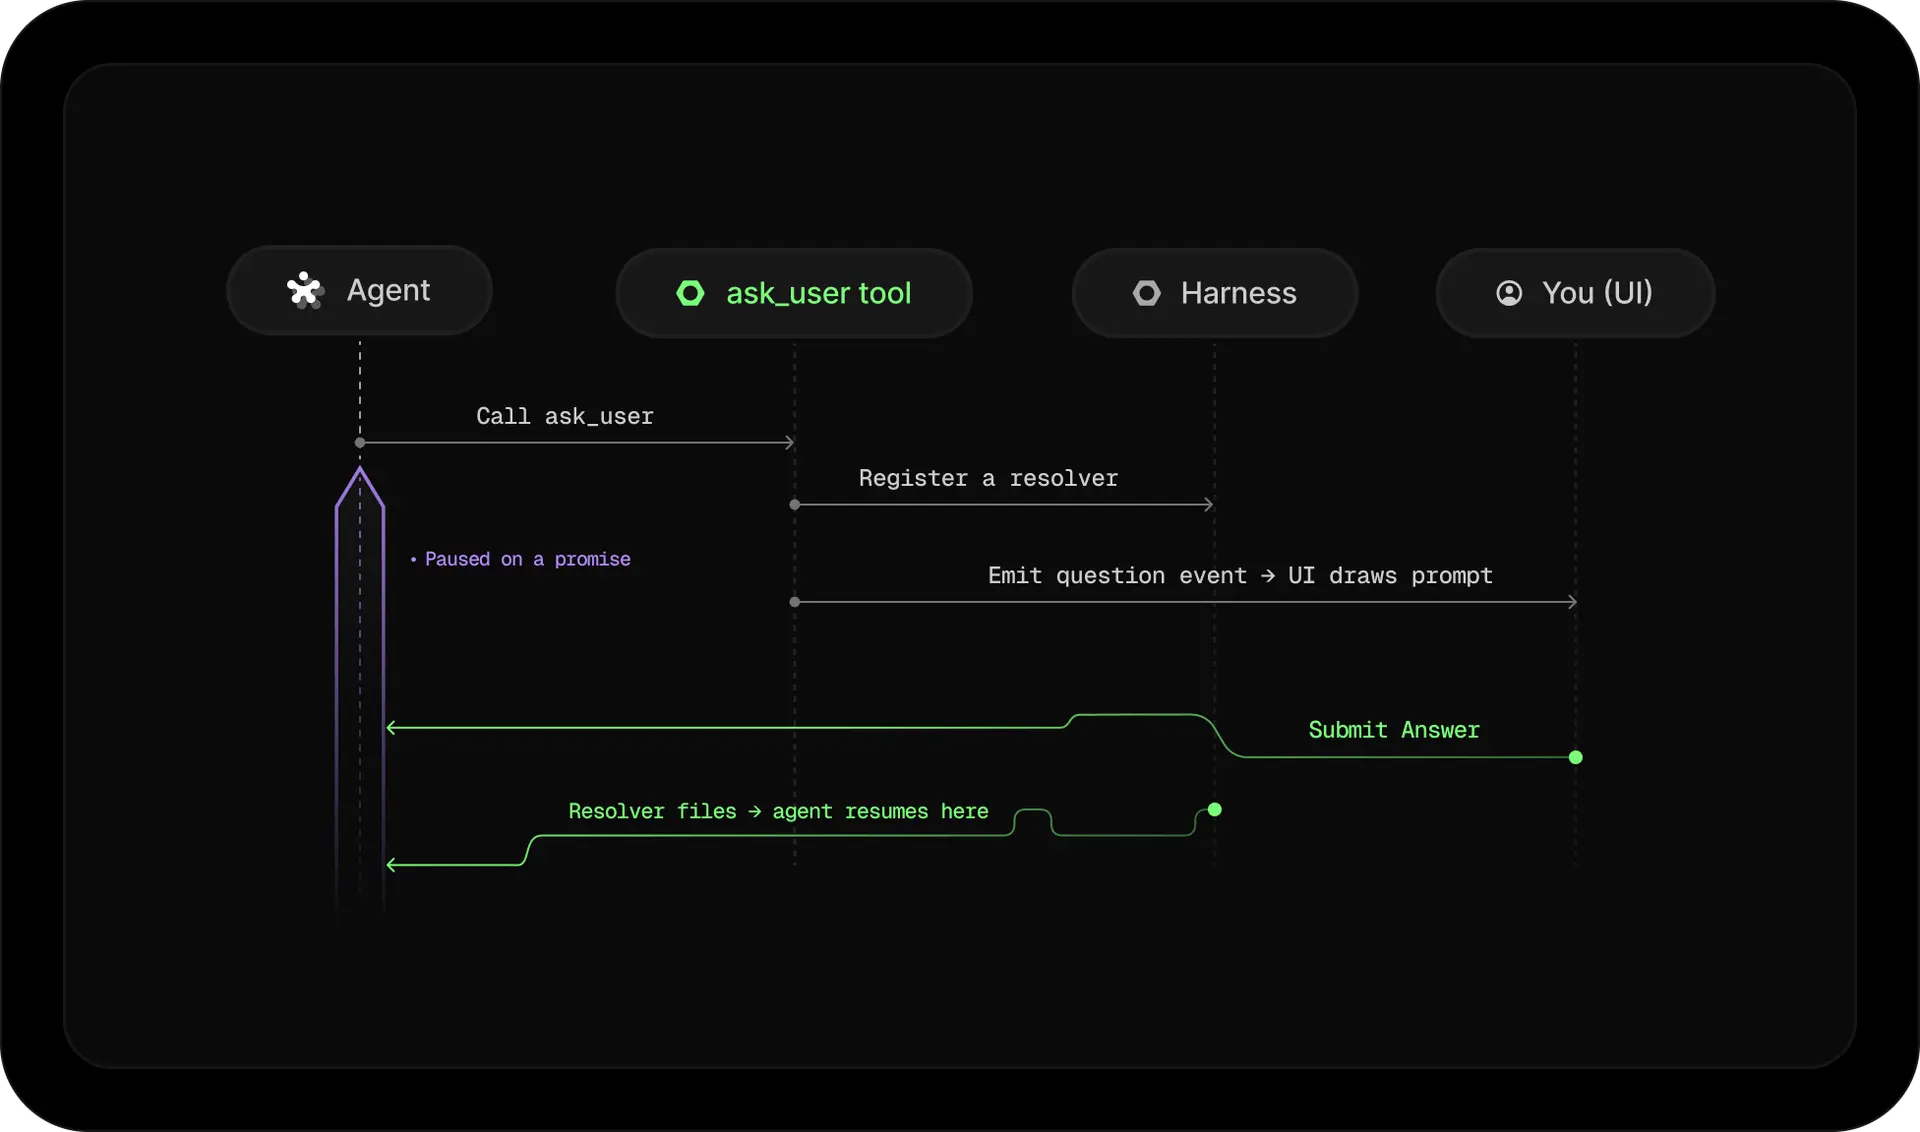
工具可以在执行中按下暂停。从模型这边看,没有任何特别的事发生。它只是调用了一个需要很久才返回的工具。在底层,harness 一直把这个工具挂起,直到你回答。
[插图:一个工具通过回传通道暂停 Agent 并请求人工输入]
这运行在一条回传通道上。每次运行前,harness 把一个小的对象挂到工具的上下文上——一条回到 harness 的私有线路,模型永远看不见。
通过这条线路,工具可以在屏幕上绘制提示、注册一个问题或一次计划审批、读取和更新 harness 状态,还能触达线程身份和中止信号。
这条回传通道是有意做成可选的。例如,如果同一个工具在没有 harness 包裹的 CI 流水线里运行,它会回退到纯文本路径并继续工作,而不是崩溃。
用 askUser 提问
askUserTool 把这一机制展示得最清楚。这是来自我们代码库的一段代码:
工具向 harness 注册一个回调,发出一个事件让 UI 绘制提示框,然后在一个 Promise 上等待——它在你回答之前不会 resolve。
[插图:askUser 工具绘制提示框并等待用户回答]
一旦你回答,UI 就把你的回复发给 Agent。harness 找到存好的回调、触发它,Promise resolve,工具返回结果。循环从暂停处精确地接上。
等待被接进了中止信号,所以 Ctrl-C 能干净地取消它,而不是让一个工具永远挂死。而纯文本回退意味着同一个 Agent 能在无人可问的无头流水线里运行。
交接计划
submitPlan 工具复用了回调加 Promise 的机制:注册一次计划审批,并发出 planApprovalRequired。
计划被批准后,harness 切换到构建模式,并等待流完全静止再采取任何后续步骤。这次交接把 Agent 从只读规划移进执行,两次运行之间没有重叠。
任务工具
任务工具都作用于保存在 harness 显示状态里的同一个任务列表。其中三个会修改这个列表:
- taskWrite 整体替换它,而 taskUpdate 和 taskComplete 按 ID 修改单个任务
- 每次修改都会发出一个 taskUpdated 事件,让渲染出来的待办清单随 Agent 的工作保持最新
- taskCheck 是只读的,它读回同一个列表,在 Agent 收尾前确认所有事项都已完成。这套机制里有两个设计选择值得展开。
子 Agent:隔离或缓存复用
harness 为子 Agent 提供两条路线。
非分叉路线会启动一个全新的 Agent,带自己的指令和受限工具集。它的 harness 上下文不携带线程 ID,所以父级的任何历史或观察都到不了它。当你想要一个父级推理无法左右的无偏见读者时,这种隔离正是关键。例如,一个"审查这段代码里的 bug"的子 Agent,如果它还没读过父级论证代码为什么正确,会做得更好。
分叉路线则用那份隔离去换 provider 的提示词缓存。它克隆父线程并在父 Agent 上运行,所以模型看到的是它刚处理过的同一段对话,缓存保持温热,这更便宜也更快。
为了保证安全,分叉让每个工具的模式保持完全一致,这样请求仍然命中缓存,只替换被阻塞工具在运行时实际做的事。例如,一个试图派生自己的子 Agent 或编辑共享任务列表的分叉子 Agent,会撞上一个返回提示并就此打住的桩。克隆体还会被打上 forkedSubagent: true 标记,所以它不会出现在用户的线程列表里。
会话、模式与线程持久化
模式不过是 Agent 的一套已保存设置。
每个模式都有一个名称、可选的标签与颜色、一个默认模型,以及它运行的 Agent。Build、Plan、Fast 都是模式。切换模式时,harness 会停下正在运行的一切,记住你在离开的那个模式里用的模型,把你移进新模式,并带回你上次在那里用的模型。所以如果 Build 设成一个模型、Plan 设成另一个,你可以整天来回切换,各自保持在自己的模型上。再也不用重新挑选。
所有这些都随对话本身一起保存,而不是随运行中的程序保存,这就是它扛得过重启的原因。对话记得你处在哪个模式、每个模式用哪个模型、你花掉了多少 token,以及你的记忆设置——比如由哪些模型做总结、它们在什么时机介入。
所以你可以在任务中途关掉终端,过会儿再打开,回到同一段对话,发现一切都在你离开时的位置。
一段对话还可以同时在两处打开,比如两个终端窗口。为了防止它们互相踩踏,harness 会给它上锁:先拿到新锁再放开旧锁,如果失败就撤销这次交换。两个窗口永远不可能都认为自己拥有同一段对话。
当你去挑选模型时,harness 会帮你把列表构建好。它从内置 provider 开始,加上你自己配置过的任何模型,再检查哪些是你实际登录过的,查看你的环境变量和已保存的凭证。它把这个列表记住十秒,所以再次打开菜单时不会重新检查每个 provider。
工具审批
每个工具调用在运行前都会归结为三种结果之一:允许(allow)、拒绝(deny)或询问(ask)。harness 通过走一条有序规则链得出这个裁决,第一个命中者胜出,所以检查的顺序本身就是策略。
按工具的拒绝排在最前,它是一道硬性拦截,下游任何东西都无法重新打开——这让你能圈禁一条单独的危险命令,无论其他一切变得多么宽松。
只有当一次调用通过了那道闸门,YOLO 模式才有发言权,自动批准一切未被拒绝的内容。
再往下,harness 会依次咨询你为工具本身设定的显式策略、你在此前会话里恰好批准过的工具,最后是工具的类别(read、edit、execute、mcp 或 other)——拿它同时对照你的会话级授权和你的常设类别策略;当一路走下来没有任何一方表态时,才落回到直接问你。
观察记忆
你可能已经注意到,Claude Code(或其他编码 Agent)的会话撞上上下文窗口上限时的有损压缩。为了解决这个问题,我们在 Mastra Code harness 里设计了一层观察记忆(observational memory,OM)。
[插图:Mastra Code harness 中的观察记忆]
OM 是一个 LLM 总结器,在某个可自定义阈值(默认 40k token)处激活,把冗长的对话转成小得多的内容(100 到 1500 token),清空上下文,并用观察者总结出的 token 替换它。相比纯压缩,它能在更长会话中保留多得多的信息。
harness 持有阈值、模型选择、失败策略,以及记忆事件的屏幕呈现。总结本身活在 memory 包里。
还有一层反思(reflection)层,在观察记忆触达一个可自定义阈值时启动,对观察日志做总结。
观察记忆架构在幕后如何运作
这里有两个模型在同时工作。
- 一个观察者(observer)模型,它读取对话并写下结构化观察:决策、事实和状态变化。
- 一个反思者(reflector)模型,它在这批观察堆积起来后压缩它们,在合并时保留完成标记和日期之类的东西。
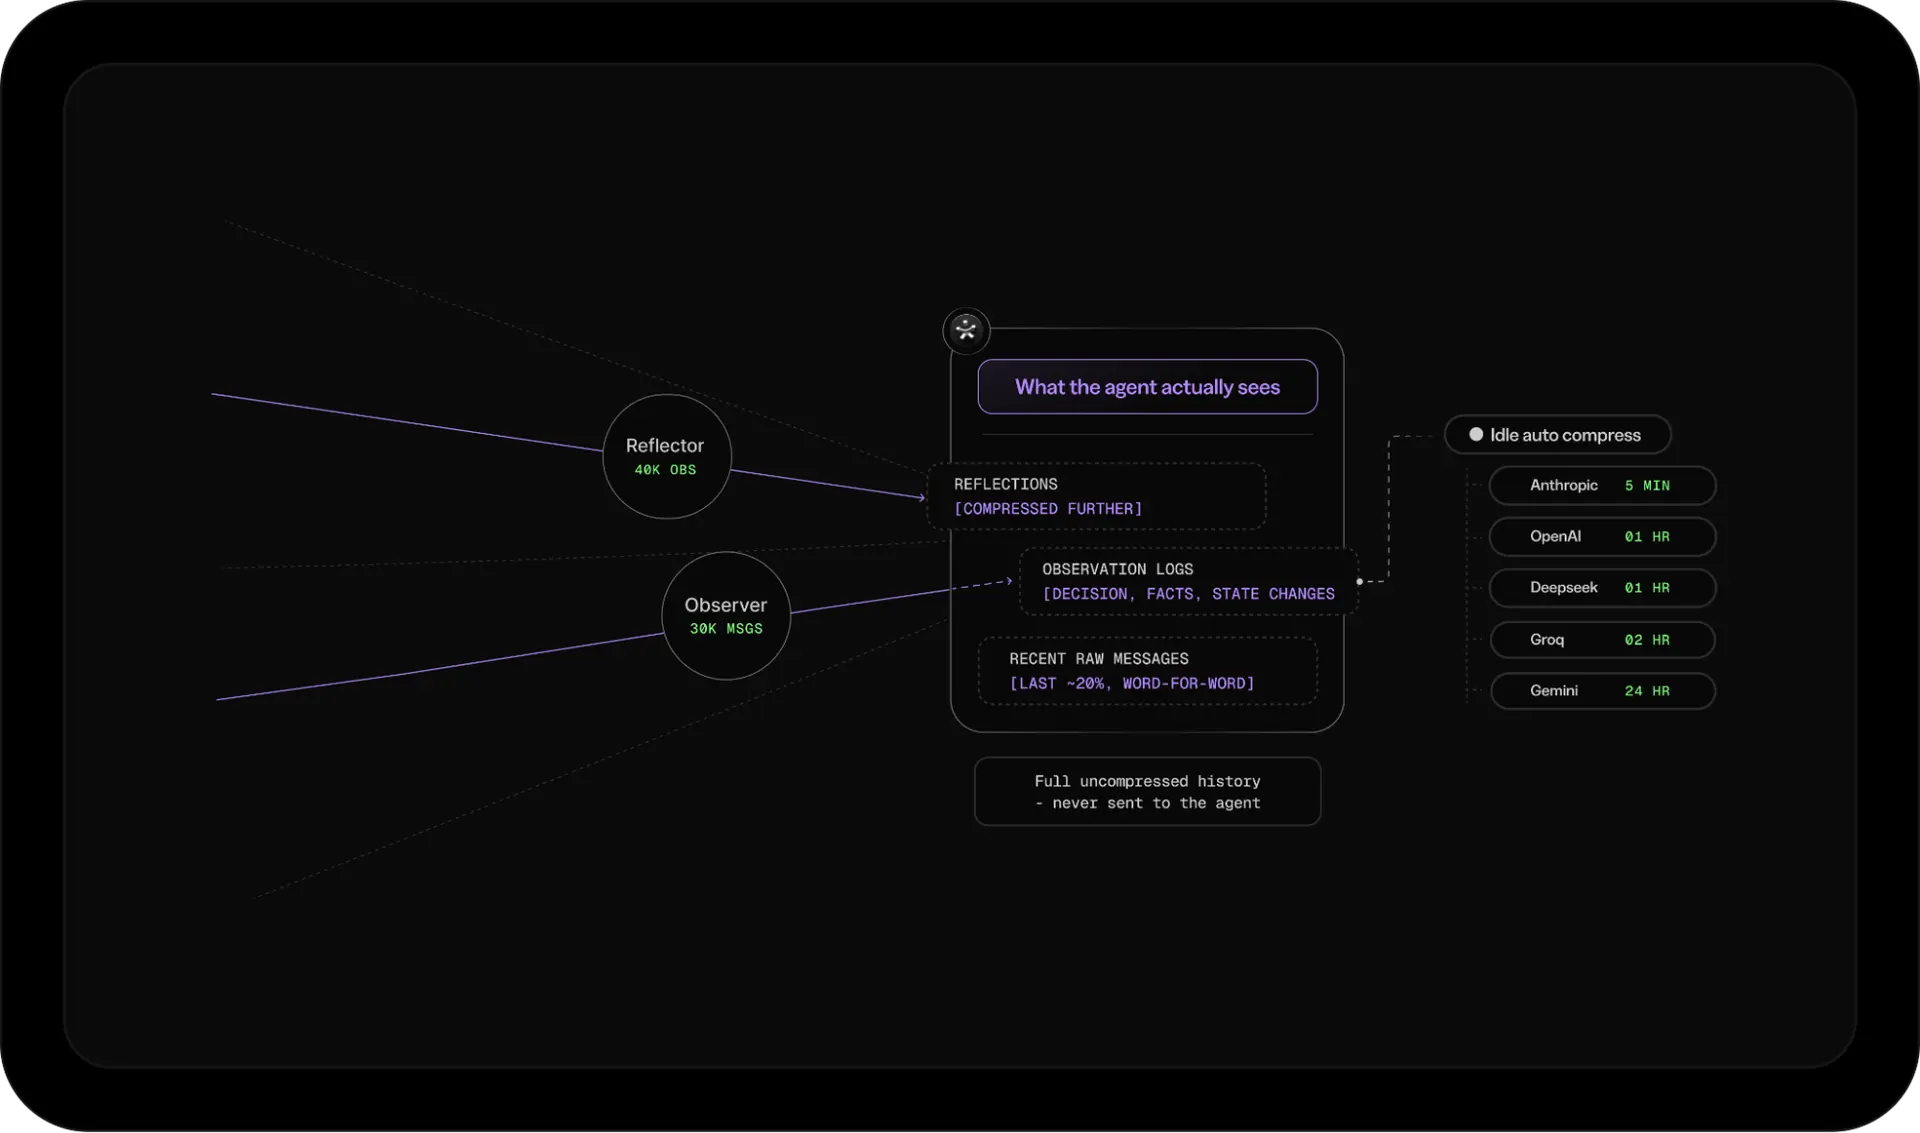
而与你对话的主 Agent 读取三层:
完整未压缩的历史绝不会被保留下来撑大上下文。我们希望在整场会话中尽量把高信号上下文交到 Agent 手里。
例如,与其携带四十轮原始工具输出,Agent 看到的是逐字逐句的最后几条消息、一条类似"我们选了 Postgres、构建通过了、auth 文件不可碰"的简短日志,以及上面一层压缩摘要。决策以决策的形式存活下来,而不是作为埋在摘要里的转述。
什么会触发观察记忆
虽然观察者默认设计在 40k token 启动,但它会略微提前于阈值运行,按 20% 的间隔推进,所以观察通常在触顶之前就已就绪。上限到达时,工作已经完成,harness 直接换入结果。
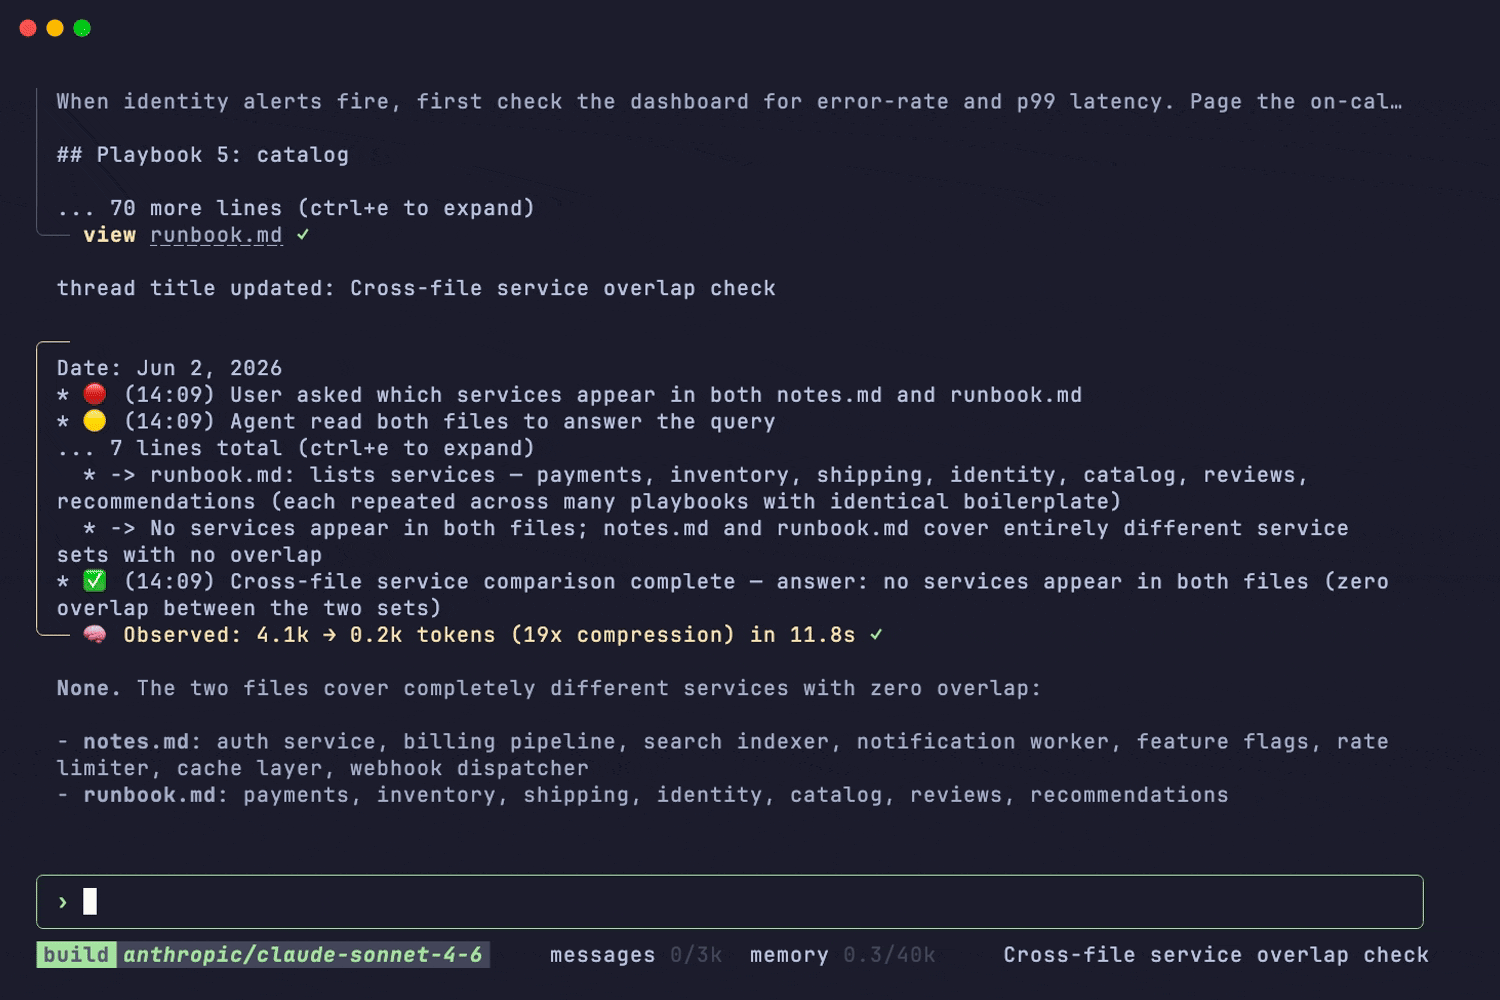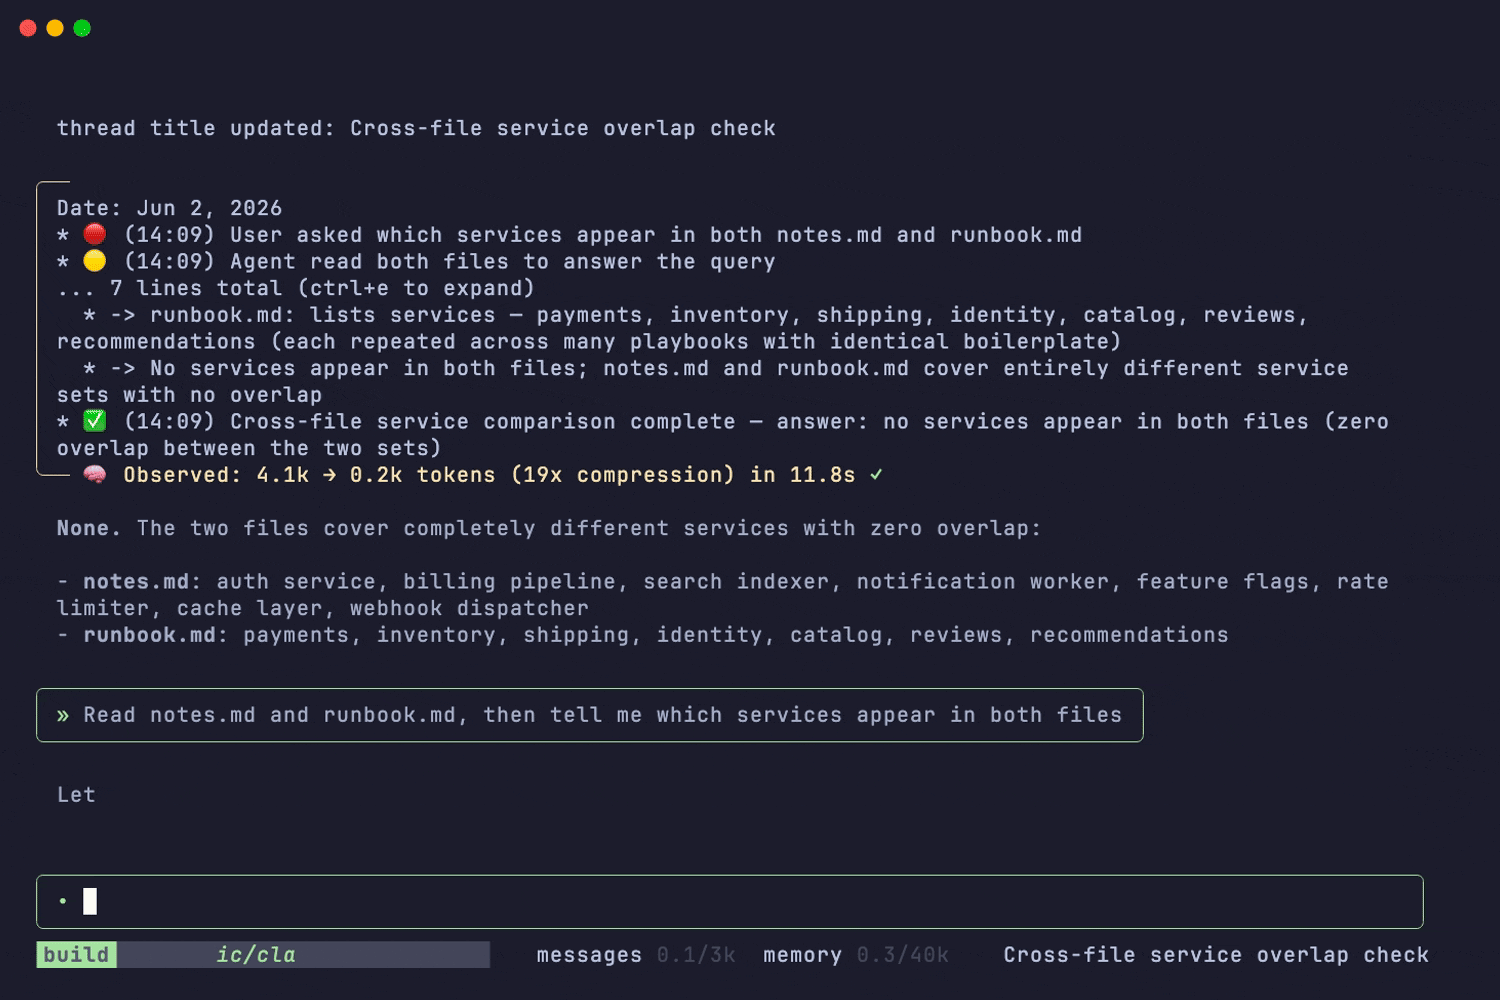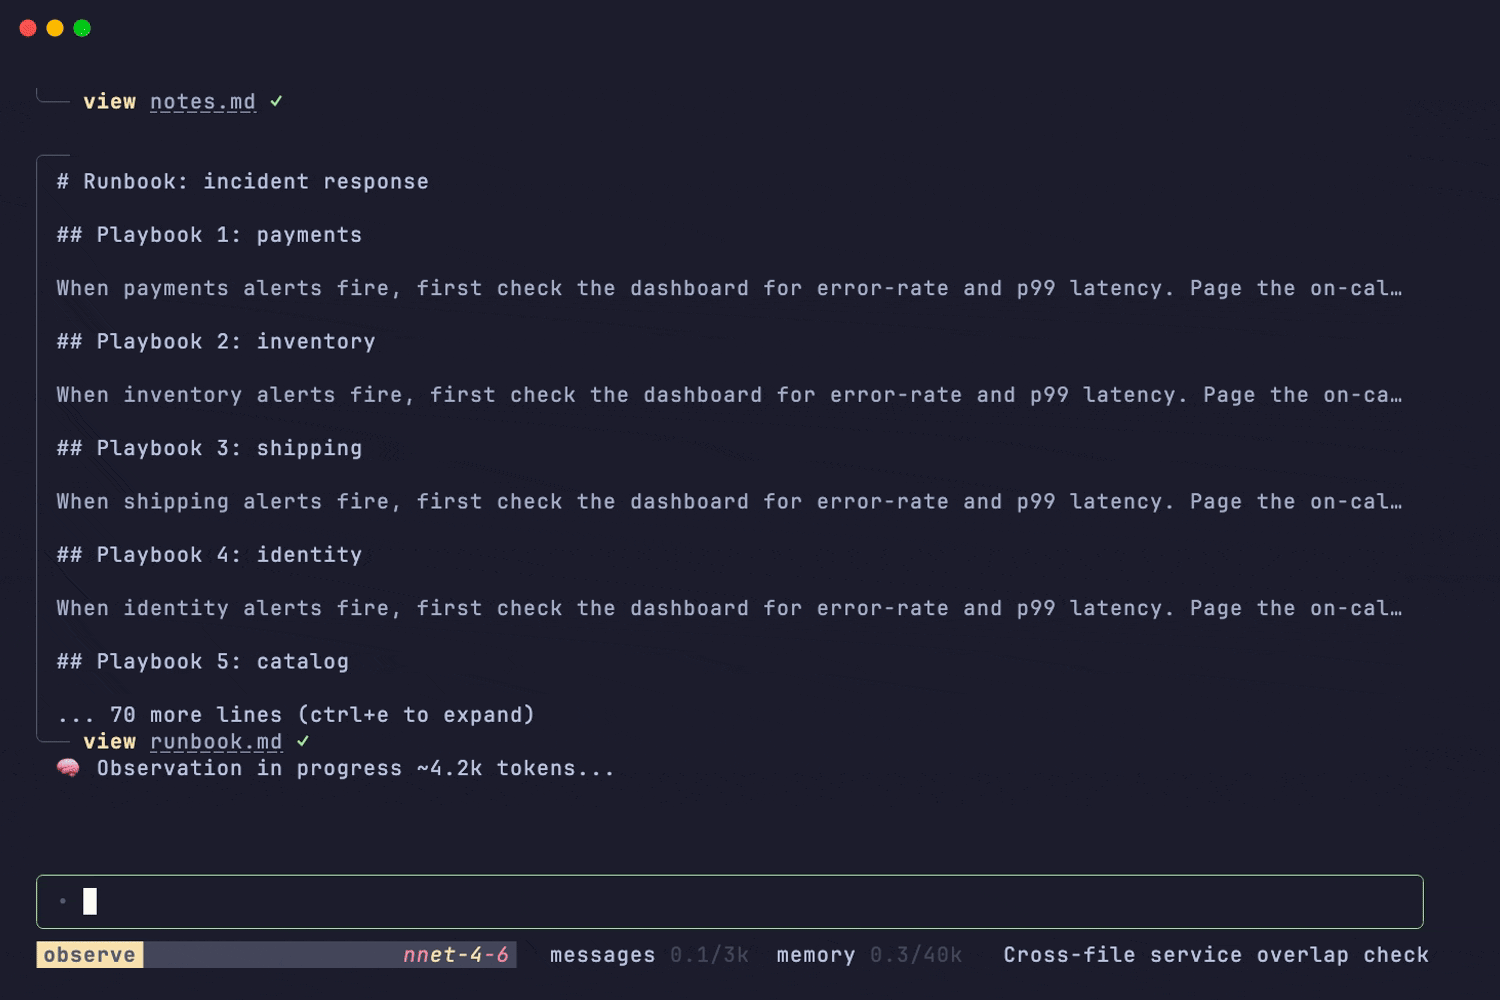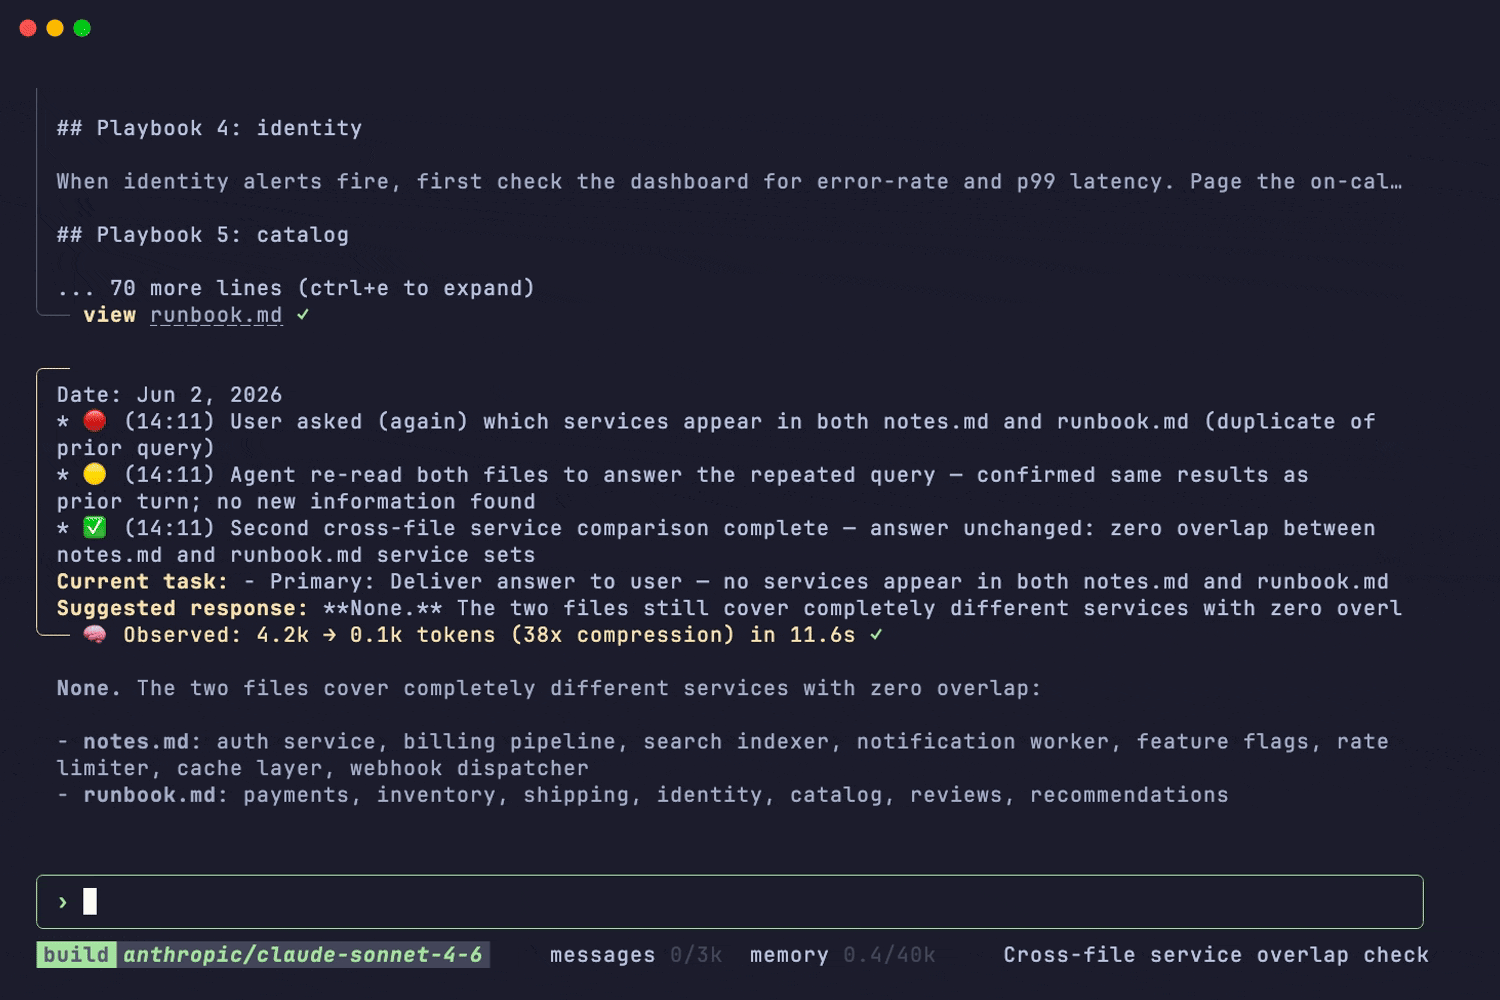
例如,我把观察阈值设成 3k token,然后让它读一份大约 4.2k token 的文档。观察者接管并把上下文从 4.2k 压缩到 0.1k token。
[插图:观察者把 4.2k token 的上下文压缩到 0.1k]
OM 也可以在一段空闲之后触发;在自动模式下,它会根据 provider 挑选空闲超时,以匹配各家把提示词缓存保持温热的时间。
例如,Anthropic 约 5 分钟,DeepSeek 和 OpenAI 一小时,Groq 约两小时,Google Gemini 24 小时。OM 也会在切换 provider 时触发。新 provider 无法复用之前的缓存,所以交给它一份紧凑压缩的画面,比交给它一份冗长原始历史更好。 如果出于任何原因,观察者或缓冲步骤失败,harness 会中止这次运行,而不是在会话的损坏画面上继续。
Mastra Code 与 Claude Code、OpenAI Codex 的对比
这些是你和编码 Agent 共度普通一天时会碰到的东西。竞品的行为会随版本不断变化,所以请把另外两列当作一张快照,而不是一份规格说明。
| | | |
|---|
| 在后台边运行边蒸馏对话,Agent 保持稠密的工作记忆,从不经历一次性的"总结后丢弃"步骤 | 等到上下文几乎占满,再把整段历史总结一遍并用总结替换它 | 等到上下文几乎占满,再把整段历史总结一遍并用总结替换它 |
| 重新打开线程,它以任务中途的状态回来,带着同样的模式、模型、记忆阈值和 token 计数 | 用 --continue 重新运行以恢复上一个会话,或 --resume 从列表里挑一个,每次由 CLAUDE.md 文件重新喂入项目上下文 | 从 CLI 恢复过去的会话,每次运行由 AGENTS.md 文件提供项目上下文 |
| 在运行中的任务上打字,把一条备注折叠进去;为它结束时排队下一条消息;中止并改道;或退出并在之后把线程捡回来 | | |
| 一条有序规则链裁决每次调用,可按工具或整个类别设置 allow/deny,外加一个在沙箱里自动批准一切的总开关 | 在危险操作前请求许可,你可以累积一个白名单,让受信任的命令不再询问 | 从 suggest(逐项批准每个改动)到 auto-edit(编辑文件、运行命令前询问)再到 full-auto(在沙箱里无人值守运行)中选择一种审批模式 |
| 一个跨 provider 的选择器,每个模式可用不同模型,一行配置即可切换 | | |
| 完全开源,harness 库和 CLI 都是,可以在它之上发布你自己的 Agent | | |
内置模式
Mastra Code 自带四种模式加一个思考控制,每一种针对不同任务调校。
[插图:在 Mastra Code 的内置模式之间切换]
- Build 是默认模式,拥有完整工具访问权。它立即运行简单任务,并给多步任务一张实时任务列表。它运行在 anthropic/claude-opus-4-6 上。
- Plan 是只读的。它产出一份固定形状的结构化计划:概览(Overview)、复杂度评估(Complexity Estimate:规模、风险、依赖)、有序步骤(Steps:文件、改动、原因)和一份验证清单(Verification checklist)。然后它提交计划等待审批,运行在 openai/gpt-5.2-codex 上。批准计划会自动把 harness 切进 Build。这就是前面描述过的交接,现在由模式本身触发。
- Fast 为了速度去掉规划阶段。它用训练知识回答一般编程问题,只有当问题与具体项目相关时才去读项目代码。它运行在 cerebras/zai-glm-4.7 上。
- YOLO 代表"you only live once"(人生只有一次),它基本是唯一一种能让 Agent 自动批准任何命令、访问任何目录、在任务完成或失败之前从不请求许可的模式。它通常适合业余项目,或代码坏了也损失不大的代码库。
所有模式下,模型的思考等级保持恒定。例如,如果你不想让 Claude Opus 模型在它采取的动作上思考太久,可以用 /settings 或 /think 把思考设为 off,取值从 off 到 low、medium、high、xhigh。
扩展与配置 harness
幸运的是,很多 harness 都是开源的,所以你随时可以用任何你个人用例需要的额外功能或插件来自定义它。
harness 里默认提供一些功能,比如 MCP 服务器、技能(skills)和用来扩展 Agent 的插件。对于这些内置选项之外的任何需求,你可以更新 harness 代码把功能加进去。
MCP 服务器
模型上下文协议(Model Context Protocol)是 Anthropic 设计的一套系统,用来给 harness 轻松添加新功能、额外工具访问权和不同数据源,而不用改一行代码。
有了 MCP,你只要往所用 harness 的 MCP 服务器配置文件里加一段 JSON,带上所需的 bearer token 即可。完成后,你的 Agent 就可以访问这些新数据源或使用额外工具了。
以 Slack MCP 为例。如果你想访问自己的 Slack 消息,把 Slack MCP 加进全局配置,就能从编码 Agent 里查询你的对话,完全不用重写 harness 的任何部分。
技能
技能是一个 markdown 文件,为一种任务模式交给 Agent 持久、可复用的指令。它捕获了那些原本住在我脑子里、每个会话都要重新敲一遍的知识。比如项目的约定、某个重复工作流的步骤,以及"始终重新生成 generated client,绝不要手改它"这类约束。
写好一个技能,就把此后每个会话的那份重新上下文化的工作省掉了。我通常借助 Agent 来起草技能:把任务跑一遍,然后让它写下学到的东西。
收尾
从复杂性里退一步,有几件事你在任何 Agent harness 里都一定会看到:
- 对话是一条你保持订阅的通道,而不是你调用一次的函数,这正是让 Agent 可中断、可引导、重启后能恢复的原因。
- 原始模型输出被翻译成干净的事件,再折叠进单一快照,所以任何 UI 都只读快照,而不是解析流。
- 工具可以通过回传通道暂停并等待人类,而当没有人在场回答时,它们回退到纯文本。
- 会话状态活在线程上,所以关掉终端也会保住模式、模型、token 计数和记忆设置。
同一套架构适用于任何需要可中断、可持久、并在多个界面呈现的 Agent——无论是支持 Agent、研究 Agent 还是运维 Agent。Mastra 把它封装成一个可复用的 Harness 类,你可以直接在此基础上构建。
 AI 速览