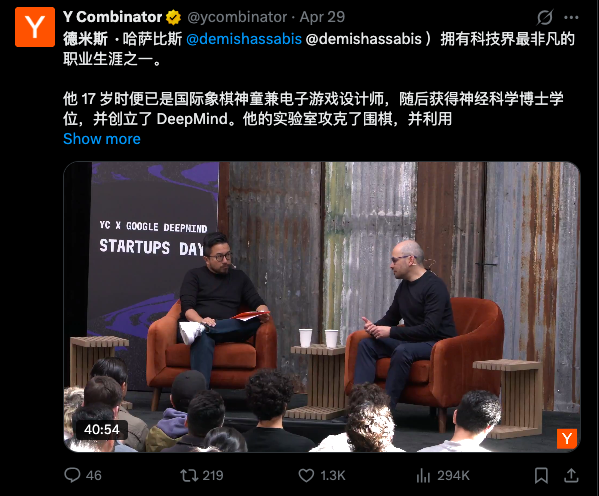
2010 年伦敦,一个小团队成立时把使命写成两句话——第一步:解决智能(solve intelligence);第二步:用智能解决其他一切。15 年后,这家公司被谷歌收购、做出 AlphaGo、AlphaFold,创始人 Demis Hassabis 因为 AlphaFold 拿了 2024 年诺贝尔化学奖。但当他站在 Y Combinator 的舞台上、被主持人 Garry Tan 追问"通往 AGI 还差什么",他给出的答案没有那种功成名就的笃定:架构应该没错,时间线大概 2030,但还需要一两个新的大想法,而且他自己评估这件事是 50/50。
这场对话因此值得被仔细听完——不只因为它来自现在仍在掌舵 Google DeepMind 的人,更因为他罕见地把 frontier 实验室内部对"还差什么"的判断说得很具体:持续学习、长期推理、记忆、一致性。每一项都对应着今天 frontier model 用户能直接感受到的那种 jagged intelligence——一边能拿 IMO 金牌、一边在简单数学题上翻车;一边能写出能跑的代码、一边在下象棋时陷入"明知是 blunder 但找不到更好的着法、只好走回去"的逻辑死循环。
哈萨比斯在演讲里说,他自己最近常做的一件测试是用 Gemini 下棋。"所有 leading foundation model 都不太会下棋",他说。这句话的分量不在抱怨,而在演示——一个在很多 benchmark 上看起来已经很强的系统,在一个规则完全定义、棋谱可被穷举验证的封闭场域里,推理仍然会塌缩成"明明不对但走回去"的 loop。这就是他说的 introspection 缺失。 14 年的 "solve intelligence":从 Atari 到 AlphaFold 再到 Gemini
哈萨比斯的履历在 AI 行业里是稀罕的样本——少年国际象棋大师、17 岁设计出商业级游戏 Theme Park、剑桥本科、PhD 做认知神经科学、研究海马体如何把新记忆并入旧知识。2010 年 DeepMind 成立时,这个组合让 "solve intelligence" 听起来不像企业愿景而像研究纲领。
接下来 15 年的成果对应着一条清晰的技术路径。2013 年 DQN 用 experience replay 让 agent 通过原始像素学会玩 Atari——这套"睡眠期回放重要轨迹"的思路直接借自神经科学;2016 年 AlphaGo 在首尔击败李世石,Move 37 让一项被认为还需 10 年才会被机器掌握的项目提前到来;2018 年 AlphaFold 1 与 2020 年 AlphaFold 2 把蛋白质结构预测这个 50 年生物学未解题逐步压平。今天 AlphaFold 数据库被全世界 300 多万研究人员使用,哈萨比斯说他认识的几位药企高管告诉他,"几乎所有从现在开始发现的新药,在某个环节都会用到 AlphaFold"。这是 2024 年诺贝尔化学奖颁给他的核心理由。
然后是 Gemini。这是 DeepMind 与 Google Brain 合并后的第一条旗舰产品线,从设计起点就是 multimodal——文本、图像、音频、视频、代码同时进入预训练。哈萨比斯在演讲里反复强调这一点:"Gemini 从一开始就是 multimodal 的,这件事目前依然被低估。" 在他的判断里,这是 robotics、世界模型、设备端 assistant 这些 next-step 应用的底层条件——单模态 LLM 在物理世界推理上会有结构性短板。Waymo 已经在内部增量使用 Gemini 模型,Gemini Robotics 也在这条 multimodal 主线上展开。
这些项目共同的特征是 search + RL + 模拟器 + 大规模数据。哈萨比斯没有把这些方法当作过去式:恰恰相反,他认为今天 frontier model 上正在发生的 thinking mode 和 chain-of-thought 推理,本质上是 AlphaGo 思想在 foundation model 上的回归。"AlphaGo 时代的很多想法,我们现在重新拿出来在更大的尺度上做。" 这条主线的延续性,是理解他为什么把 AGI 押在 2030 的前提。
AGI 锁 2030,但 50/50 概率还差一两个大想法
主持人 Garry Tan 问得很直接:你比几乎所有人都更早开始想 AGI 这件事——现在的范式(大规模预训练 + RLHF + chain of thought),你认为占了通往 AGI 架构的多大比例?还差什么?
哈萨比斯的回答分两层。
第一层是肯定:他不认为现有架构会被发现是死胡同。这一点他相当笃定。"这些组件已经走了这么远、证明了能做这么多事。我看不到一个未来,过两年我们突然意识到这条路不通。" 这句话其实是对当前业界一个隐忧的直接回应——OpenAI 的 reasoning 系列、Anthropic 的 thinking mode、各家 reasoning model 在 benchmark 上确实越爬越高,但同时已有研究开始质疑 scaling 是否在递减。哈萨比斯的意思是:即便有递减,也不意味着方向错。
第二层是补充:架构对了,但还差一两块。具体哪几块,他列得很清楚——continual learning、long-term reasoning、memory,以及"系统在不同情况下表现的一致性"。前三项是技术界已有共识的缺口,第四项一致性则更接近用户感受层面的问题。
这里有一个评价句值得记下来。哈萨比斯说他对这件事的概率判断是 about 50/50——也就是说,他认为现有方法配合渐进式创新就能 scale 到 AGI 的概率,和"还需要一两个根本性大想法才能到达"的概率,差不多对半开。这个数字直接挑战了行业里两种极端叙事——一种是"再放大十倍就行了",一种是"我们离 AGI 还有几十年"。50/50 的意思是:中间。
记忆机制是他单独花时间讲的一块。他的判断是,context window 是 working memory 的暴力替代——把所有信息全部塞进去、让 attention 自己去找。"这个方法对大部分场景够用,但不可能是最终方案。" 他给出的具体反驳是:即便机器的 context 可以做到 10M token 的完美回忆,从中找到"对当前决策真正相关的那一块"的成本也不是零。更关键的是,如果要处理实时视频输入,1M context 只能装下大约 20 分钟——做一个能理解你过去几个月生活的 assistant,1M 远远不够。
这部分对开发者的启示是直接的:不要把"长 context 解决一切"当成假设来设计产品。哈萨比斯把这个领域明确称为"还有大量创新空间",这意味着 DeepMind 内部应该已经有团队在做超越 attention-based context 的记忆架构。同样的判断在 Anthropic、OpenAI 的研究员公开讨论里也越来越常见——长 context 是必要的,但不是充分的。
从 AlphaGo 到 Gemini,以及为什么小模型同时变得这么强
DeepMind 一直是 agent-first 的实验室——这是哈萨比斯的原话。从最早的 Atari 到 AlphaGo、AlphaStar(StarCraft)再到 MuZero,他们一直在做"能主动达成目标、做决策、做规划"的系统。区别在于,过去这些系统是为单一封闭场域(围棋、星际)定制的;现在的目标是把这套思想搬到 general-purpose foundation model 上。
哈萨比斯说,这两年 frontier model 上的 thinking mode 和 chain of thought,"很多就是 AlphaGo 当年那一套的回归——只是放在更通用的语言/世界模型上"。他直接点了 Monte Carlo tree search,以及在 RL 之上叠加搜索的多种增强思路。这与外界对 OpenAI o-series 的解读一致——业界普遍认为 o1/o3 大量借鉴 search-augmented RL 思想,而 Anthropic 的 reasoning mode、Google 自家 Gemini 的 thinking mode 在结构上做的也是类似的事。RL 在 LLM 时代曾经被淡化,现在以另一种姿态回到中心。
但同时另一条主线在放出反向信号:小模型变得越来越强。Gemini Flash 系列在 DeepMind 内部被认为是"95% frontier 性能 + 1/10 价格"。Gemma 4 开放权重 2.5 周内累计 4000 万下载——这是哈萨比斯在演讲里直接给出的数字。这两条线之所以不矛盾,在他的解释里,是因为 Google 必须服务的是十几个十亿用户级产品——搜索 AI overviews、AI mode、Gemini app、Maps、YouTube 都在内,这种规模下,frontier 性能的蒸馏与压缩不是锦上添花,而是基础设施。
他被问到"小模型还能多聪明",答案是:目前没看到任何信息论意义上的硬上限。他的工作假设是,frontier 模型出来后大约半年到一年,核心能力可以被压到非常小的边缘模型上。Gemma 4 就是这个 pipeline 的产物。这一点对创业者的隐含影响很直接:不要把今天 70B 量级模型才有的能力当作"必须用大模型才能做的事"——半年到一年后,同样能力可能在 7B 或 3B 上跑得动,部署成本下降一个数量级。
边缘模型还有另一层意义,是哈萨比斯讲到 robotics 时强调的——本地推理对隐私、低延迟、断网容灾都关键。他描绘的端态是:本地小模型处理音视频流,只在必要时把复杂决策委托给云端 frontier model。这个分工方案与 Apple Intelligence、各家手机厂的"端云协同"叙事在结构上一致,只是 DeepMind 的策略是把这一类边缘 model 直接做成 Gemma 这样的开放权重——对手机厂、机器人公司、glasses 设备厂来说,这相当于送出了部署阻力最小的那一块。
至于推理成本会不会降到接近零——哈萨比斯不认为会。他援引 Jevons Paradox:成本降下去,用量会涨上来,直到把任何释放出来的算力填满。"未来要么是 swarm of agents 一起跑,要么是单 agent 跑很多方向再 ensemble。无论哪种,都会把可用 inference 用光。" 即便有一天能源因为聚变或者电池革命变成接近零成本,芯片本身的物理产能也仍然会是瓶颈,至少未来几十年是。
Agent 还在起步,创造力还过不了"发明 Go"测试
主持人提到行业里"Agent 是不是过度炒作"。哈萨比斯的回答是:正好相反,刚刚开始。但他也明确划出了"今天能做"和"今天还做不到"的边界,这部分对正在做 Agent 产品的团队特别有参考价值。
他认为今天的 Agent 在工作流的某些片段上已经能产生真实价值,但还很难做到 fire and forget——也就是设定一个高层目标后,Agent 自主跑完整个任务。卡点正是上一节提到的 continual learning 缺位:Agent 无法根据具体上下文调整自己,无法把"这次踩过的坑"沉淀到下一次决策。哈萨比斯说他个人没有看到"放出去几十个 Agent 跑 40 小时"产生的实际产出能匹配那么大的输入。这是一句相当直接的评价句,值得在 Agent 创业方向上反复读——现状是,人类工程师配合 Agent 实现 1000x 放大的路径,目前比"完全自动化"更靠谱。
但比 Agent 更深的瓶颈,是创造力。哈萨比斯讲了一个判断,可能是整场对话最值得引用的一段:AlphaGo 在第二局走出 Move 37,这件事很酷,但它是在围棋已经存在的前提下走出的"漂亮一步"。真正的创造力,是从零发明围棋这种游戏。"给我一个高层描述——一个能在 5 分钟学会规则、却需要几辈子精通、审美上美丽、能在一个下午下完——能不能反推出'围棋'?今天的系统做不到这件事。"
他把这套判断扩展成一个具体的测试设计,他自己叫它 Einstein 测试:把模型的训练知识截止设到 1901 年,然后让它去做 1905 年 Einstein 做的事——奇迹之年的那几篇论文,包括狭义相对论。"这件事一旦做到,我认为这些系统就在'发明真正新东西'的边缘了。" 他认为这件事不是魔法,只是当前架构里大概还差一两块——很可能就是前面说的 introspection,对自己思维过程的反观能力。
这段话其实回应了一个 frontier 实验室内部一直在讨论的问题:reasoning 是 pattern matching 的延伸,还是某种独立能力? 哈萨比斯的判断是后者——存在一种 analogical reasoning,超出 extrapolation 但不依赖 magic。今天的系统在某些情况下展现出这种能力的萌芽,但不稳定、不可控。
哈萨比斯总结 AlphaFold 模式时给了三个条件,这套条件其实就是当前 AI 能/不能拿下某个领域的判别函数:第一,问题可以被描述为巨大的组合搜索空间——越大越好,brute force 走不通;第二,有清晰的目标函数,比如蛋白质的自由能、围棋的胜负;第三,有足够数据,或可以用模拟器生成 in-distribution 的合成数据。三条都满足,今天的 frontier model 大概率能给出突破;少了任何一条,事情就变得很难。
这条判别函数对 deep tech 创业者价值很高。药物发现满足三条,所以 Isomorphic Labs(从 DeepMind spin-out 的公司)正在快速推进——哈萨比斯透露"很快会有大动作"。材料科学、数学、climate modeling 也都在 AlphaFold 1 时刻——已经有 promising results,但还没到 AlphaFold 2 那种"问题被基本解决"的程度。
虚拟细胞被他点名为下一个 grand challenge——但他给的时间线是 大约 10 年。瓶颈在数据:今天没有任何成像技术能在不杀死细胞的前提下、以纳米分辨率持续记录一个活细胞内部的动态过程。如果能做到,生物学的很多问题就被转化成了视觉问题——而视觉问题,frontier model 已经知道怎么做。DeepMind 这边目前的折中是先做"虚拟细胞核",因为细胞核相对自包含,边界清晰。
局限与未解:Einstein 测试没人通过,虚拟细胞还要 10 年
把哈萨比斯整场对话里他自己点明的"还做不到"集中起来,大致分成三类。
第一类是基础能力层的缺口。持续学习、长期推理、可靠记忆、跨场景一致性,这四项 frontier model(包括 Gemini、Claude、GPT 系列)目前都没解决。下棋时"明知是 blunder 还走回去"是哈萨比斯亲自演示的具体例子——这不是某一家模型的问题,而是当前 thinking 范式的共性短板。Einstein 测试目前没有任何系统能通过——他没有点名,但语气上等于把所有 frontier 系统都圈进了"还做不到"这一栏。 第二类是科学应用层的远期目标。虚拟细胞 10 年时间线,新材料、数学、医学的"AlphaFold 2 时刻"都还没到。哈萨比斯特别强调,数学领域他个人最希望被解决的是 P vs NP——但比解决 Millennium Prize 问题更高一阶的,是"提出一组新的、被顶级数学家认为值得用一生研究的 Millennium Prize 级别问题"。这一阶他认为系统目前完全做不到,但不认为是不可能的。
第三类是 Agent 产品层的现实落差。今天还没有出现一个完全由 AI 编码、登顶 App Store 的 AAA 游戏。哈萨比斯本人 17 岁手工写出 Theme Park,他承认今天用 frontier model 做出 Theme Park 原型只需要半小时——但那只是原型,"成品需要 craft、taste 和'灵魂'"。从原型到爆款的距离,目前由人类完成。1000x 工程师是真实的,但 1000x 自动化产品还不是——他预计这件事会在 6 到 12 个月内开始出现,但出现的形式是"人 + 工具",不是纯自动。
需要注意的是,这三类局限并不彼此独立。基础能力层的 introspection 与 continual learning 缺位,直接导致 Agent 产品层的不稳定;Einstein 测试通不过,意味着科学应用层只能在已有问题上找解,不能开辟新问题域。哈萨比斯在演讲后段把这件事和创业判断绑在了一起——如果你今天启动一个 deep tech 项目,整个旅程通常 10 年,那就意味着你必须假设 AGI 会在你这 10 年的中段出现,然后预先想清楚:Gemini、Claude 这一类通用系统会怎么使用你建出来的工具/数据/流程? 他自己的判断是,通用系统会把 specialized model(像 AlphaFold)当作 tool 调用,而不是把所有能力塞进同一个 brain——把蛋白结构知识硬塞进 Gemini 反而会让它的语言能力倒退。如果一个 deep tech 项目从设计上就考虑被 frontier model orchestrate,它的护城河会比纯 wrapper 厚得多。
最后一句评价句,可能是给所有还在场上的人最实在的一条建议——哈萨比斯说,做难的事和做容易的事,在难度上没差太多,只是难得不一样。生命这么短,既然花一样的力气,就花在真正有差别的事情上。这是他从 25 岁回头看到现在,最想告诉年轻自己的一句话。
 AI 速览