2026年2月,阿里巴巴通义实验室在arXiv发布论文并开源VimRAG——一个面向文本、图像和视频混合知识库的统一检索增强生成(RAG)框架。在Qwen3-VL-8B模型上,VimRAG端到端评测达到50.1%平均准确率,在文本、图文文档、视频三个类别上均超过ReAct和Mem1等基线方法(来源:论文实验数据,arXiv:2602.12735)。代码已在GitHub开源,采用MIT协议(来源:GitHub仓库 Alibaba-NLP/VRAG)。
多模态RAG的核心痛点:信息丢失与检索混乱
企业知识库早已不只是文字。PDF技术文档夹带图表,CAD设计图包含空间标注,操作培训视频中关键信息分散在特定时间段的对白里。当用户提出需要跨越多种模态才能回答的问题时,传统RAG方案面临两个结构性缺陷。
第一种是"降维转换"路线。将图片OCR为文字、视频打成字幕后统一检索,代价是版式、颜色、空间关系等视觉信息不可逆地丢失。一个实际的例子:用纯文字描述"红色紧急按钮在面板左下角,带3mm倒角阴影"不仅冗长,而且模型无法从文字描述中还原出精确的空间定位。VisRAG(OpenBMB,ICLR 2025)的实验已经证实,纯文本RAG管线在涉及视觉布局的任务上存在20%–40%的性能差距(来源:VisRAG论文,OpenReview)。
第二种是"分库检索"路线。分别建立文本库、图库、视频库,各自检索后拼接结果。问题在于跨模态引用关系断裂:文档中"参照图示"的指向消失了,视频里"按第3.2节规范操作"的引用也无法被关联。同为通义实验室此前发布的ViDoRAG(EMNLP 2025)已识别出这一问题,并在视觉文档场景下通过多Agent迭代推理取得了超过10%的性能提升(来源:ViDoRAG论文,arXiv:2502.18017),但ViDoRAG主要面向图文文档,尚未覆盖视频模态。
更深层的障碍是"状态盲区"。在迭代检索过程中,Agent需要在多个模态之间反复切换。传统方法以线性方式堆叠上下文历史,随着检索步骤增加,模型逐渐丧失对已查模态和推理路径的追踪能力,论文中将其称为"state blindness"——Agent忘了自己查过什么、各证据间如何印证、下一步该深挖视频还是回头查文本,最终陷入重复生成相似查询的死循环。
VimRAG的技术方案:三层机制解决三个问题
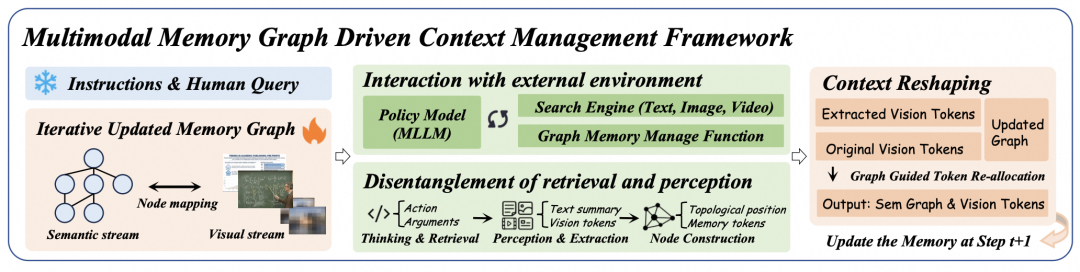
VimRAG的核心设计思路是将Agent的推理过程从线性历史记录升级为动态有向无环图(DAG),在此基础上叠加视觉Token的智能分配和基于图结构的训练优化。
动态记忆图(Multimodal Memory Graph)替代线性上下文。 每次检索生成一个新节点,封装文本摘要、视觉证据和拓扑位置信息。图从用户问题作为根节点开始生长,关键设计是分支试错机制:当某条检索路径被判定为无效时,自动标记为"死胡同"并剪枝;有效路径则被高亮为关键链路。这种树状拓扑使Agent能区分"探索性搜索"和"结论性验证",从根本上避免重复查询。
视觉能量分配(Graph-Modulated Visual Memory Encoding)控制Token消耗。 基于DAG的拓扑结构,框架对每个节点的视觉记忆进行差异化配额:核心节点和新鲜证据保留高分辨率视觉Token,边缘节点自动降级为文字描述或直接丢弃。论文将其类比为人类处理资料的方式——核心文件保留原稿,次要材料只看摘要。这一策略在保持理解完整性的前提下大幅降低了Token开销。
图引导策略优化(GGPO)解决训练信号稀疏问题。 传统强化学习对RAG Agent的训练通常以最终答案的对错作为奖惩信号,作用于整条推理轨迹,导致梯度方差大、训练不稳定。GGPO基于图的拓扑结构进行精细的贡献度回溯:在正样本中剪掉"对了但没贡献"的死胡同节点,在负样本中保护"检索动作有效但最终未答对"的节点。论文实验中的Entropy曲线显示,GGPO使策略收敛过程显著更稳定,梯度方差明显降低(来源:论文Figure b)。
竞品对比:VimRAG在多模态RAG生态中的定位
多模态RAG是2025–2026年学术界和工业界的热门赛道,主要竞争方案按技术路线可分为三类。
视觉文档RAG。 VisRAG(OpenBMB,ICLR 2025)用VLM直接对文档页面做图像嵌入,绕过OCR,在端到端性能上比纯文本RAG高出20%–40%(来源:VisRAG论文)。ColPali(Faysse等,2024)基于多向量后交互实现文档级视觉检索,在ViDoRe基准上表现领先。但这两者都聚焦于静态文档,不处理视频。
迭代推理RAG。 ViDoRAG(通义实验室,EMNLP 2025)引入多Agent的"探索-总结-反思"迭代工作流和GMM混合检索策略,在ViDoSeek基准上超过已有方法10%以上(来源:ViDoRAG论文)。ViDoRAG是VimRAG的前序工作,VimRAG在其基础上新增了视频模态支持和记忆图结构。
端到端强化学习RAG。 VRAG-RL(同为通义实验室,2025)将GRPO策略应用于VLM的RAG训练(来源:UniDoc-Bench论文引用)。VimRAG在VRAG-RL的强化学习基础上进一步引入图引导优化,实现更精细的贡献度评估。
VimRAG与上述方案的关键差异在于:它是目前少数同时覆盖文本、图像和视频三种模态的统一框架,并且用图结构替代线性上下文来管理跨模态推理状态。但需要注意,论文实验基于Qwen3-VL-8B这一相对小参数模型,在更大规模模型上的表现尚未验证。
实验设置与关键数据
论文采用了一个刻意严苛的评测方案:没有为每个Benchmark单独建库,而是将文本、多模态文档、图片和视频全部混入一个统一的多模态语料库,模型需要在这个"混合垃圾堆"中完成精准检索。
核心数据点(来源:论文Table及Figure,arXiv:2602.12735):
VimRAG在Qwen3-VL-8B上的端到端平均准确率为50.1%,在General Text、Image & VisDoc、Videos三个子类上均超过Mem1和ReAct基线。论文展示的Entropy曲线表明,GGPO的训练过程在探索到可解分布后快速下降并趋于稳定,而对照方法的Entropy持续波动。在时延方面,尽管VimRAG引入了额外的记忆管理动作,但因减少了无效检索轮次,整体推理时延反而优于基线。
落地路径与使用方式
VimRAG的代码已开源在GitHub(Alibaba-NLP/VRAG),基于LlamaIndex构建检索引擎,依赖Qwen系列VLM作为生成模型。安装后通过vrag_agent.py即可运行Demo,也可以集成到自有框架中。训练代码基于LLaMA-Factory和verl实现,Qwen2.5-VL版本的RL训练代码已释出,Qwen3-VL版本的训练代码公告"即将发布"(来源:GitHub README,截至撰稿时状态)。
通义实验室提到,VimRAG的核心机制"正逐步集成"到阿里云百炼知识库产品中,后者已支持文本、表格、图片、音视频的多模态检索生成。但百炼产品中实际集成了VimRAG的哪些组件、性能表现是否与论文一致,目前没有公开的第三方验证数据。
 AI 速览